Pavan Kumar Sharmaa、Ayush Pandeb、Pranamesh Chakrabortya,∗
a 印度理工学院坎普尔分校 土木工程系(IIT Kanpur)
b 印度理工学院坎普尔分校 计算机科学与工程系
∗ 通讯作者:pavans20@iitk.ac.in;ayushp@cse.iitk.ac.in;pranames@iitk.ac.in
摘要:驾驶员注视提供了关于驾驶员视觉注意力与对周边交通态势感知(situational awareness)的信息。现有驾驶员注视估计研究把注视表示为注视区域(gaze zone)或注视向量 / 注视点(point of gaze,PoG)。然而,物体级的注视信息通过识别被注视的物体(如车辆、行人或交通信号灯),能提供语义上更有意义的视觉注意力表示。本研究提出一个端到端的驾驶员注视目标预测框架 TransGaze-Object(基于 Transformer 的注视目标预测模型)。该框架首先提取面部特征(包括面部特征与虹膜加权的眼部特征)以及交通目标的空间特征,然后用基于 Transformer 的交叉注意力机制计算相似度得分与注意力权重,从而预测驾驶员的注视目标。为训练该模型,我们提出了一个基准驾驶员注视数据集——城市驾驶面部-场景注视数据集(Urban Driving-Face Scene Gaze,UD-FSG),包含同步采集的驾驶员面部与交通场景图像、场景目标边界框,以及以 2D 注视坐标和注视目标两种形式给出的注视标签。TransGaze-Object 模型在注视目标预测上取得 60% 的总体准确率,而把估计的注视点关联到交通目标的方法仅取得 51% 的准确率。误差分析表明,TransGaze-Object 减少了「预测为交通目标、真值为背景」的混淆,错误率为 11.68%,相较基于 PoG 的注视目标关联方法得到的 23.21% 错误率,相对下降 49.7%。总体而言,结果证明了直接从驾驶员面部与交通场景信息预测注视目标的有效性,优于先估计中间量注视点、再将其与交通目标关联的做法。
关键词:驾驶员注视估计、驾驶员视觉注意力、Transformer、注视目标预测
几十年来,道路交通事故每年造成大量伤亡,驾驶员安全一直是全球关注的重大问题。根据世界卫生组织《2023 年全球道路安全现状报告》(World Health Organization, 2023),2023 年约 119 万人死于道路交通事故。这些事故成因多样,可大致分为四大类:人为因素、车辆缺陷、道路状况和环境因素。其中,人为因素被认为是道路事故的主要原因。与人为因素(尤其是驾驶员相关因素)相关的事故,可能源于疲劳、分心驾驶、驾驶员认知状态变化、视觉注意力和态势感知的波动(Lal & Craig, 2001; Regan et al., 2008; Dingus et al., 2016; Louw & Merat, 2017; Li et al., 2019, 2023)。这些因素会削弱驾驶员感知并恰当响应驾驶环境变化的能力,可能增加事故风险。然而,直接测量其中一些与人相关的因素(如视觉注意力和态势感知)是困难的。在这个背景下,驾驶员的注视作为视觉注意力与态势感知的替代测量手段发挥着重要作用。除此之外,驾驶员注视还用于若干其他重要应用,包括驾驶员监测系统(DMS)和高级驾驶辅助系统(ADAS)的开发。
驾驶员注视估计是指确定驾驶员在驾驶过程中看向何处的过程。通常,注视估计模型的输出可以用注视区域、注视向量 / 注视点(PoG)或注视目标(gaze object)来表示(Sharma & Chakraborty, 2024b)。基于注视区域的表示把风挡及周围区域(如侧视镜、车内后视镜、中控台等)划分为不同区域,驾驶员注视区域分类即估计驾驶员看向哪个区域(Fridman et al., 2016a; Martin et al., 2018; Ghosh et al., 2021; Wu et al., 2025; Yahyaabadi & Nikan, 2026)。注视区域表示本身不包含交通场景信息。而基于注视点的表示则是估计驾驶员在风挡上(Vicente et al., 2015; Yuan et al., 2022; Cheng et al., 2024)或交通场景图像上所看的对应点(Kasahara et al., 2022; Hu et al., 2025; Zhou et al., 2025)。然而,仅有注视点并不能提供驾驶员对场景中目标(车辆、行人等)注意力的信息。因此,需要对注视点信息做后处理,才能确定驾驶员正在看哪个交通目标(若存在)。与此相对,驾驶员注视目标表示则是直接确定驾驶员正在看的注视目标。
现有的驾驶员注视估计研究大多基于注视区域分类或注视点估计(Chuang et al., 2014; Tawari et al., 2014; Fridman et al., 2016b; Vora et al., 2018; Yang et al., 2019; Yuan et al., 2022; Kasahara et al., 2022; Wu et al., 2025; Li et al., 2026)。据作者所知,目前尚无针对驾驶员注视目标预测的研究。我们认为,把场景中目标的信息(先验地)与驾驶员面部信息一起提供给模型,把注视估计问题转化为端到端的注视目标预测问题,与「先估计注视点、再后处理得到注视目标信息」相比,有助于改善估计结果。因此,本研究把驾驶员注视估计提出为一个端到端的驾驶员注视目标预测框架,其输入为驾驶员面部和交通目标(车辆、行人、交通标志等),并预测驾驶员在给定的目标(或背景)中正注视哪一个。
驾驶员注视目标预测需要融合两种不同模态的信息:(i) 驾驶员面部信息,可由朝向驾驶员的相机拍摄的面部图像中提取;(ii) 交通目标信息,可由朝向道路的相机捕获。本研究提出用交叉注意力机制(Vaswani et al., 2017)融合这两类信息。这里,驾驶员的面部特征可作为查询(query)向量,交通目标特征(目标边界框在场景中的尺寸和位置)作为键(key)向量。驾驶员面部与交通目标的这种「查询-键」表示,以及用交叉注意力机制进行的融合,有助于理解面部特征与交通目标之间的关系,从而确定驾驶员在场景中注视的目标(或背景)。
训练驾驶员注视目标预测模型需要一个包含同步的驾驶员面部图像与交通场景图像的数据集。然而,现有的驾驶员注视数据集通常只包含驾驶员面部图像(Ribeiro & Costa, 2019; Rangesh et al., 2020; Dua et al., 2020; Ghosh et al., 2021; Sharma & Chakraborty, 2025)。这是因为现有研究的输出是注视区域或注视向量(PoG 的另一种表示),不需要交通场景信息。目前,据我们所知,只有一个开源基准驾驶员注视数据集同时包含驾驶员面部与交通场景图像,即 Look Both Ways(LBW)(Kasahara et al., 2022)。但 LBW 数据集主要在低密度交通环境下采集,场景中交通目标数量很少(平均每张图像约 4 个目标)。因此,本研究构建了一个驾驶员注视数据集,包含同步的驾驶员面部与场景图像对、场景交通目标边界框坐标,以及以 2D 注视坐标和对应注视目标信息表达的注视标签。数据在高密度、异构的城市交通条件下采集,这使得注视目标预测问题因场景中潜在注视目标(即交通目标)数量更多而更具挑战性。
本研究的主要贡献如下:
(i) 我们把驾驶员注视估计形式化为一个端到端的注视目标预测问题:直接以驾驶员面部图像和交通场景目标信息为输入,预测驾驶员注视的目标。
(ii) 我们提出了一种新的基于 Transformer 架构的注视目标预测模型(TransGaze-Object),其中面部输入特征通过交叉注意力机制与交通目标信息整合。
(iii) 我们构建了一个名为 UD-FSG 的数据集,在真实世界城市场景中采集,包含同步的驾驶员面部与场景图像对、场景交通目标边界框坐标,以及以 2D 注视坐标和对应注视目标信息表达的注视标签。
本文其余部分组织如下:第 2 节详细综述驾驶员注视估计,重点是注视点与注视向量方向的最新进展,包括基于 Transformer 的架构。第 3 节介绍数据集,包括传感器装置、数据采集、真值创建与一个基于注视目标的基准数据集。第 4 节给出所提方法,包括面部与场景目标检测及特征提取、特征融合与用于预测注视目标的注意力权重计算。第 5 节给出实验结果,包括训练性能、模型评估、所提模型与基于注视点的目标关联方法的对比,以及对预测与真值注视目标的误差分析,以找出注视目标预测错误的可能原因。最后,我们总结关键发现、所提模型的优势与局限,以及研究的未来方向。
按所用设备划分,驾驶员注视估计分为侵入式与非侵入式两类。侵入式方法中,驾驶员佩戴头戴式设备,即眼动仪。非侵入式方法则依靠安装在车辆仪表盘和 / 或风挡上的相机捕捉驾驶员面部(Ortega et al., 2020; Ghosh et al., 2021; Sharma & Chakraborty, 2025)。由于在真实、实用的驾驶员监测系统中,需要持续监测驾驶员注视以辅助并保障驾驶员安全,非侵入式方法更为合适。本节仅综述基于非侵入式方法的注视估计研究。
车内环境下的注视估计传统上把驾驶员注视表示为驾驶员所看方向对应的预定义注视区域。已有若干研究采用这种基于区域的注视估计方法(Fridman et al., 2016a; Martin et al., 2018; Yang et al., 2019, 2021; Shah et al., 2022; Sharma & Chakraborty, 2024a; Yahyaabadi & Nikan, 2026; Wang et al., 2026)。然而,基于区域的注视估计方法的主要局限是:它不提供驾驶员所关注的场景内目标的信息,且主要局限于车辆内部的预定义区域,如侧视镜、风挡区域和车内后视镜。
因此,近年来若干研究转向基于场景的注视表示,把驾驶员注视直接映射到场景图像上。这些方法通常把注视表示为注视向量 / 注视方向(LRD et al., 2022; Kasahara et al., 2022; Yang et al., 2019)、注视点,或显著性图(saliency map)(Kasahara et al., 2022; Wu et al., 2025),显著性图指示场景中吸引驾驶员注意的区域。基于注视向量或注视方向的注视表示使用概率模型和深度学习模型,如 CNN(Wu et al., 2025)与基于 Transformer 的方法(Hu et al., 2025)。一些近期研究使用基于 Transformer 的注视回归器,利用面部与眼部特征以及头部运动(偏航 yaw、俯仰 pitch、翻滚 roll)来估计注视向量。另一些研究则用视觉显著性图把注视方向映射到驾驶员场景图像上(Hu et al., 2021; Kasahara et al., 2022)。Kasahara 等(2022)开发了一种基于自监督的驾驶员注视估计算法,模型以驾驶员面部图像为输入,输出 3D 注视方向与场景显著性。该研究使用基于 ResNet-50 的 ETH-XGaze 模型做注视估计,使用 Unisal(MNet V2-RNN-Decoder)做显著性估计。Hu 等(2021)利用 SalGAN 对抗框架估计显著性图,并加入逐元素 sigmoid 把每个像素解释为概率;其架构结合了瓶颈、多分辨率与过渡模块,实现下采样与上采样,以全局上下文丰富高分辨率特征。虽然该设计强化了双视角注视与场景表示的特征融合,但该研究依赖驾驶模拟器,限制了其适用性;真实世界环境条件与面部特征的多样性未被解决,降低了系统的泛化能力。
在以注视目标表示注视的研究中,一些基于仿真器的研究把驾驶员注视回归到场景上(注视点),再检查该注视点是否落在某个目标的边界框内(Dua et al., 2020; Deng et al., 2026)。在实验室环境中,Dua 等(2020)基于 DGAZE 数据集开发了一个模型,从真实驾驶录制的投影视频预测驾驶员注视;把注视点投影到视频后,检查预测注视点是否落在某目标的边界框内,若在,则输出对应的目标类别。类似地,Deng 等(2026)研究了基于注视的语义目标识别,即确定道路场景中给定注视点对应的交通目标。该研究没有采集真实驾驶员注视数据,而是使用 BDD100K 图像并在目标上手动放置点来模拟注视坐标,然后把这些坐标提供给 YOLOv13、基于 SAM2 的方法和 Qwen2.5-VL 模型来识别注视目标。
在非驾驶注视应用中,基于 Transformer 的注视估计模型近年来日益流行,尤其是注视目标预测方向,因为它们能有效建模驾驶员注视相关特征与场景中多个目标或区域之间的关系。与传统注视点估计不同,这类模型可以预测人正在看哪个具体物体,提供语义上更有意义的视觉注意力表示。本节综述若干流行的基于注视目标预测的非驾驶应用研究。Cheng 与 Lu(2022)提出了使用纯 Transformer 的注视估计模型(GazeTR-Pure)和混合 Transformer 模型(GazeTR-Hybrid)。GazeTR-Pure 仅用 Transformer 架构做面部特征提取与注视回归;而 GazeTR-Hybrid 用 CNN 提取特征,用 Transformer 编码器块回归注视。Li 等(2025)提出了一种带可编程梯度信息的非线性多头交叉注意力网络,以注视向量的形式做注视估计。第一个可编程梯度信息特征提取模块用于从面部图像提取多尺度注视相关特征,由三个块组成:第一个捕捉大尺度面部轮廓与粗糙纹理,第二个提取中尺度局部与形态特征,第三个(FC)编码全局视觉细节、精细纹理和微表情。Li 等(2026)提出了一个面向机车司机注视目标估计的几何引导多模态框架,融合 RGB 场景特征、司机头部位置和单目深度信息来建模注视起点与场景结构之间的空间关系;该框架使用 SimDINOv2 做视觉特征提取,多模态几何引导与跨模态门控融合生成 2D 注视热图,最大响应即预测注视点。
与此同时,Transformer 框架也被用于注视-目标交互研究(Nieva-Suárez et al., 2025; Li et al., 2026; Mathew et al., 2026)。Tonini 等(2023)提出了一种使用端到端 Gaze Transformer 的面向目标的注视目标检测方法。模型有三个主要组件:(a) 目标检测 Transformer,检测包括头部在内的所有目标;(b) 注视锥预测器,为每个检测到的头部生成注视向量与对应视锥;(c) 注视-目标 Transformer(GOT),建模注视视锥与检测目标之间的关系。类似地,在零售场景中,Wang 等(2024)提出了 TransGOP,一个用于预测注视-目标交互的 Transformer 框架,由两个互补组件构成:目标检测分支和注视回归分支。目标检测器处理完整场景图像,用基于 Transformer 的检测骨干网络定位并分类目标;注视回归器则同时以头部图像和场景图像为输入生成注视热图。
综上,注视目标预测研究仍然有限,仅有少数研究(Dua et al., 2020; Deng et al., 2026)探索过该问题,且主要在仿真或受控环境中。这些研究通常假设注视点已知,再把既定注视点映射到场景图像中的目标上;因此它们主要执行「注视点-目标」关联,而非从视觉线索显式预测注视目标。而且,它们对仿真或受控实验室环境的依赖限制了其向真实驾驶环境的适用性。据我们所知,目前尚无使用真实驾驶数据、显式利用交通目标信息构建注视目标预测模型的研究。为弥补这些不足,本研究提出一个基于 Transformer 的框架,在真实驾驶环境中联合利用驾驶员面部线索与交通目标信息,直接预测驾驶员的注视目标。
基于深度学习的注视估计模型,尤其是依赖卷积神经网络(CNN)和视觉 Transformer 的模型,需要大规模、多样化的数据集才能在驾驶员注视估计任务上取得稳健性能。训练数据理想情况下应在真实驾驶环境中采集,天然包含墨镜反光、阳光下的面部眩光、低光照下照明不足等实际挑战。这些因素在模拟驾驶环境中采集数据时通常缺失或代表性不足。本研究构建了一个真实驾驶注视数据集,包含驾驶员面部-场景图像对、场景图像中检测目标的边界框、注视目标标签,以及相对前视场景图像的 2D 注视点。LBW 是现有的类似基准数据集,但其交通密度明显偏低,且交通目标以汽车和卡车为主。我们的 UD-FSG 数据集在高密度城市驾驶环境中采集,交通构成异构,使注视目标预测更具挑战性。本节介绍 UD-FSG 数据集,包括传感器装置与同步、驾驶员特征、数据采集流程和数据集构成。
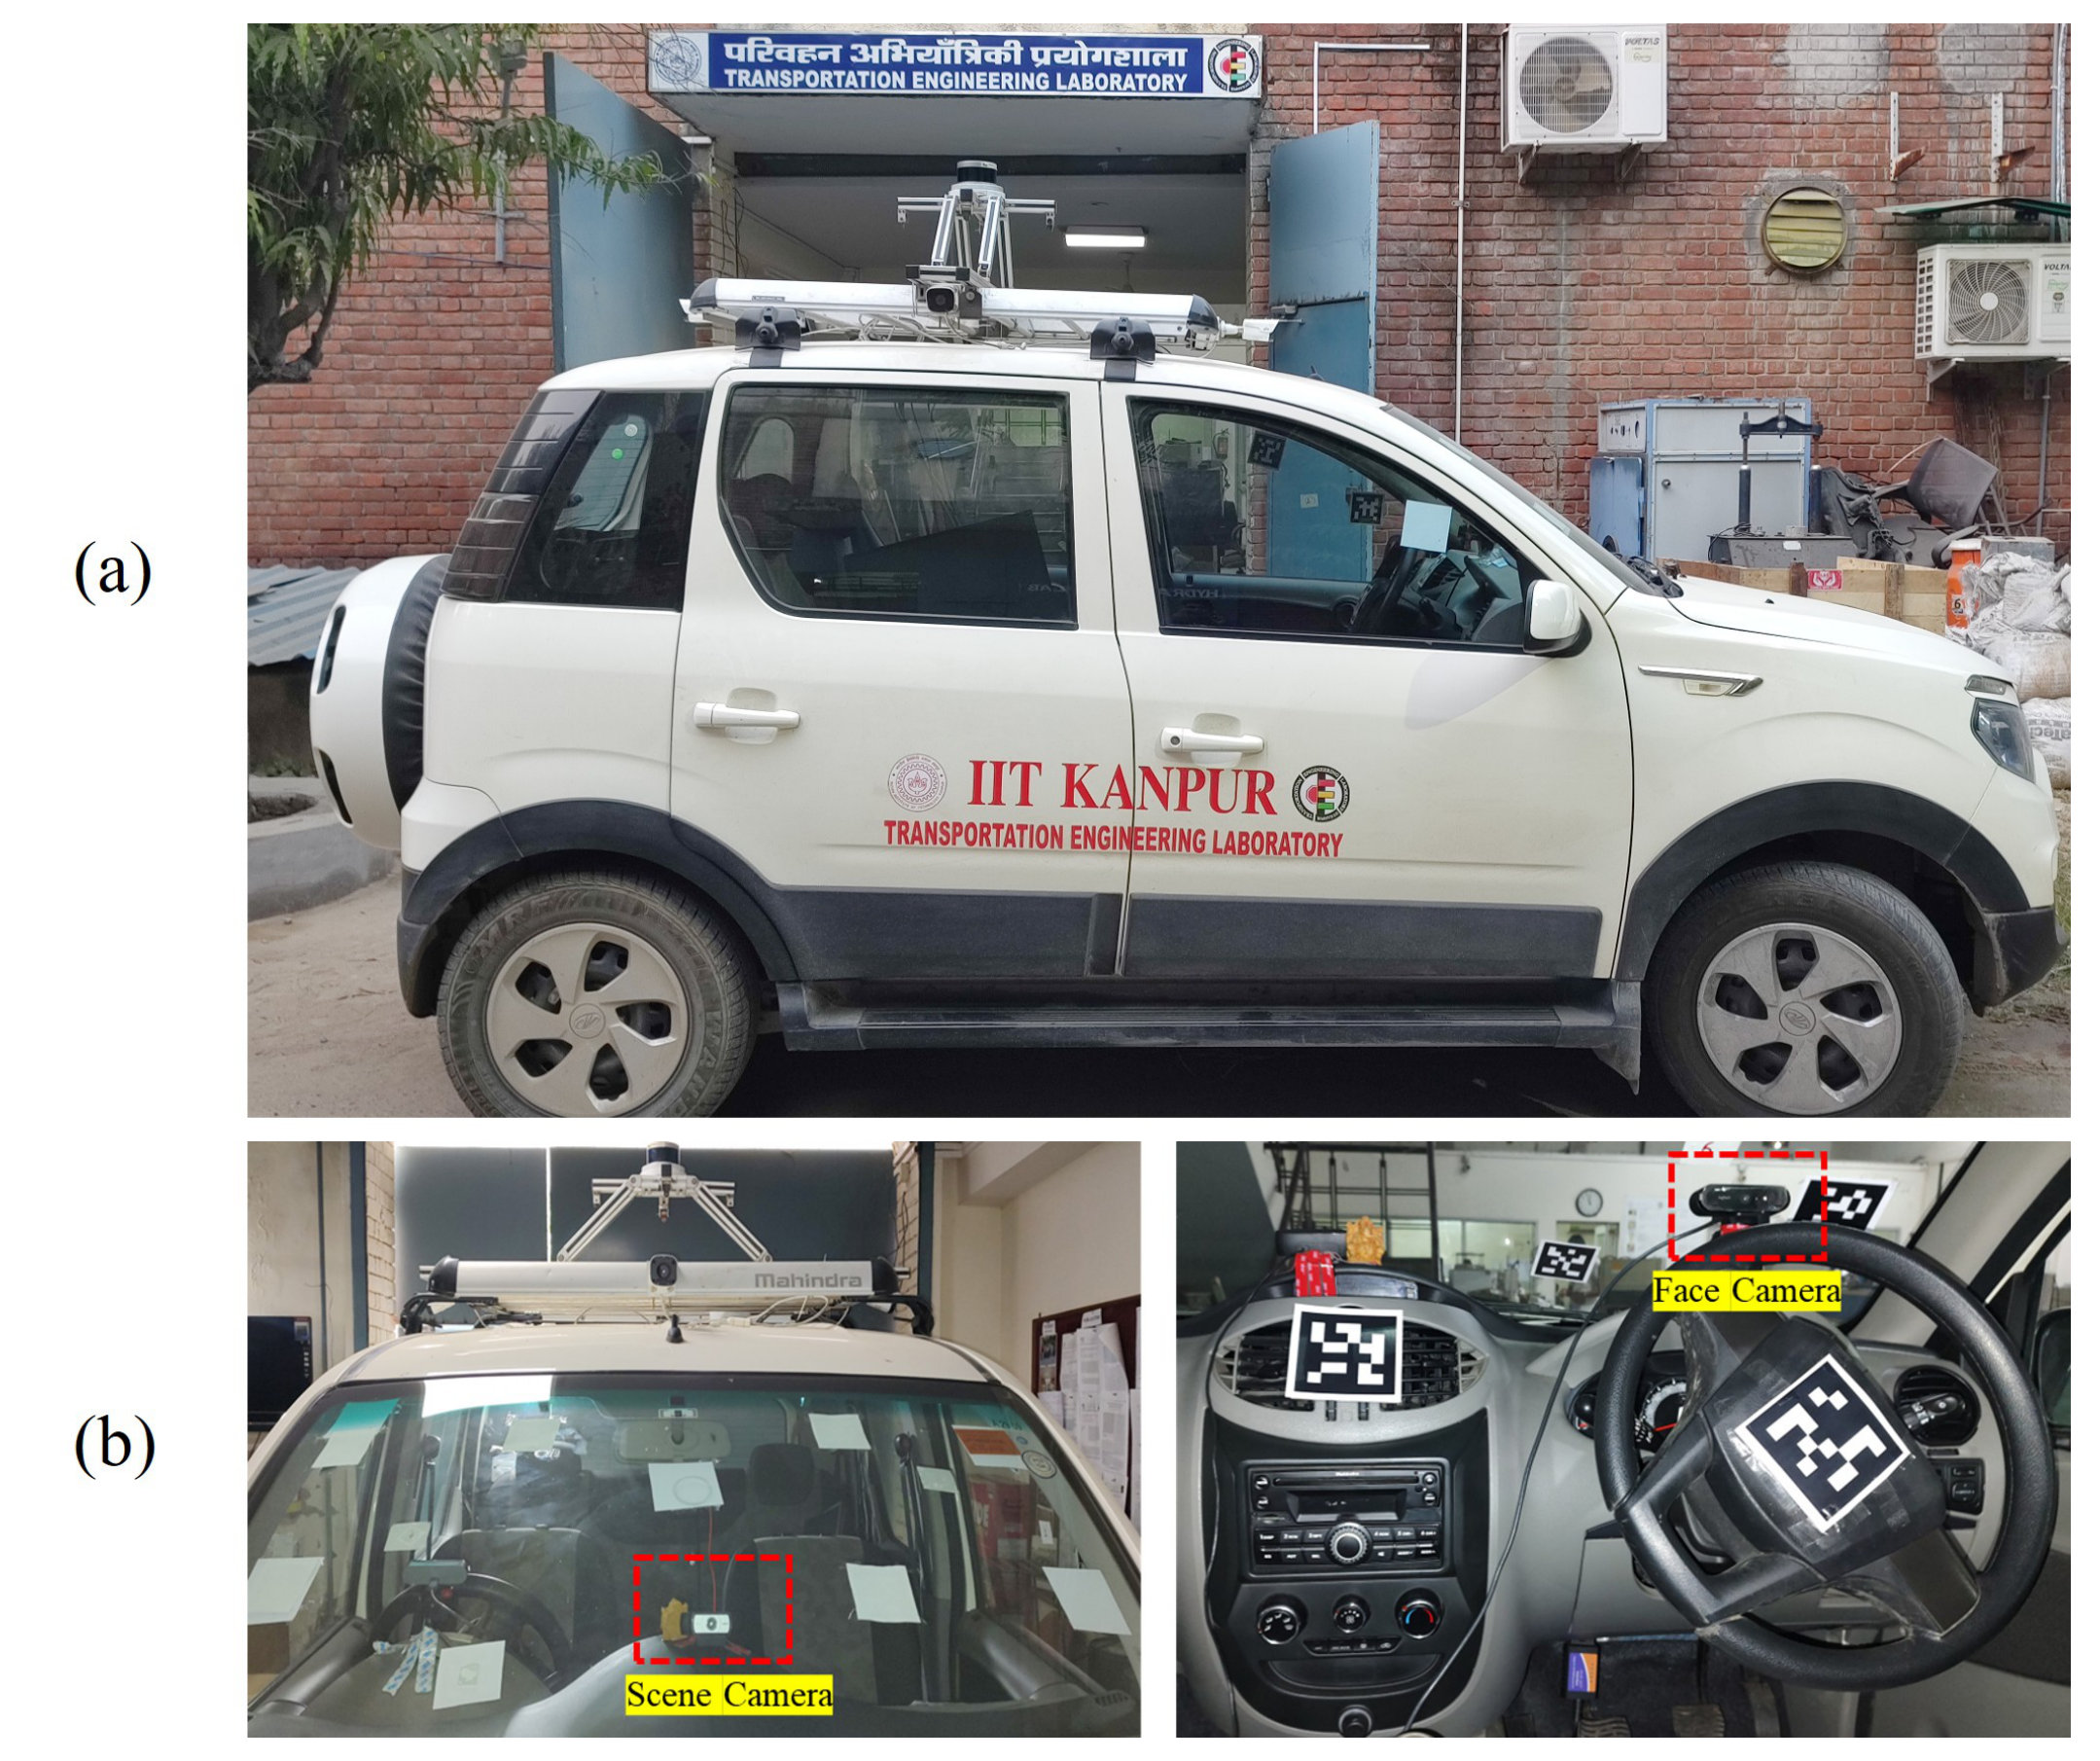
本研究用于数据采集的车辆是一辆 Instrumented Vehicle(综合试验车,IV),如图 1a 所示。试验车是一辆 SUV,装备多种传感器:LiDAR(激光雷达)、相机、OBD(车载诊断)、GPS(全球定位系统)、IMU(惯性测量单元)和眼动仪。LiDAR 用于测量周围车辆和行人相对于试验车的距离与相对速度;相机录制周边交通环境和驾驶员面部的视频;OBD 记录车速、加速度等车辆运动学量;GPS 和 IMU 分别提供车辆位置、运动和姿态。眼动仪用于以相对眼动仪场景相机的 2D 注视坐标捕获驾驶员注视信息,再把 2D 注视坐标变换到仪表盘前视场景相机坐标系。虽然所有传感器都采集了数据,但本研究只使用面部相机、前视场景相机(图 1b)和 Pupil Invisible 眼动仪(Tonsen et al., 2020)。面部相机记录驾驶员面部外观,场景相机捕捉前视视野,眼动仪为模型开发与评估提供真值注视坐标。所有相机用 GStreamer 应用同步;相机与眼动仪之间用参照秒表的 timestamps 同步。
数据由职业驾驶员在坎普尔(Kanpur)市的真实驾驶条件下采集。研究开始前获得了研究所伦理委员会的许可;数据采集前每位驾驶员签署书面知情同意书。共招募了 41 名男性职业驾驶员;由于一块数据存储设备故障,6 名参与者的数据丢失无法纳入分析,最终数据集包含 35 名参与者的数据。参与者平均年龄 35.77 岁(标准差 SD = 6.30,范围 25–51 岁),平均驾龄 13.70 年(SD = 5.85,范围 3–30 年)。可以指出,数据采集地区职业女性驾驶员的比例极低(Tayal & Mishra, 2025)。
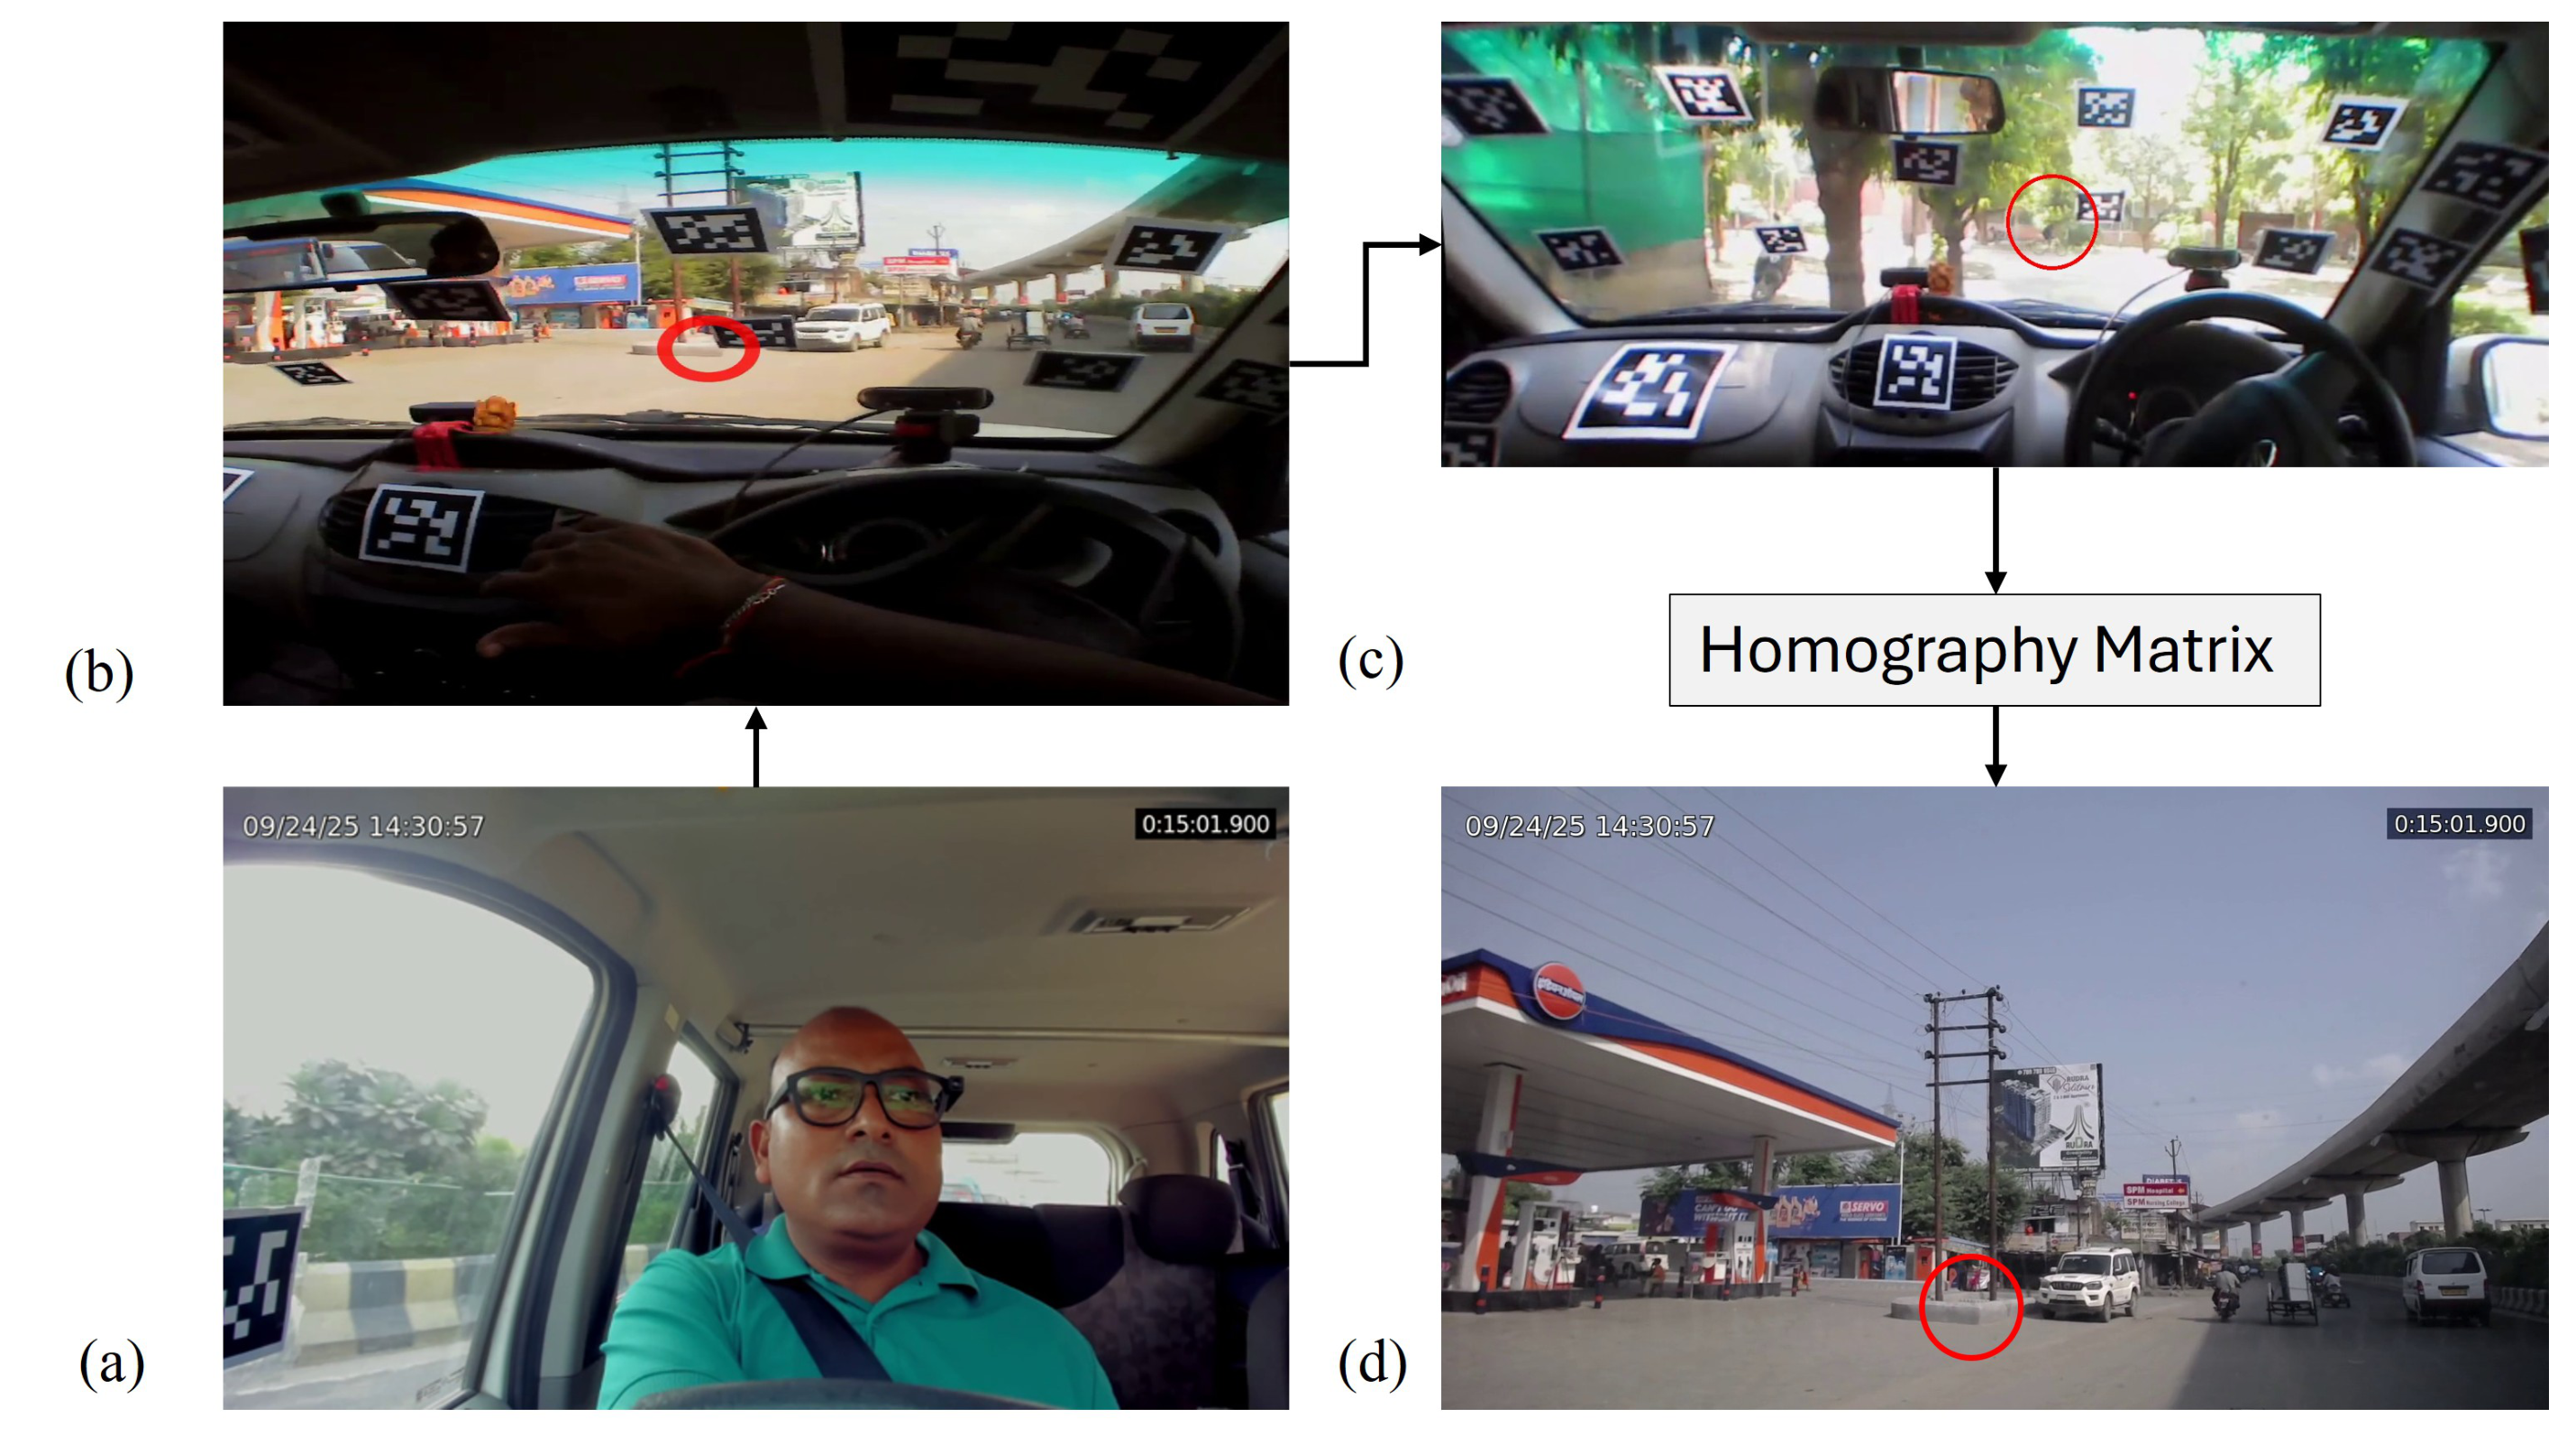
数据在坎普尔市城市真实驾驶环境中采集,涵盖主干道与次干道,并在一天中的不同时段进行,以兼顾交通密度和光照条件对驾驶员面部的影响。每位驾驶员驾驶约 1 小时,行驶距离约 30–35 km。驾驶员面部与场景视频原始录制帧率为 10 fps,以 5 fps 抽帧构建数据集。从面部与场景视频抽取的帧包括驾驶员面部图像和前视场景图像;面部-场景图像对对应的驾驶员注视坐标(相对眼动仪场景的 2D 注视点)取自眼动仪。由于眼动仪场景相机固定在驾驶员佩戴的眼动仪框架上,当驾驶员转动头部查看侧翼后视镜、车内后视镜等时,其位置与姿态持续变化。因此,眼动仪输出的注视坐标表达在一个移动的相机坐标系中,如图 2a 所示。
为了在一致的参考坐标系中获得注视坐标,需把注视坐标从眼动仪场景相机坐标系变换到固定的仪表盘场景相机坐标系,如图 2b 所示。这一变换保证所有注视坐标都相对一个固定相机表示,从而支持跨驾驶员、跨驾驶时段的一致分析。把 2D 注视坐标从眼动仪场景相机变换到仪表盘场景相机的流程如下:
1. 在试验车风挡和侧窗上粘贴视觉标记(AprilTag),如图 2c 所示。这些 AprilTag 的位置在整个数据采集过程中保持固定,为注视变换提供一致的参考系。
2. 每次驾驶会话开始前,用眼动仪扫描试验车风挡区域。后处理时,从眼动仪场景相机录制的风挡前视区域视频中选取一帧参考帧。参考图像包含贴在车风挡上的多个 AprilTag。把参考图像上传到 Pupil Cloud(Pupil Labs 的眼动仪注视数据分析云数据库)可视化工具包,该工具包把眼动仪记录的 2D 注视坐标(相对场景相机)从眼动仪场景相机坐标系变换到固定的参考图像,如图 2(b) 所示。
3. 在如图 2c 所示的固定参考图像中得到注视坐标后,再用式 (1) 定义的单应变换把这些坐标进一步变换到仪表盘前视场景相机坐标系。为计算单应矩阵,为每位参与者选取约 10–12 对图像,每对由眼动仪固定参考图像与仪表盘前视场景相机图像组成,且每对中的注视点已知。请注意,参考图像中的注视坐标来自上述 Pupil Cloud(Pupil Labs)眼动仪工具包可视化。在对应的前视场景图像中,用照片多工具应用在与眼动仪图像中场景完全一致的位置、以注视坐标为圆心画一个圆。前视场景相机图像中标定的注视点按图像尺寸归一化:xf = x′f/Wf,yf = y′f/Hf,其中 x′f、y′f 为注视点像素坐标,Wf、Hf 为前视相机图像的宽与高。用对应的眼动仪固定参考图像和归一化的前视场景相机图像坐标,通过基于 RANSAC(Fischler & Bolles, 1981)的单应估计求出 3×3 单应矩阵 H。
对眼动仪注视坐标 (xe, ye),仪表盘前视场景相机图像中对应的归一化注视位置由下式得到:
其中 H 表示从眼动仪坐标系到前视场景相机坐标系的变换;w 是齐次缩放因子,用于把变换后的坐标从齐次坐标转换为笛卡尔坐标,变换后的坐标通过前两个分量除以 w 得到:
最后,把归一化坐标转换为前视相机图像的像素坐标:
这样,标定后的单应变换把眼动仪注视位置映射到前视场景图像中对应的像素位置 (Xf, Yf),随后用于确定驾驶员注视的交通目标。请注意,注视坐标变换完成后还做了人工检查,确保变换后的注视坐标与眼动仪图像中的位置一致。
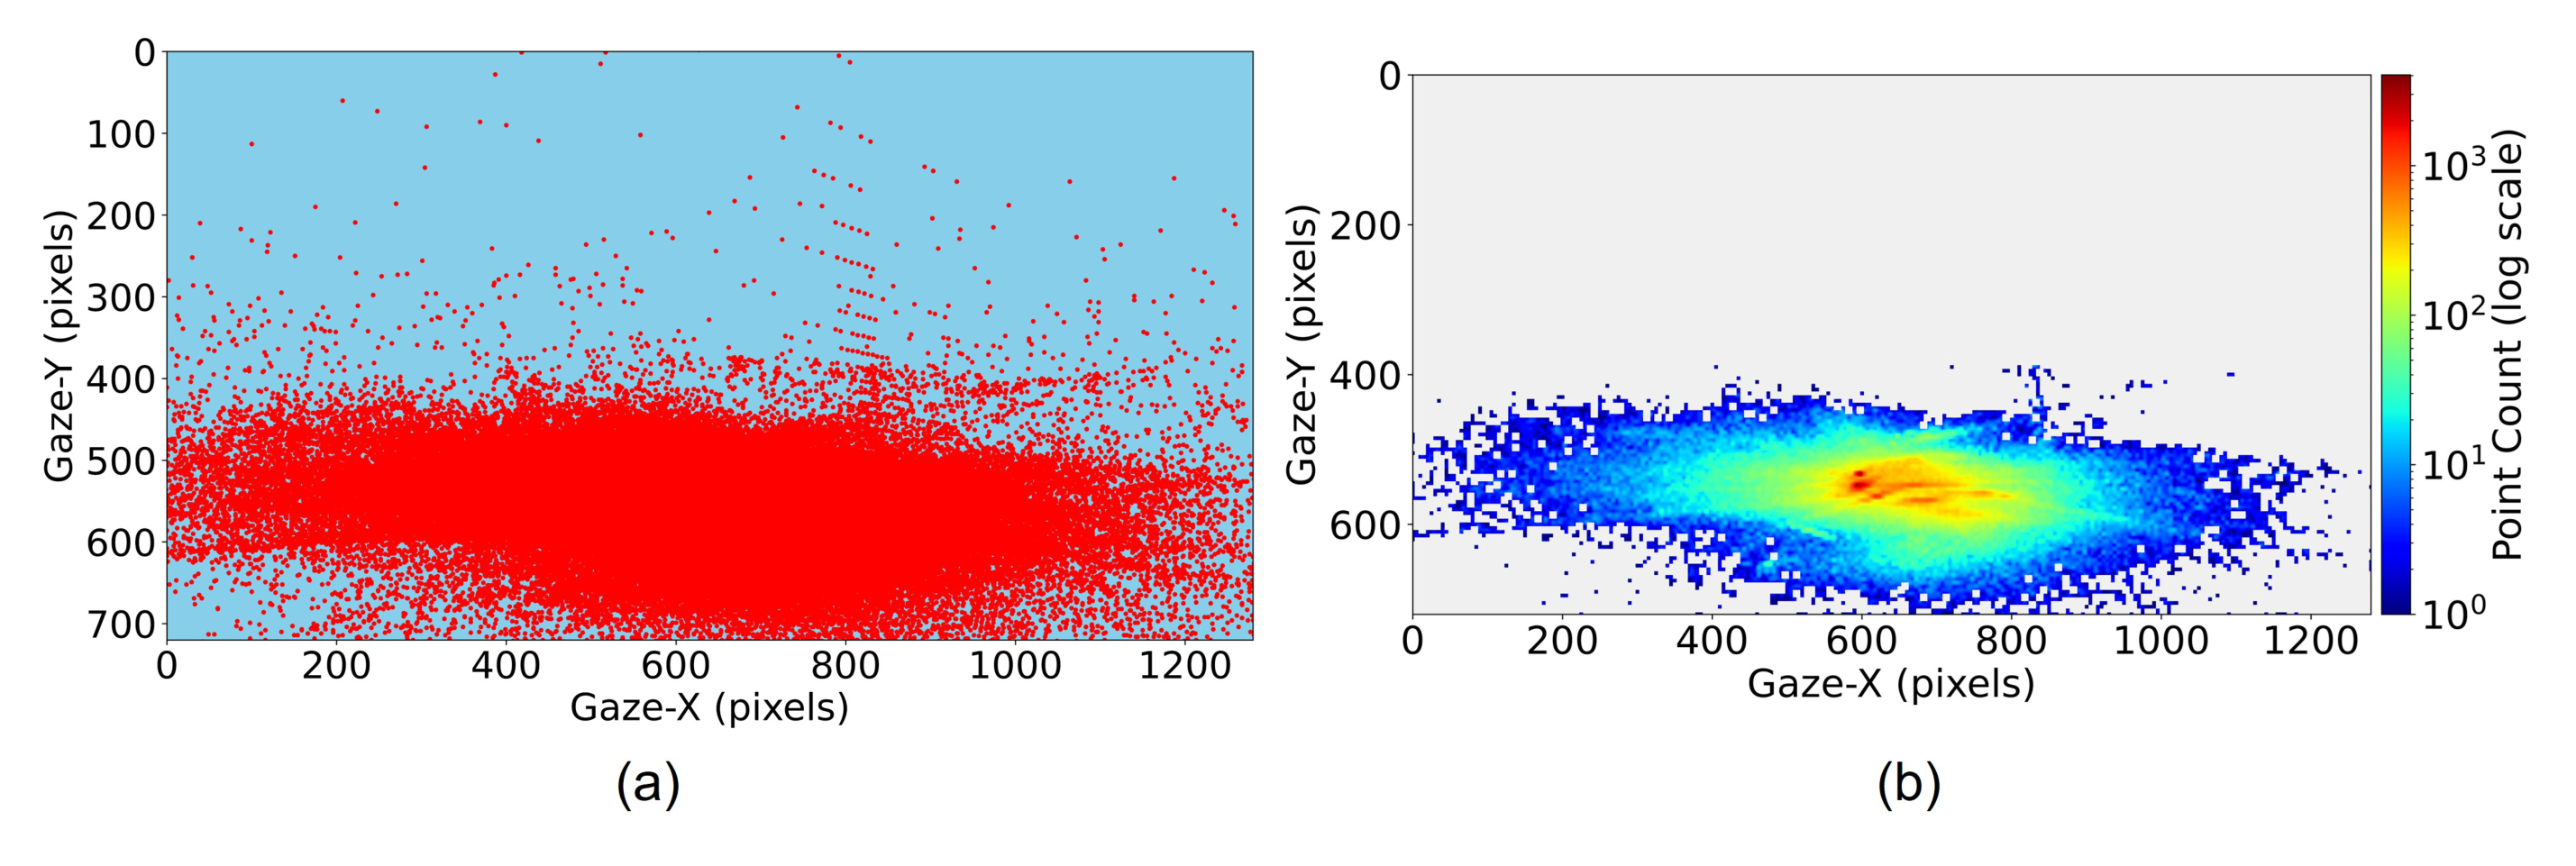
以场景图像尺寸(1280 × 720)为画布,图 3a 绘制了驾驶员注视点在场景中的分布。为理解注视点在场景中的散布情况,还把注视点按 5 × 5 像素区域聚合绘制了注视密度热图。图 3b 显示驾驶员注视集中在场景中部区域(驾驶员正前方场景),这符合预期,因为驾驶时驾驶员主要看前方。不过,数据集中也包含注视分布在场景相机横向边缘(x < 200 或 x > 1000 像素)的图像,使其适合建模驾驶员朝风挡角落的注视。UD-FSG 数据集发布于:https://github.com/pavans20/Urban-Driving-Face-Scene-Gaze-Dataset.git。
通过注视目标预测做注视估计,首先需要检测交通场景中的目标。为此,我们训练了一个基于 YOLOv8(You Only Look Once version 8)的交通目标检测器,细节见第 4 节。把训练好的模型应用于场景图像,检测目标边界框并统计每个场景中的目标数量。训练注视目标预测模型需要驾驶员面部图像、场景图像以及对应的真值注视目标。真值注视目标可以是场景图像中检测到的交通目标,也可以是背景。由于眼动仪提供的是眼动仪场景相机图像中的注视坐标(再被变换到仪表盘场景相机图像,如上所述),眼动仪并不直接提供注视目标真值。因此,为创建注视目标真值,把驾驶员注视坐标映射到场景图像中检测到的交通目标上:若映射到场景图像上的注视点落在某检测目标的边界框内、或距最近目标边界不超过 10 像素,则该目标被指定为真值注视目标;否则真值为背景。对每张场景图像,我们都有真值注视目标的索引 ID 与该目标边界框坐标信息。请注意,背景指场景图像中未检测到任何目标边界框的区域。
从所有驾驶员的面部与场景相机视频按 5 FPS 抽取的面部-场景帧对共 373,488 对。其中 141,884 对(37.98%)对应驾驶员注视落在检测到的交通目标上的情形;其余帧对应驾驶员注视指向背景而非交通目标的情形。
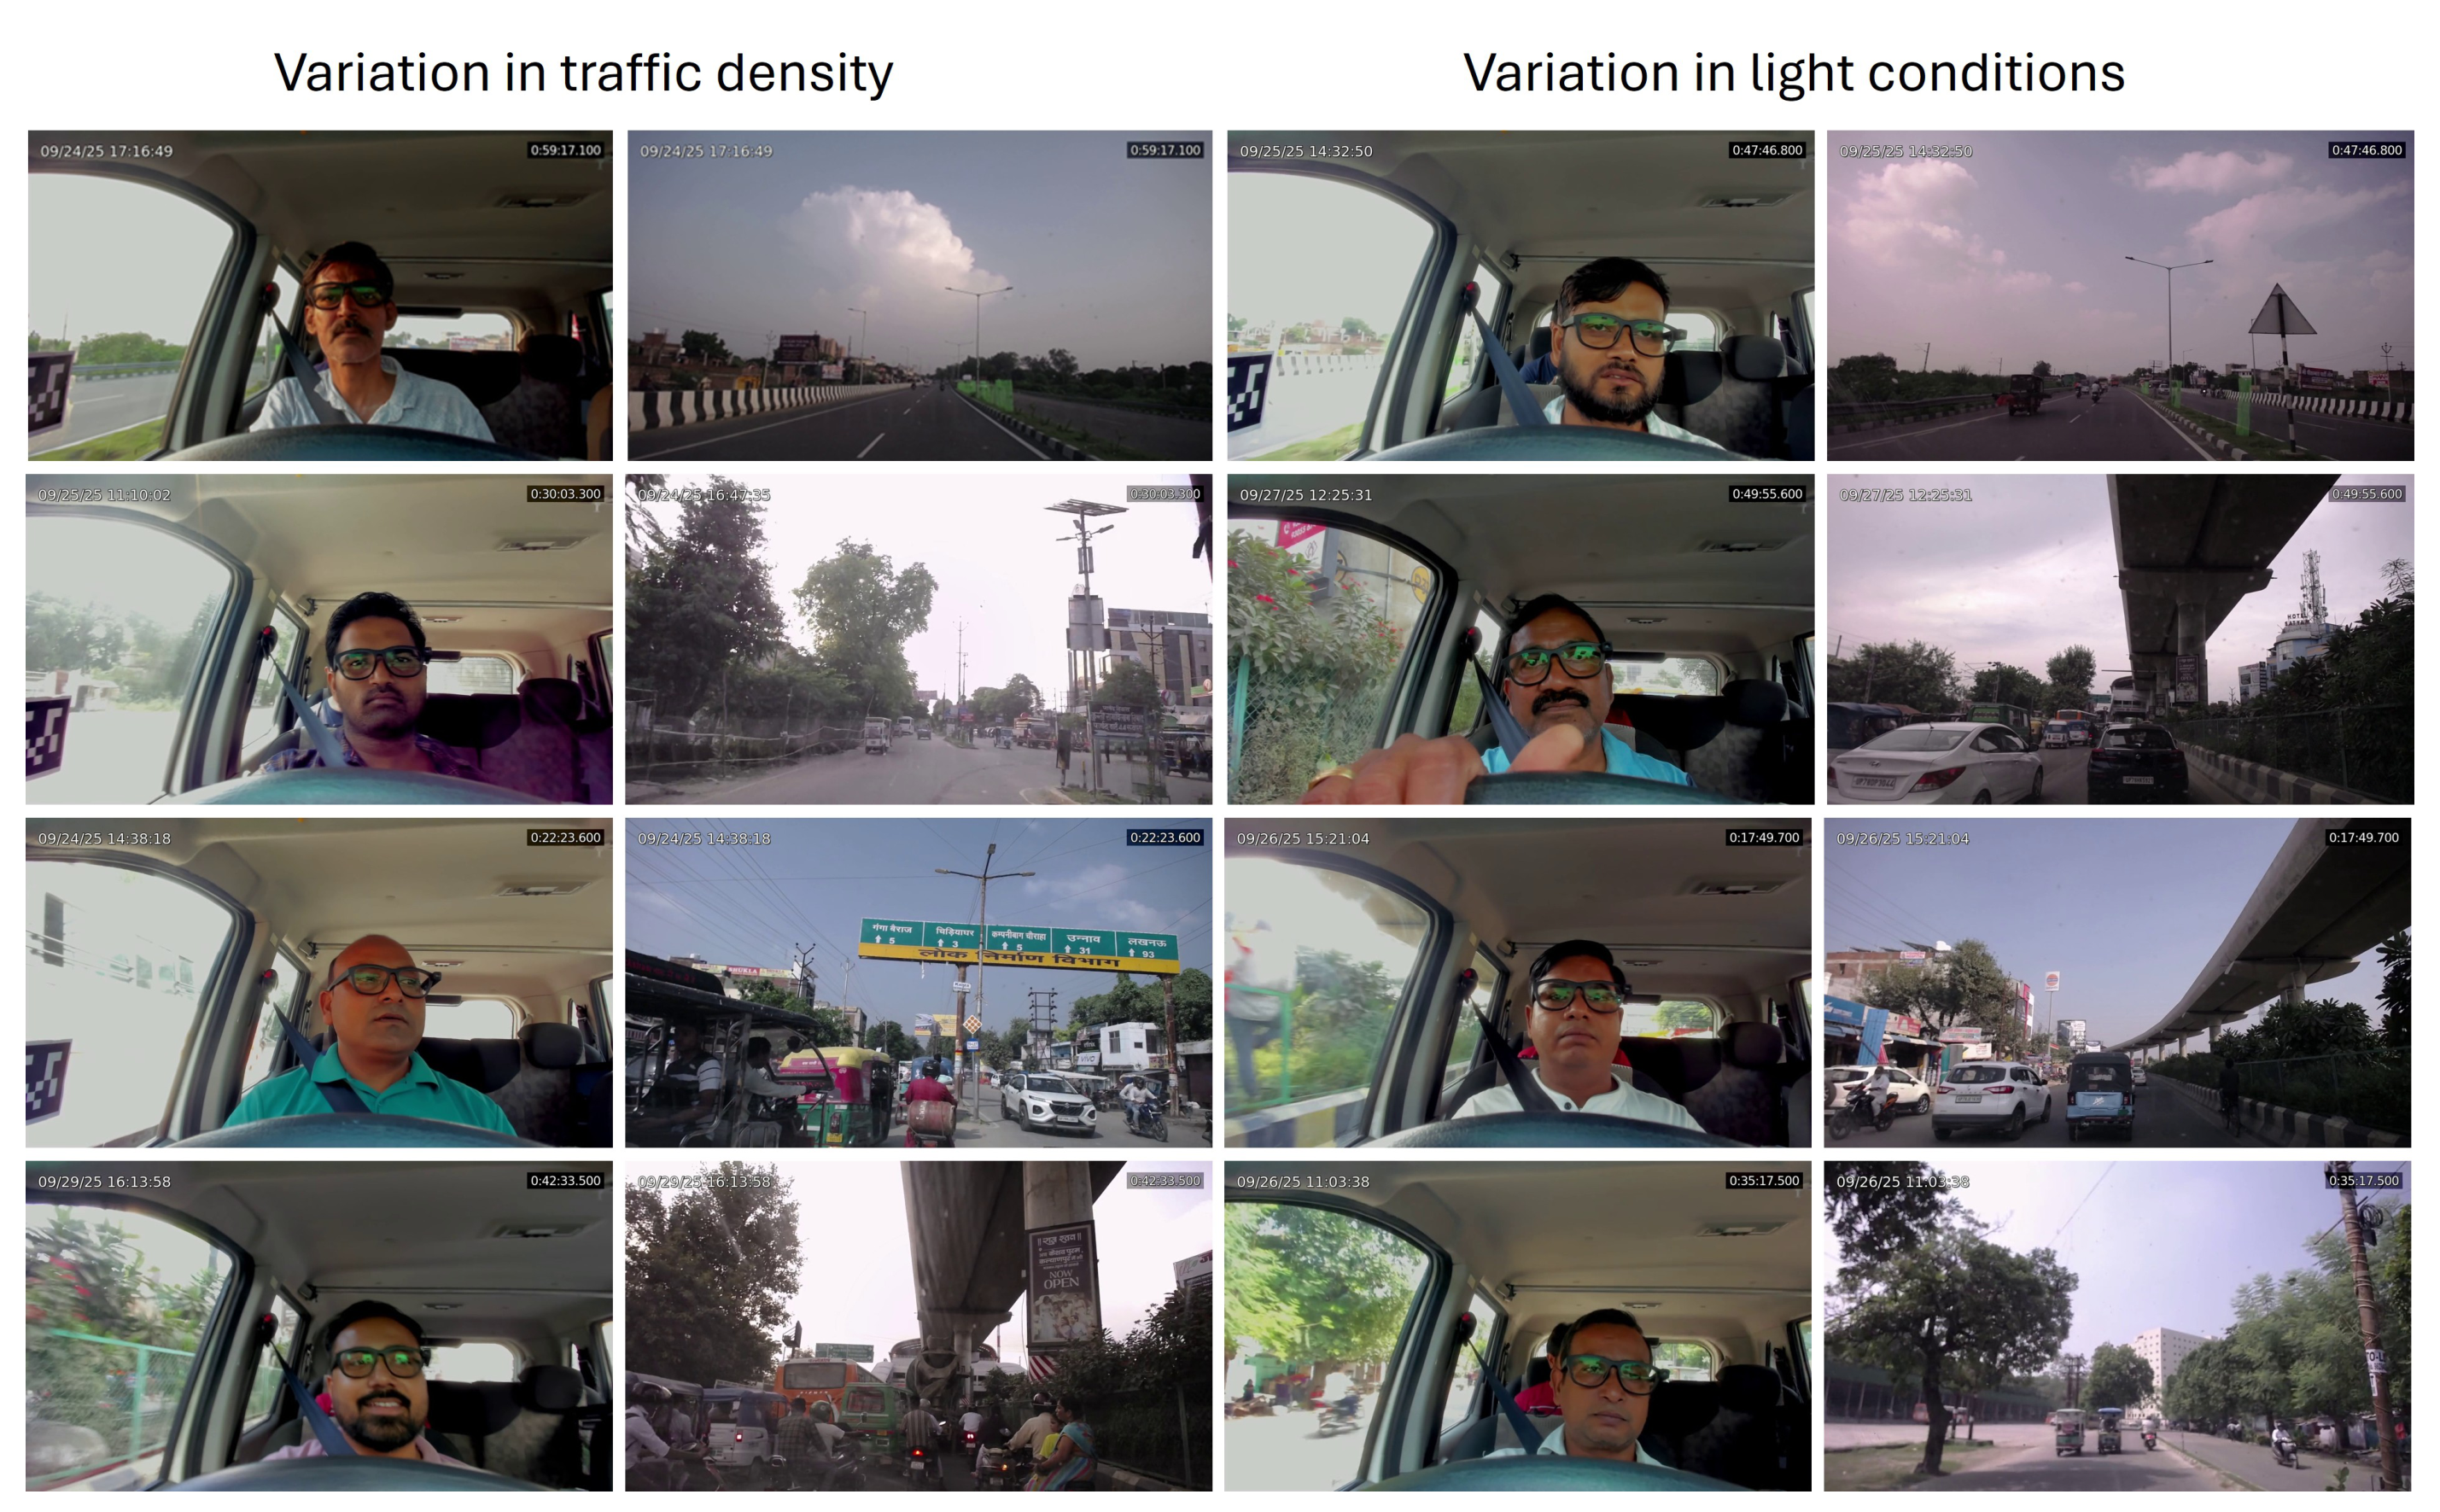
所提出的城市驾驶面部-场景注视数据集(UD-FSG)是一个基准真实驾驶注视数据集,包含来自 35 名驾驶员的 373,488 对驾驶员面部-场景图像对。表 1 给出了我们的数据集与现有基准注视点数据集的详细对比。现有驾驶员注视数据集大多面向车内注视估计,包含驾驶员面部以及以车内区域(如前风挡、车内后视镜等)为真值的注视标签;这些注视数据集的详情见我们先前的研究(Sharma & Chakraborty, 2025)。据作者所知,UD-FSG 是第二个包含同步驾驶员面部与交通场景图像及 2D 注视坐标真值标签的数据集,并且是第一个在异构交通环境中采集、额外提供场景图像中检测交通目标边界框与注视目标标签的数据集。而且,我们的数据集比现有的 LBW 数据集(Kasahara et al., 2022)大得多,交通密度与光照条件的变化也更丰富,如图 4 所示。由多样动态交通参与者(车辆、行人等)构成的交通环境使场景信息更有意义、也足够具挑战性,有利于开发稳健的驾驶员注视估计模型。此外,眼动仪外观与普通处方眼镜相似,使面部图像与真实驾驶任务中观察到的图像相近。这些数据已按第 4 节所述用于训练我们的注视目标预测模型。
| 名称 | 面部 | 场景 | 受试者数 | 规模 | 注视真值1 | 场景类型 |
|---|---|---|---|---|---|---|
| DR(eye)VE(Palazzi et al., 2018) | N2 | Y3 | 8 | 555k4 | PoG | 真实 |
| LBW(Kasahara et al., 2022) | Y | Y | 28 | 123k | PoG | 真实 |
| UD-FSG(本文) | Y | Y | 35 | 373k | PoG + 注视目标 | 真实 |
1 真值(Ground Truth);2 否;3 是;4 千帧;
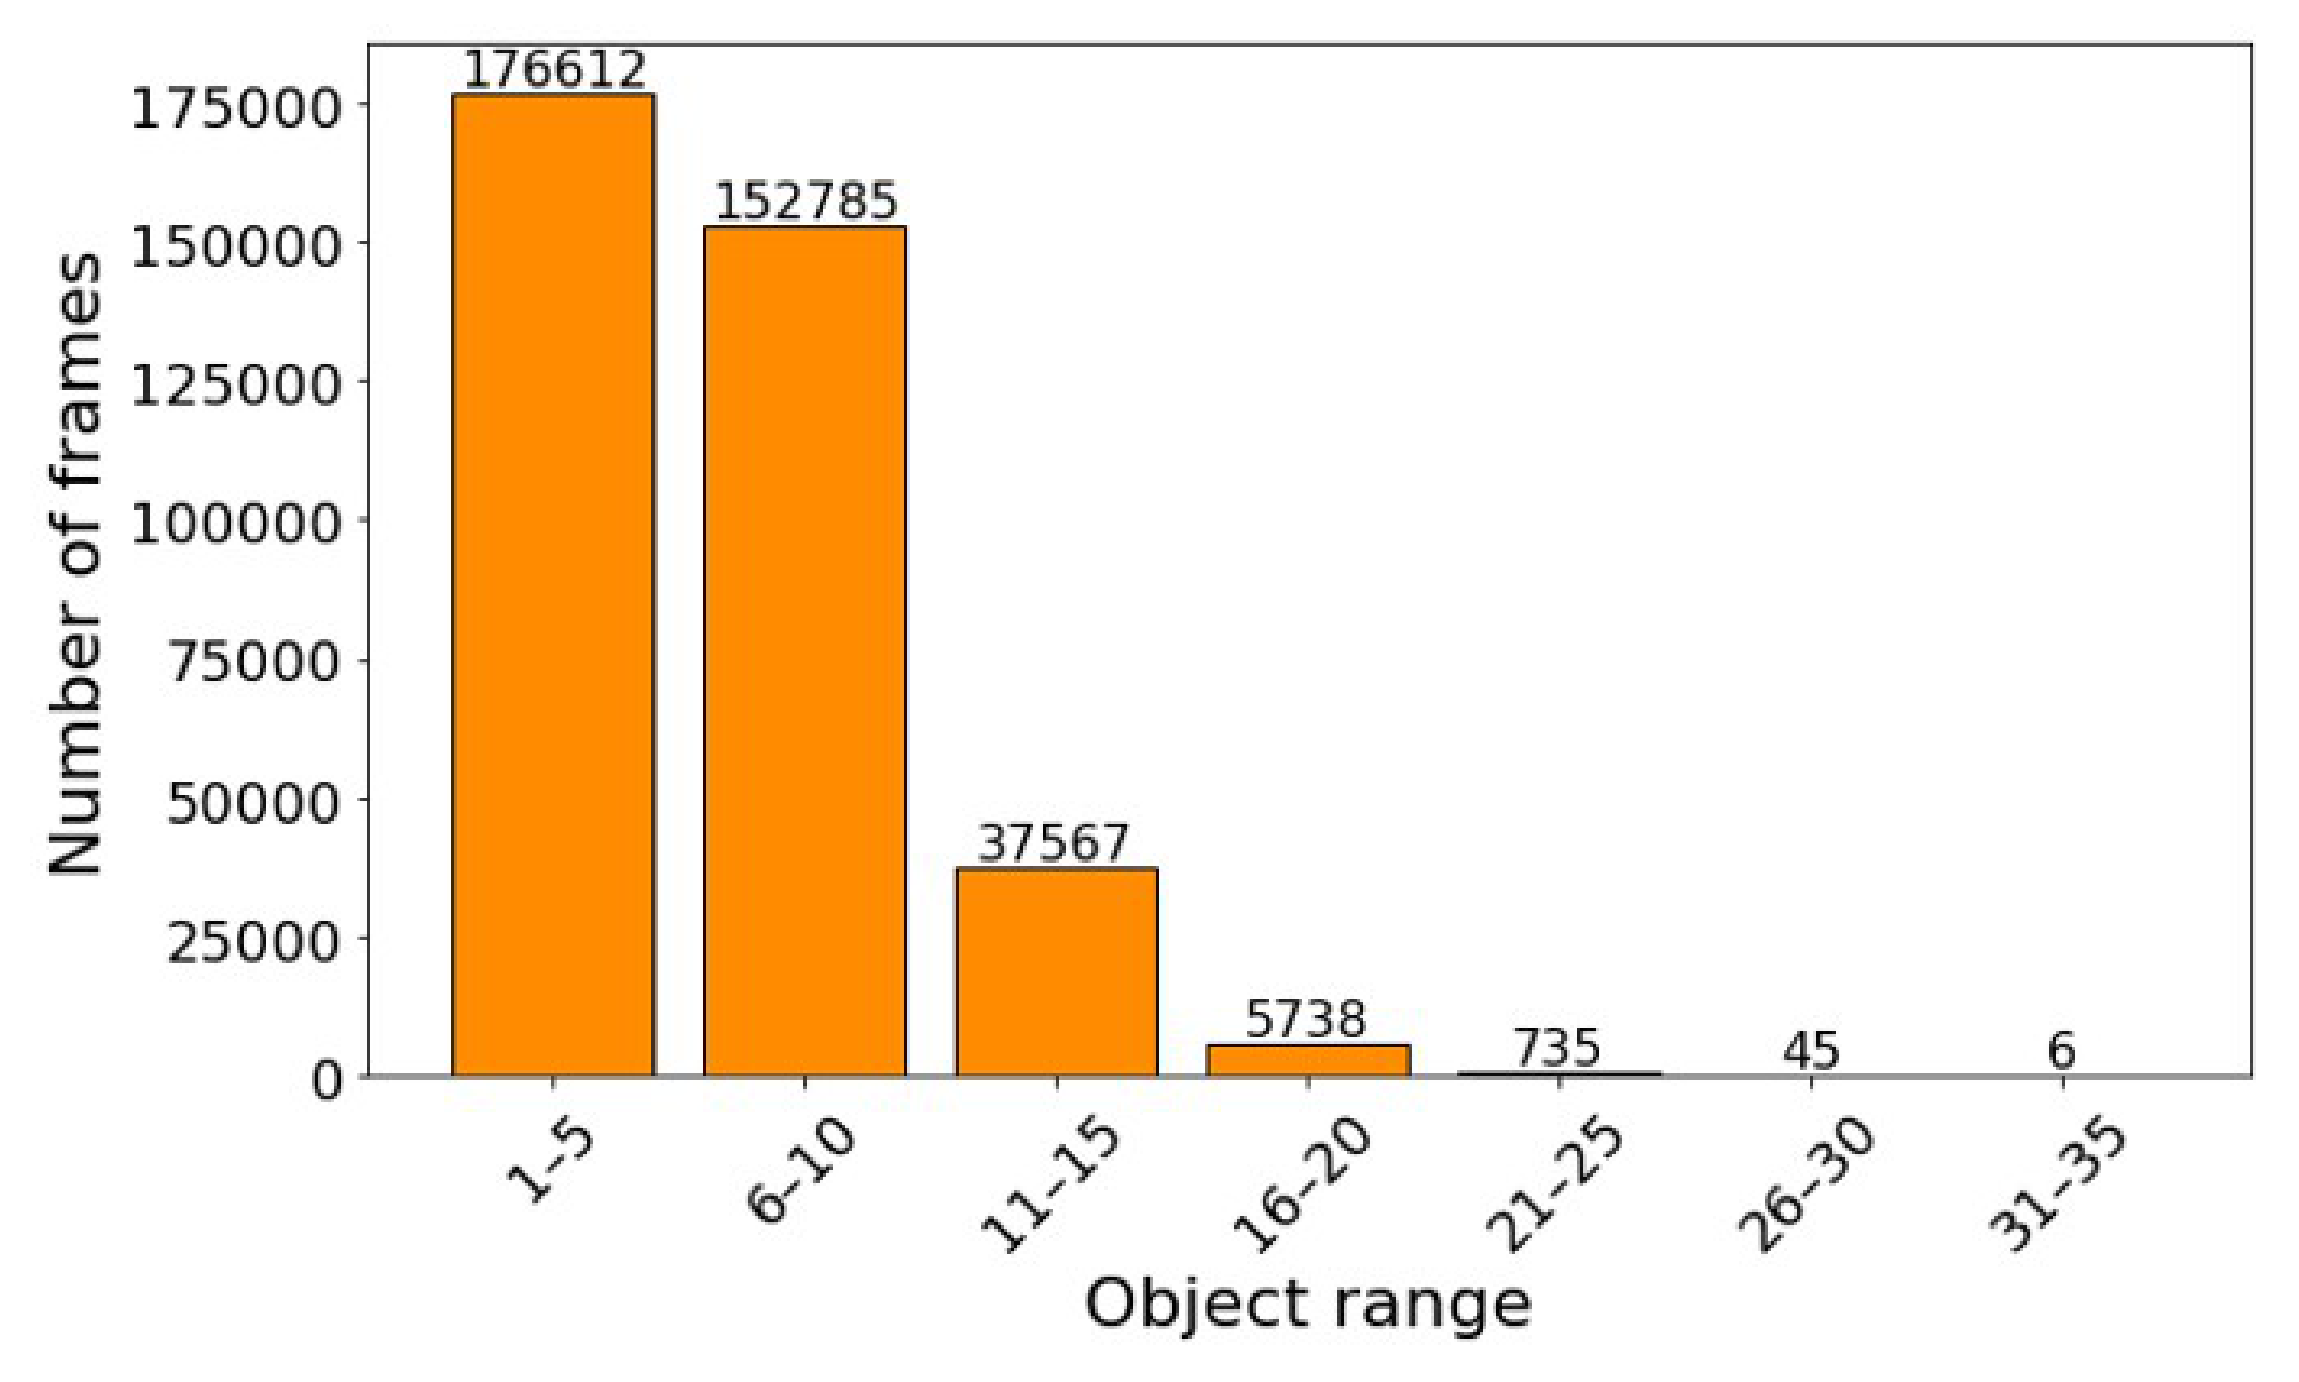
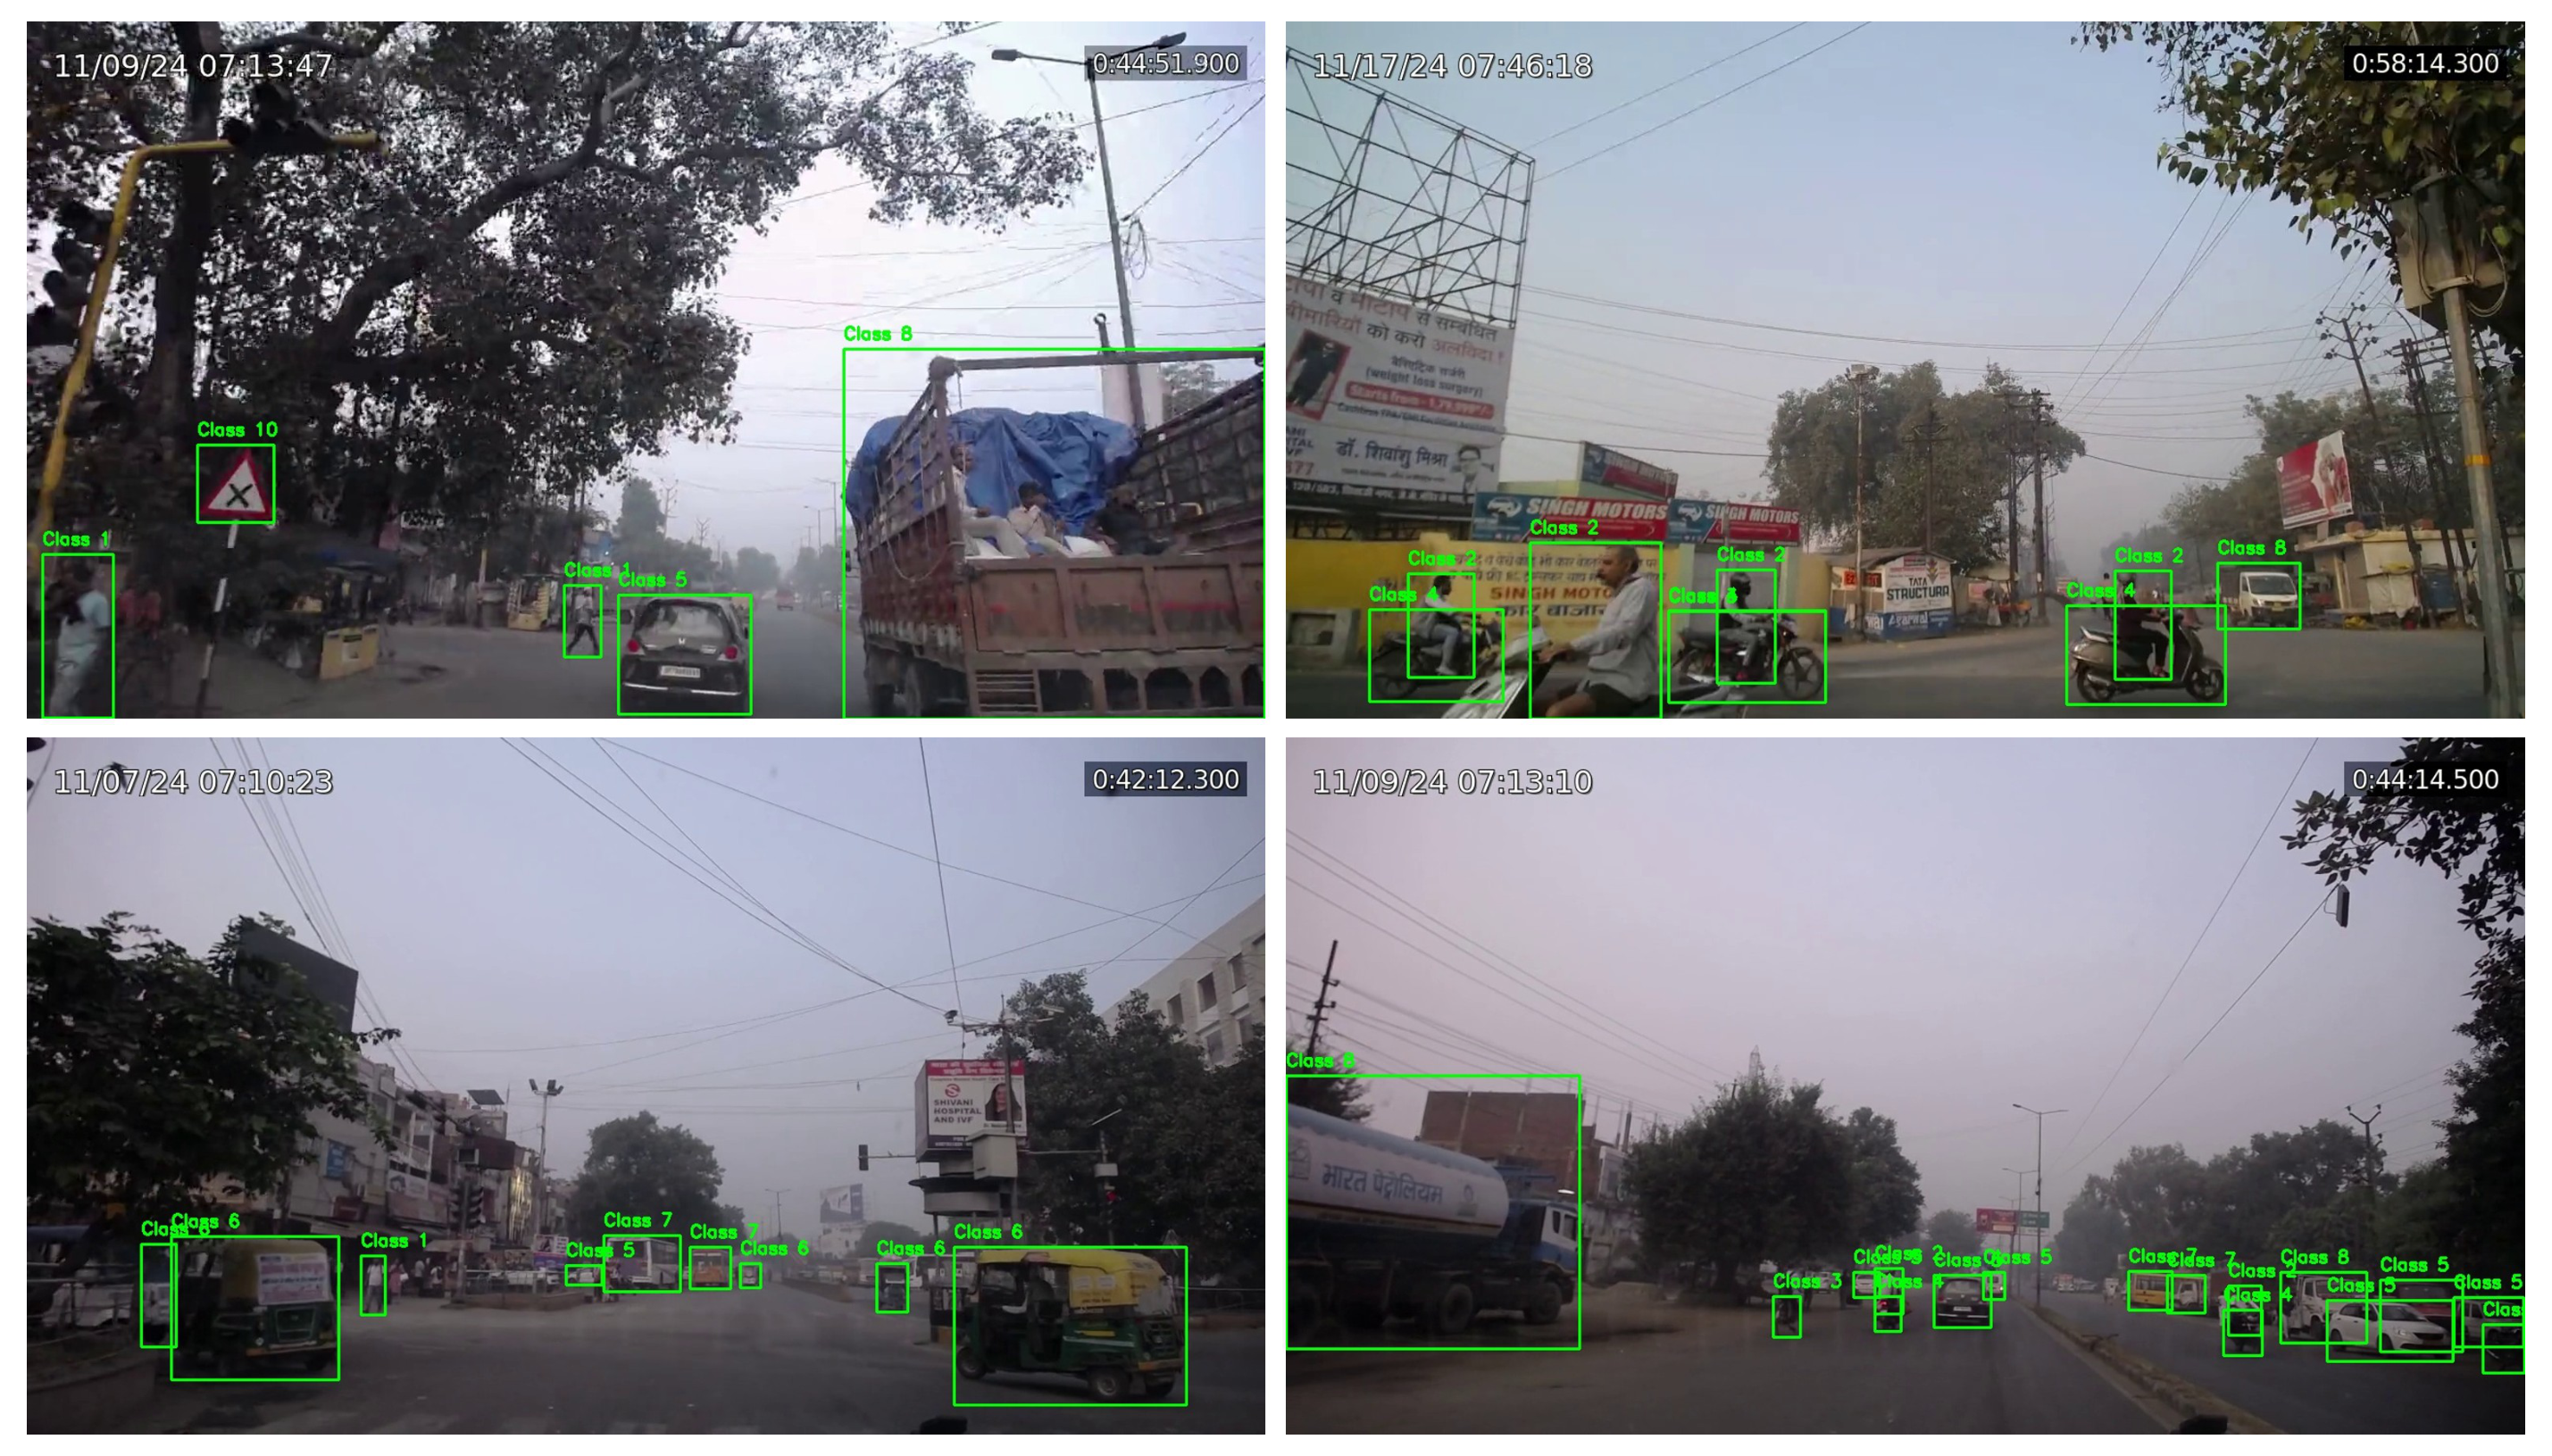
图 5 从每帧场景中目标数量的角度展示了数据集特征。在总共 373,488 帧中,176,612 帧包含 1–5 个目标;约 152,785 帧包含 6–10 个目标;包含 16–20 个目标的帧有 5,738 帧。总体来看,约 99.78% 的帧包含 20 个及以下的交通目标。图 6 展示的检测目标样本按左上到右下排列,检测目标数量递增。
如上所述,UD-FSG 数据集中背景注视标签的数量明显高于注视落在交通目标上的标签数量。为训练所提出的 TransGaze-Object 模型,我们选取了背景样本的一个子集,以获得更均衡的训练数据。训练数据集包含 189,850 对同步的面部-场景图像,以及对应的检测目标边界框坐标和真值注视目标标签。注视目标属于 11 类之一:10 个交通目标类别(行人、骑手、自行车、摩托车、自动载客三轮车、汽车、公共汽车、卡车、交通标志、交通信号灯)和 1 个背景类。在 189,850 对面部-场景图像中,141,884 个样本对应驾驶员注视落在某个交通目标上的情形(即真值为交通目标之一),其余 47,966 个样本对应背景类。最后,我们取 26 名驾驶员的数据作为训练集(165,969 个样本),5 名驾驶员作为验证集(9,208 个样本),3 名驾驶员作为测试集(14,673 个样本)。训练数据细节见表 2。下一节详细介绍用于开发和训练注视目标预测模型的方法。
| 真值类别 | 训练 | 验证 | 测试 |
|---|---|---|---|
| 交通目标 | 125,565 | 6,441 | 9,878 |
| 背景 | 40,404 | 2,767 | 4,795 |
| 合计 | 165,969 | 9,208 | 14,673 |
本节提出基于 Transformer 的注视目标预测模型(TransGaze-Object),它利用面部特征与场景目标的空间信息来预测驾驶员正在看的目标。
问题形式化:假设给定图像 i(图 7a)包含 Ni 个交通目标(图 7b)。驾驶员可能看这 Ni 个交通目标之一,也可能看背景。因此,我们的目标是估计驾驶员在 Ni + 1 个目标(+1 为背景)中正注视哪一个。
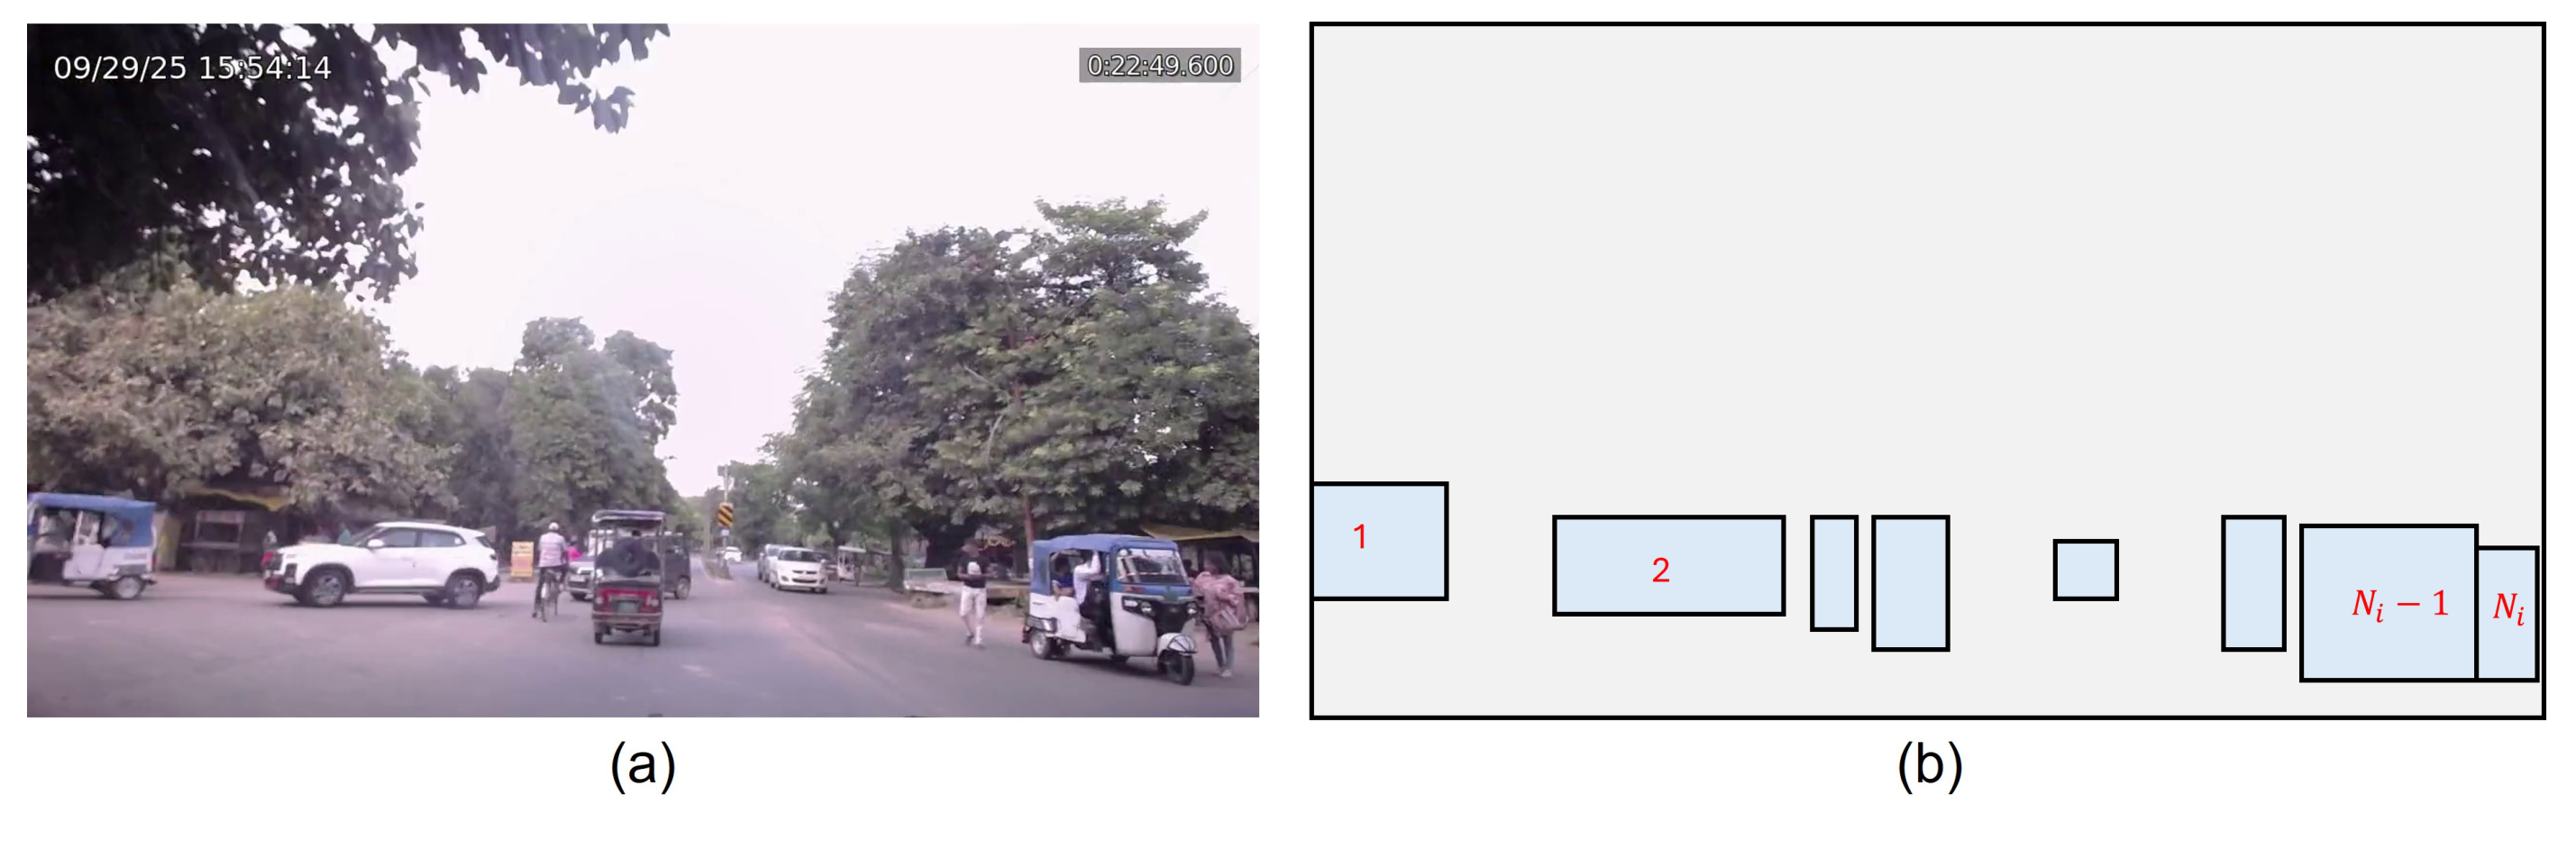
设面部表示定义为 F ∈ ℝH×W×3,其中 H、W 为图像的高与宽,3 表示 RGB(红-绿-蓝)通道。场景表示为 N + 1 个目标的集合,包含最多 N 个交通目标和 1 个背景目标。由于交通目标数量随场景图像而变,根据数据集中多数图像的最大目标数选定固定的 N;交通目标少于 N 的场景图像用虚拟目标填充以保持一致的输入表示。目标表示为:
每个边界框 bi = (xi, yi, wi, hi) 对应第 i 个检测到的交通目标,其中 (xi, yi) 为边界框中心坐标,wi、hi 为其宽与高。背景的表示将在目标特征提取的讨论中说明。任务即预测注视目标,即目标索引 id(ŷ):
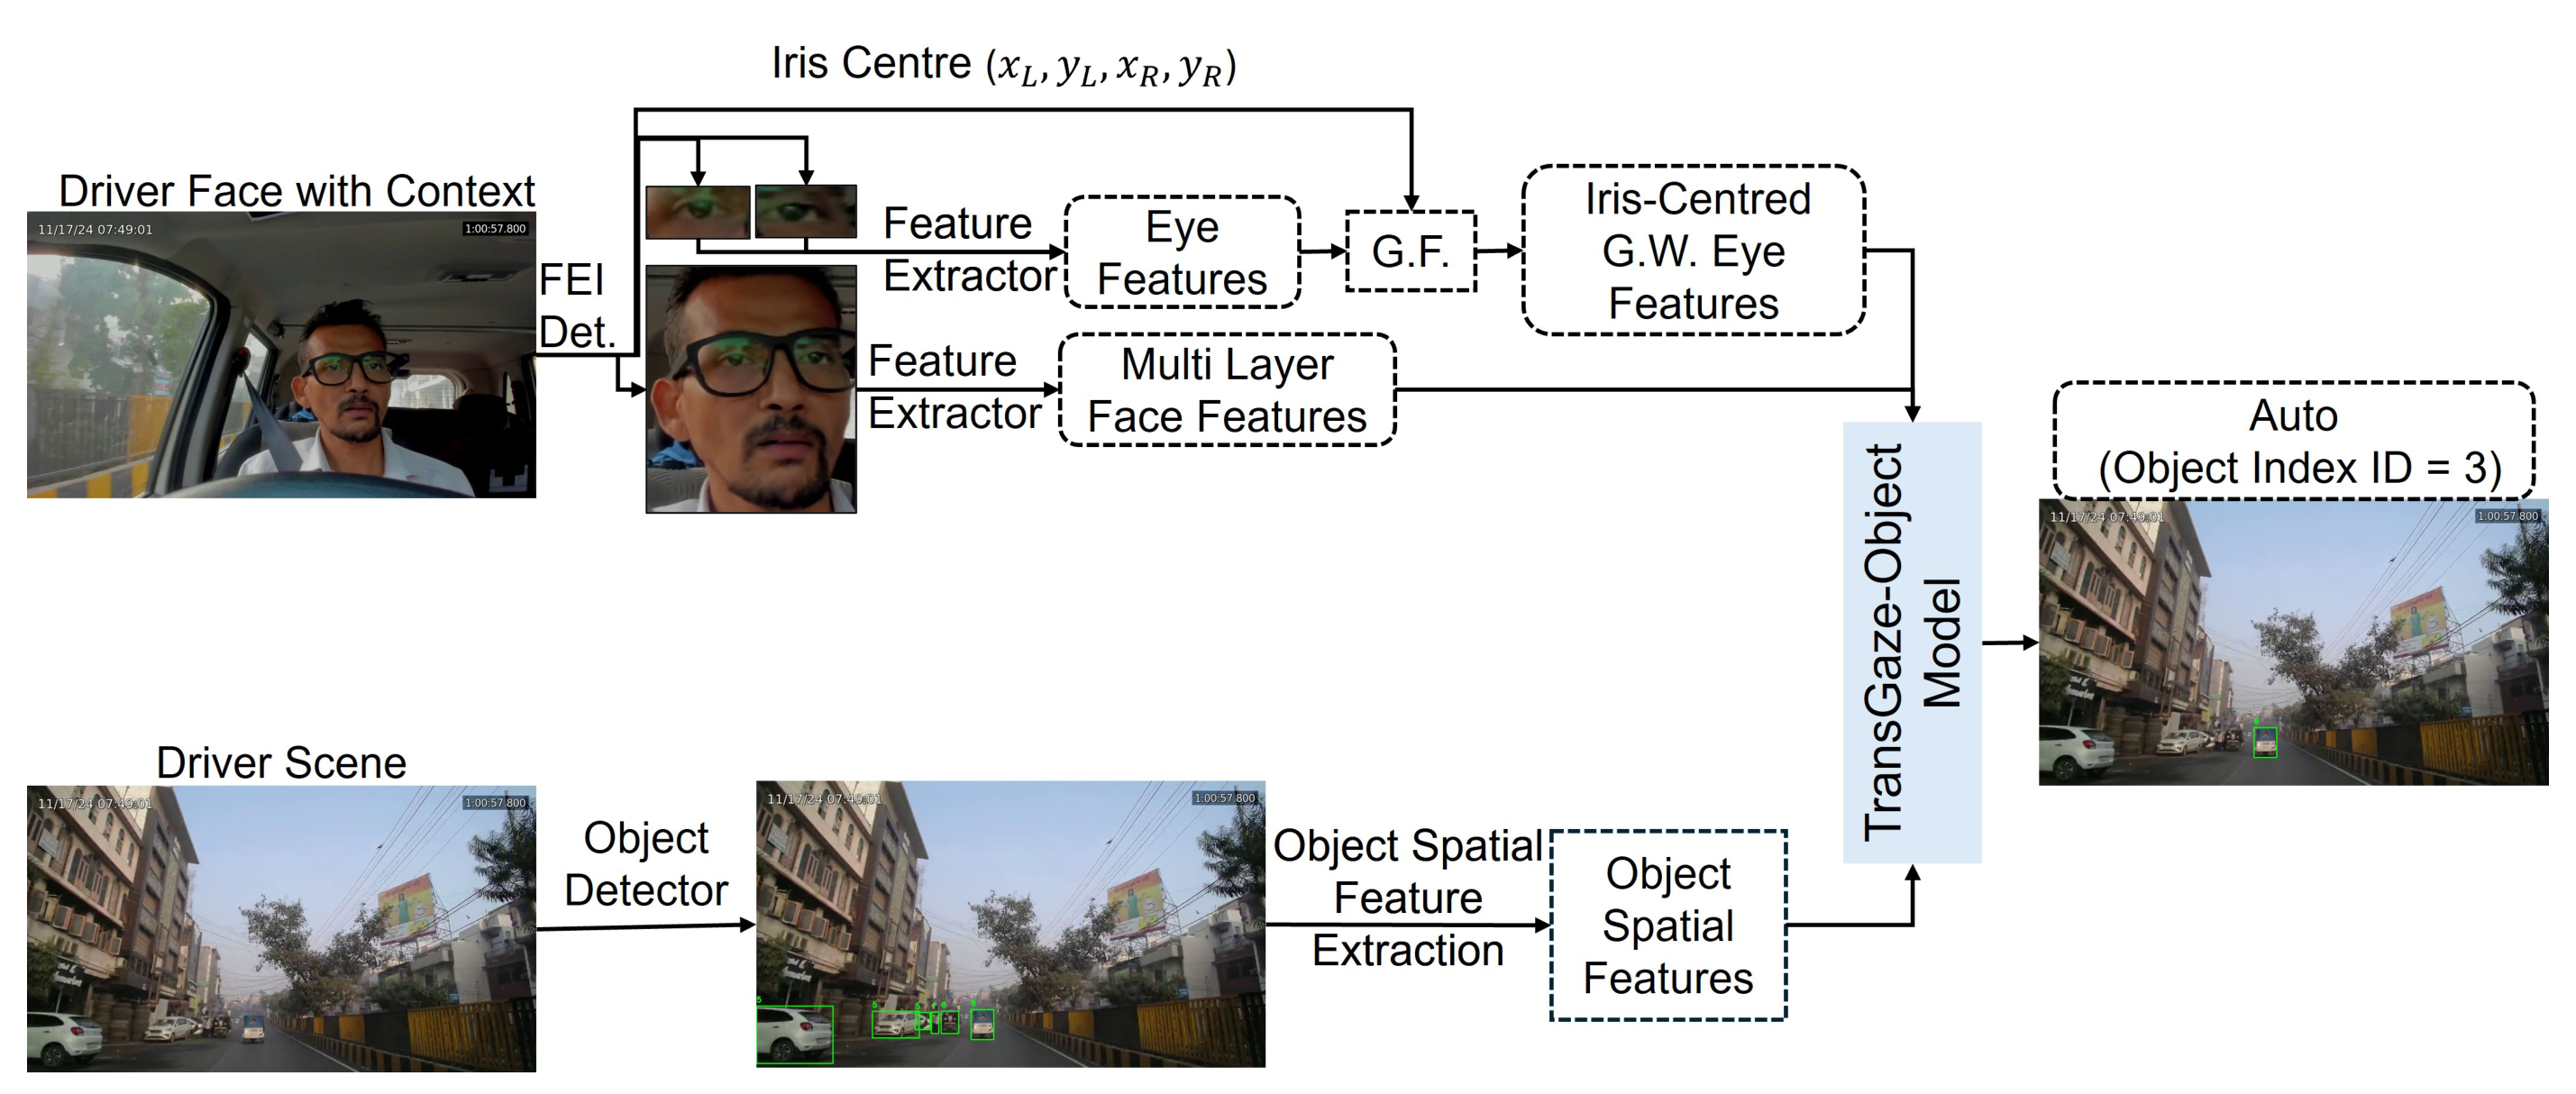
总体框架:所提模型由五个主要组件构成:(1) 面部几何检测(面部、眼睛、虹膜)与场景目标检测;(2) 特征提取,包括面部特征提取和目标空间与几何特征提取;(3) 基于 Transformer 的面部与场景目标特征编码;(4) 编码后面部特征与场景特征之间的交叉注意力;(5) 注视目标预测头。以下逐一讨论各步骤。所提注视目标预测的流水线如图 8 所示。
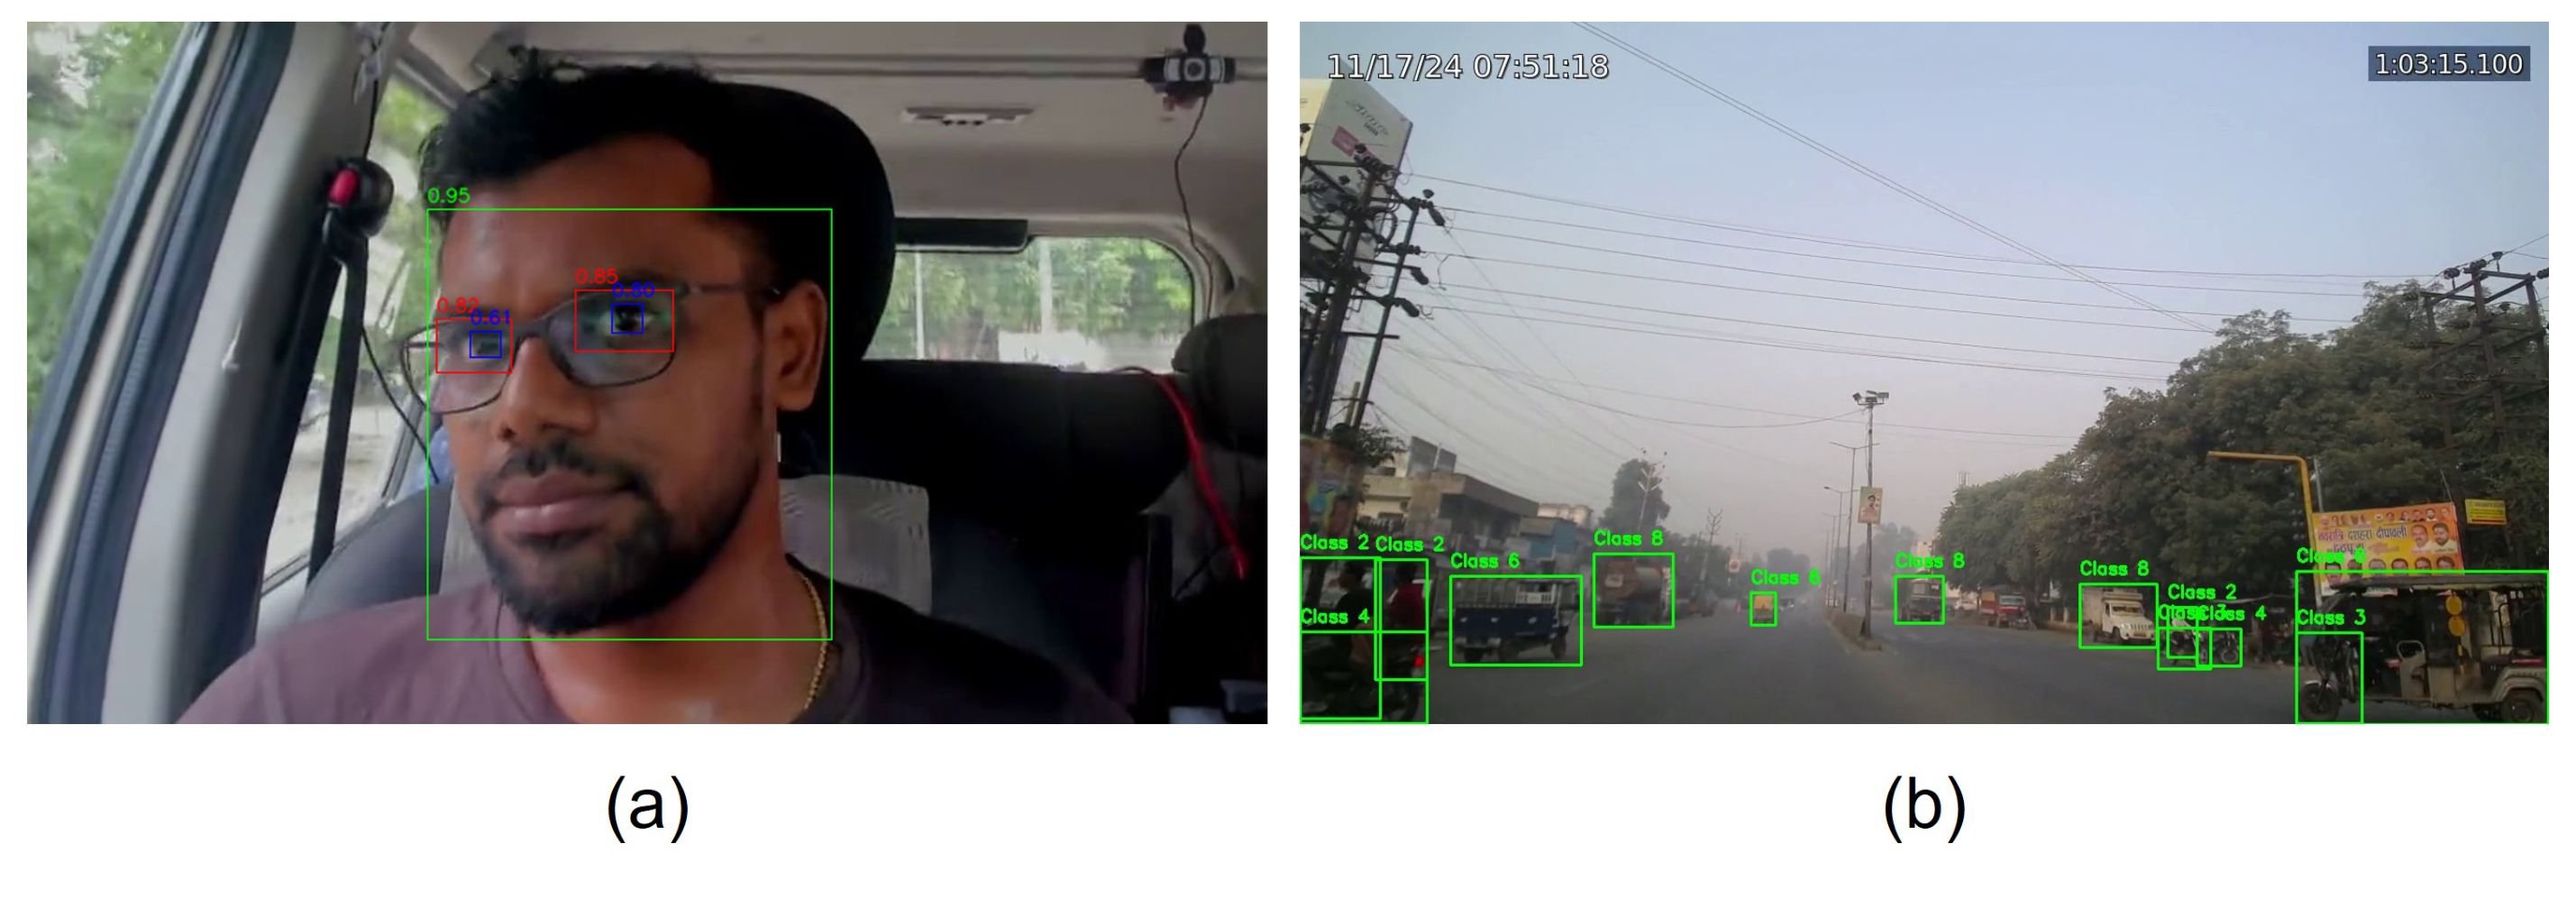
所提方法的第一步是从面部相机图像中检测驾驶员面部、从场景相机图像中检测交通目标,如图 9 所示。仪表盘面部相机拍摄的面部图像用于提取驾驶员面部几何,使用面部-眼睛-虹膜(face-eye-iris,FEI)检测器;场景图像中的目标则用下文介绍的自定义交通目标检测器检测。
面部相机拍摄到驾驶员面部,同时也包含一些周边环境,如图 9a 所示。为了把环境与面部分离并检测面部、眼睛与虹膜,我们用预训练 YOLOv8 模型(Ultralytics, 2023)开发了一个自定义面部-眼睛-虹膜检测器。该模型用 481 名驾驶员的 2,200 张标注面部图像训练,图像来自多个现有驾驶员注视数据集,如 DMD(Driver Monitoring Dataset)(Ortega et al., 2020)、DGAGE(Driver Gaze Mapping on Road)(Dua et al., 2020)、DGW(Driver Gaze in Wild)(Ghosh et al., 2021)、ET-DGAZE(Eye Tracker based Driver Gaze Dataset)(Sharma & Chakraborty, 2025),并用 CVAT(Computer Vision Annotation Tool)标注为三个类别:面部(Face)、眼睛(Eye)与虹膜(Iris)。注意,FEI 检测器所用的数据与训练注视目标预测模型的数据不同。
FEI 模型在 IoU 阈值 0.5 下取得 95.7% 的平均精度均值(mAP),召回率 93.0%。该训练好的模型用于从每张输入面部图像 F 中定位面部、眼睛和虹膜区域(图 9a)。基于检测到的眼睛与虹膜边界框,计算每只眼睛的虹膜中心(相对对应眼部区域左上角)。当只有一只眼睛检测到虹膜时,缺失的虹膜位置用共轭眼动(conjugate eye movement)的生理特性(Yarbus, 2013; Yang et al., 2019)估计,该特性假设双眼协调运动。因此,面部几何提取模块输出面部边界框、左右眼边界框,以及相对各自眼部区域表示的左右虹膜中心坐标。
在真实驾驶条件下,存在因遮挡、运动模糊、大幅头转或光照变化导致双眼虹膜都无法可靠检测的情况。为应对这些情况,框架中加入了有效性感知的门控策略:若没有有效的虹膜坐标,则停用对应的虹膜表示,并在特征融合中消除其影响,以避免向注视估计过程引入不可靠信息。此时模型会动态加大对剩余视觉线索(面部外观、眼区特征和场景信息)的权重。这一自适应机制使框架即便在虹膜位置信息不可用时也能保持稳定、可靠的注视估计性能。
所提注视目标检测模型需要交通场景中交通目标的信息,由仪表盘前视场景相机捕获(图 9b)。因此交通目标检测是所提模型的先决条件。我们训练了一个 YOLOv8(Ultralytics, 2023)目标检测器来检测场景图像中的交通目标。交通目标分为 10 类:行人、骑手、自行车、摩托车、汽车、自动载客三轮车、公共汽车、卡车、交通信号灯和交通标志。
为训练交通目标检测器,交通数据来自开源数据集,包括 IDD(Indian Driving Dataset)(Varma et al., 2019)、nuImages(Caesar et al., 2020)数据集和 UD-FSG 数据集(Sharma & Chakraborty, 2026)。由于原始数据集不含所有期望的交通目标类别标注(如 nuImages 不含骑手、自动载客三轮车、交通信号灯、交通标志类),我们用 CVAT 应用做了额外的手工标注:两名标注者为缺失类别打标签,确保整个数据集标注一致、统一,适合训练目标检测模型。在包含多目标的 10,981 张交通场景图像上对预训练 YOLOv8 模型微调训练,模型在置信度阈值 0.5(50%)下取得 79.1% 的平均精度均值(mAP)。由于目标检测并非 100% 准确,未检测到目标的情形被人工标注,用于准备注视目标预测模型的数据。
多流特征提取模块通过各自独立的特征提取流处理异构输入模态(即视觉特性与语义信息不同的输入)(Liu et al., 2025)。每条流从面部、眼睛和场景输入中学习模态特定的表示。
我们使用预训练 ResNet-18 骨干作为层级特征编码器,为注视估计获取紧凑且有判别力的面部表示。检测到的面部图像先缩放到 If ∈ ℝ3×224×224 以符合 ResNet 输入配置;缩放后的图像被归一化,前向通过卷积干(stem)与 ResNet-18 的四个残差阶段(He et al., 2016)提取中间特征图。这里卷积干指提取低级视觉特征的初始层,残差阶段由堆叠的残差块(也称 Layer-1/2/3/4)组成,逐步学习更高级的表示。可表示为:
其中 ℬl(·) 表示直到第 l 个残差块的变换,Fl ∈ ℝCl×Hl×Wl 为各特征图,通道维 Cl ∈ {64, 128, 256, 512}(l ∈ {1, 2, 3, 4}),Hl、Wl 为特征图的空间分辨率(高与宽)。
由于各层通道维 Cl 不同,我们用可学习的 1 × 1 卷积把每个特征图投影到统一的 256 维嵌入空间:
其中 φl(·) 表示通道投影操作。最后,在空间维度上做自适应全局平均池化(GAP),从每层得到 256 维特征向量,记作 fl = GAP(F̂l) ∈ ℝ256。每个通道响应按下式计算:
其中 c ∈ {1, …, 256} 为投影后特征图的通道索引。这样,对每张面部图像,从网络的不同语义深度提取出四个层级全局面部特征向量 {f1, f2, f3, f4},每个都是 256 维。这些多层全局嵌入捕捉互补的面部信息,从浅层的细粒度纹理模式到深层的高级结构语义,如图 10 所示。得到的 256 维全局表示随后用于所提出的多模态特征融合模块进行注视目标预测。
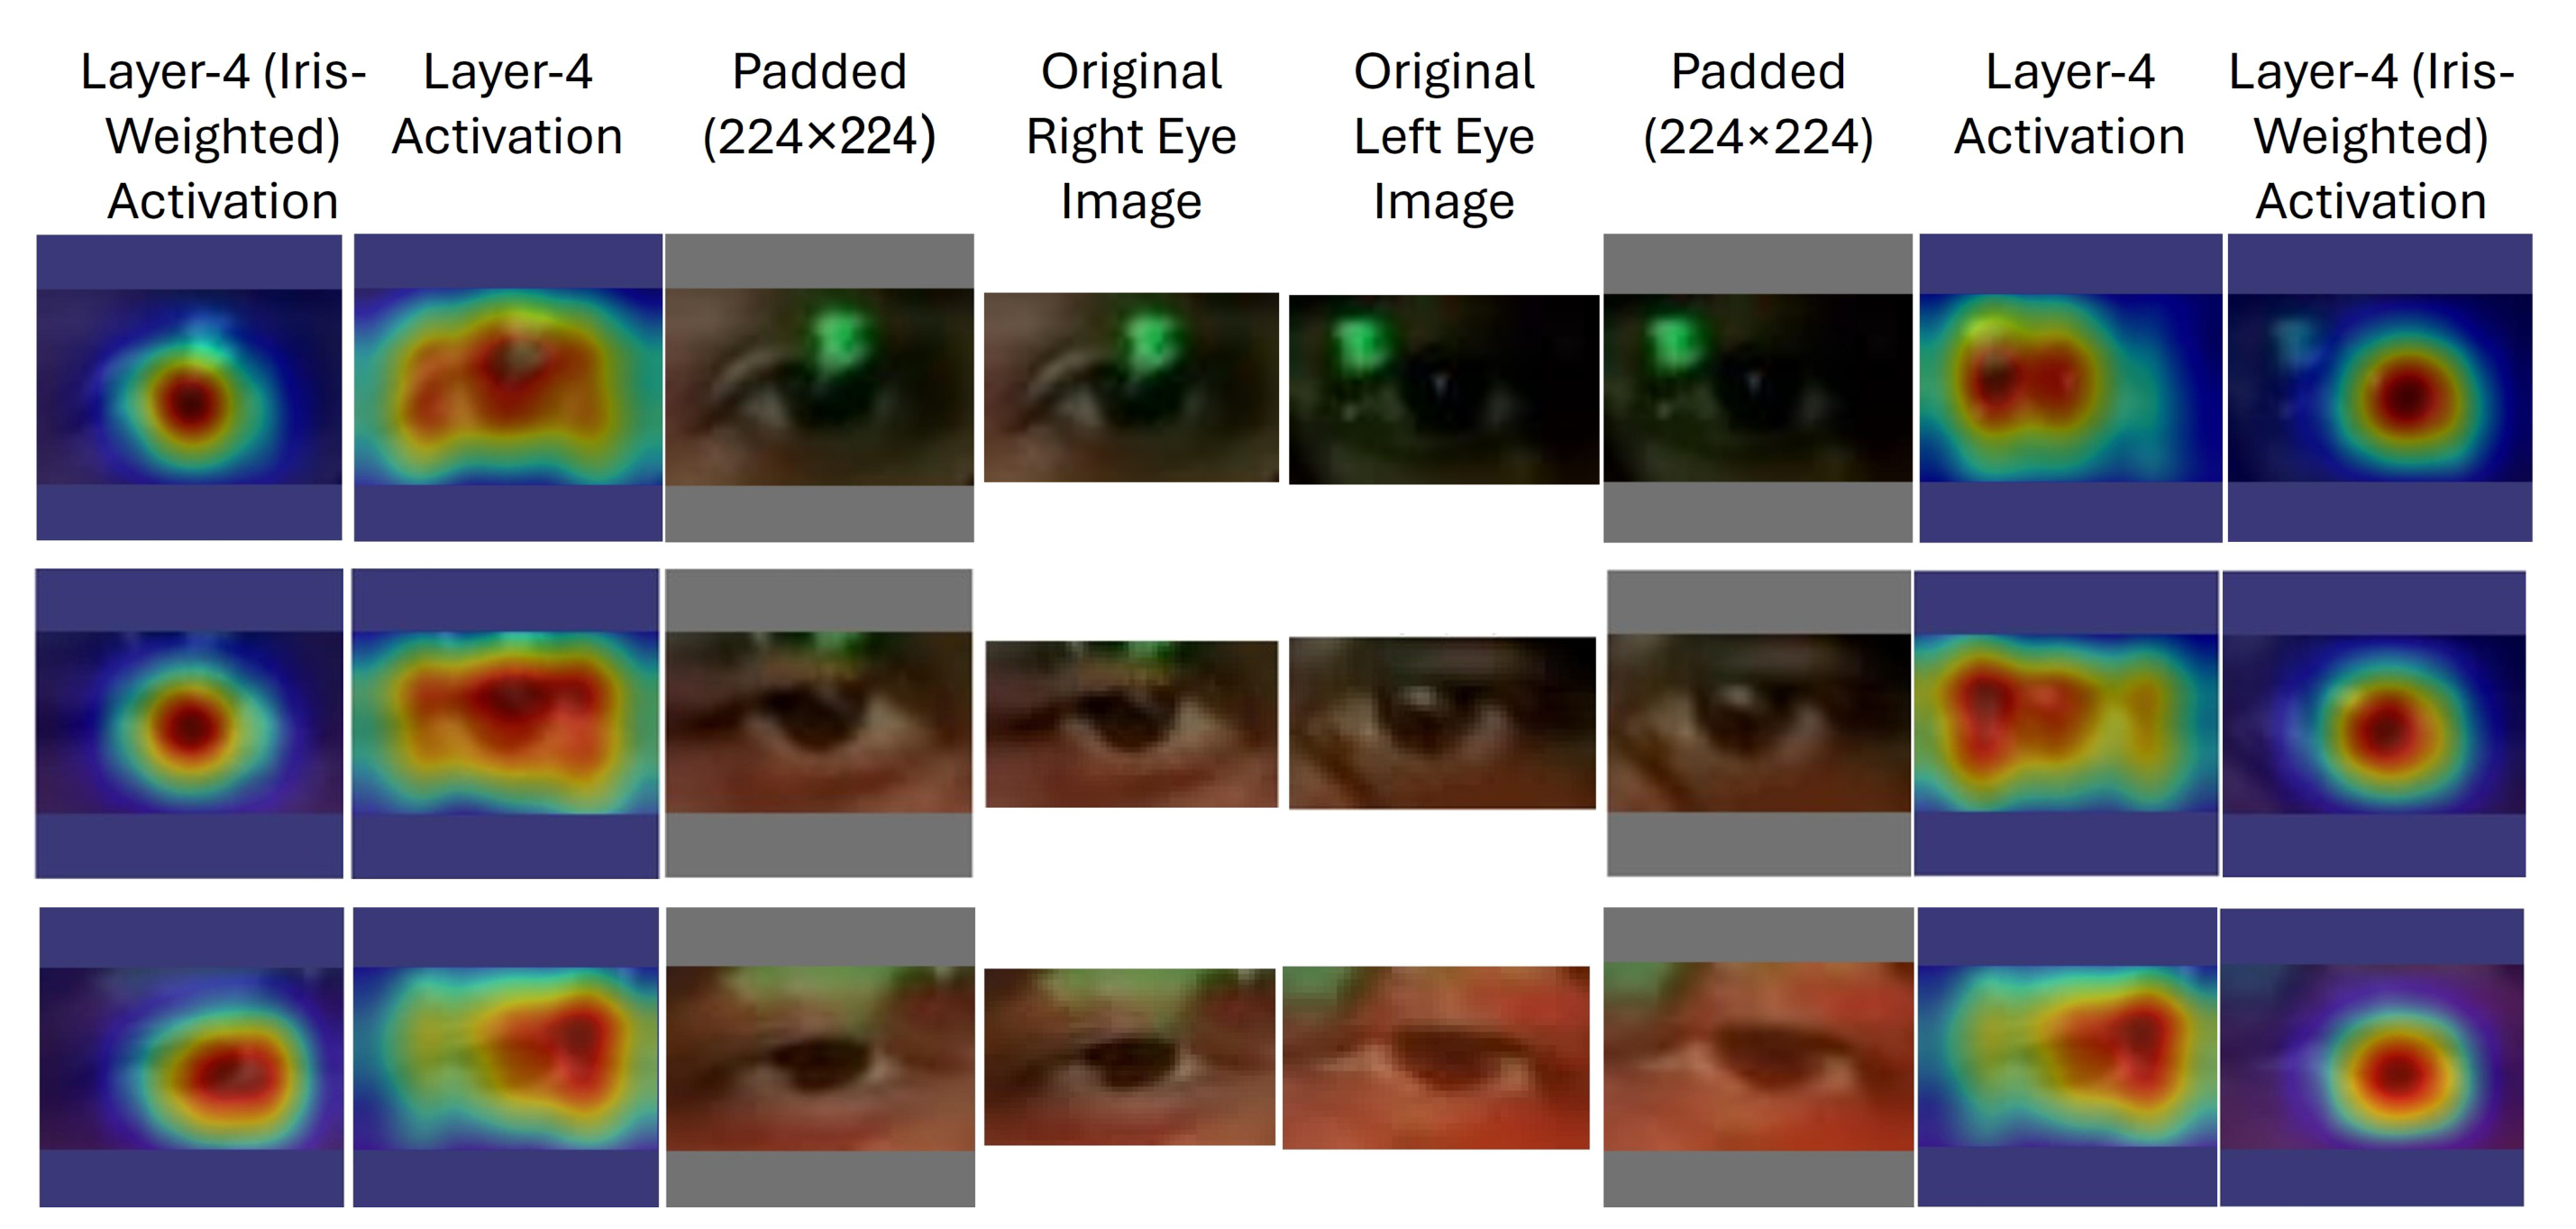
除整体面部特征外,眼睛以及虹膜相对眼睛的位置对确定参与者注视位置极为重要。因此,我们为用 FEI 模型检测到的眼区及虹膜位置设计了一种高效的眼部特征提取方法。首先,眼部特征用预训练 ResNet-18 骨干提取,采用最后的残差块(layer4)获取高级语义特征。由于 FEI 检测裁出的眼部图像不满足 ResNet 架构 224×224 的输入分辨率要求,我们先缩放(224×224)再做常数填充以保持长宽比。填充值取 114,作为中性灰度以最小化人工边界效应、避免填充区域产生意外特征激活。图 11 展示了原始左右眼图像样本及用作 ResNet 模型输入的填充图像。左右眼填充图像(各为 Ie ∈ ℝ3×224×224)被归一化后,分别前向通过 ResNet-18 的卷积干与残差层,得到左右眼的深度特征图:
与面部特征提取模块类似,再用 1 × 1 卷积投影把通道维降到 256:
为了在眼部特征图中强调 FEI 模型给出的虹膜区域,施加一个以虹膜位置为中心的空间高斯加权函数。设 (cx, cy) 为投影到特征图空间的虹膜中心坐标,空间位置 (x, y) 处的 2D 高斯权重定义为:
其中 σ(实验中取 1.2)控制高斯分布的扩散程度。这个归一化权重图给靠近虹膜中心的特征更高的重要性,同时抑制外围区域。高斯加权后的特征图计算为:
其中 c 为通道索引。最后,通过自适应全局平均池化获得全局表示:
其中 GAP(F̃e) 用与式 (8) 相同的方式计算。注意,E 对左右眼分别表示,记为 eL 与 eR。图 11 给出了眼部特征提取各步骤的样本图像。这种高斯加权的全局嵌入增强了以虹膜为中心的判别信息,同时保留眼周上下文特征,特别适合精确的注视估计。
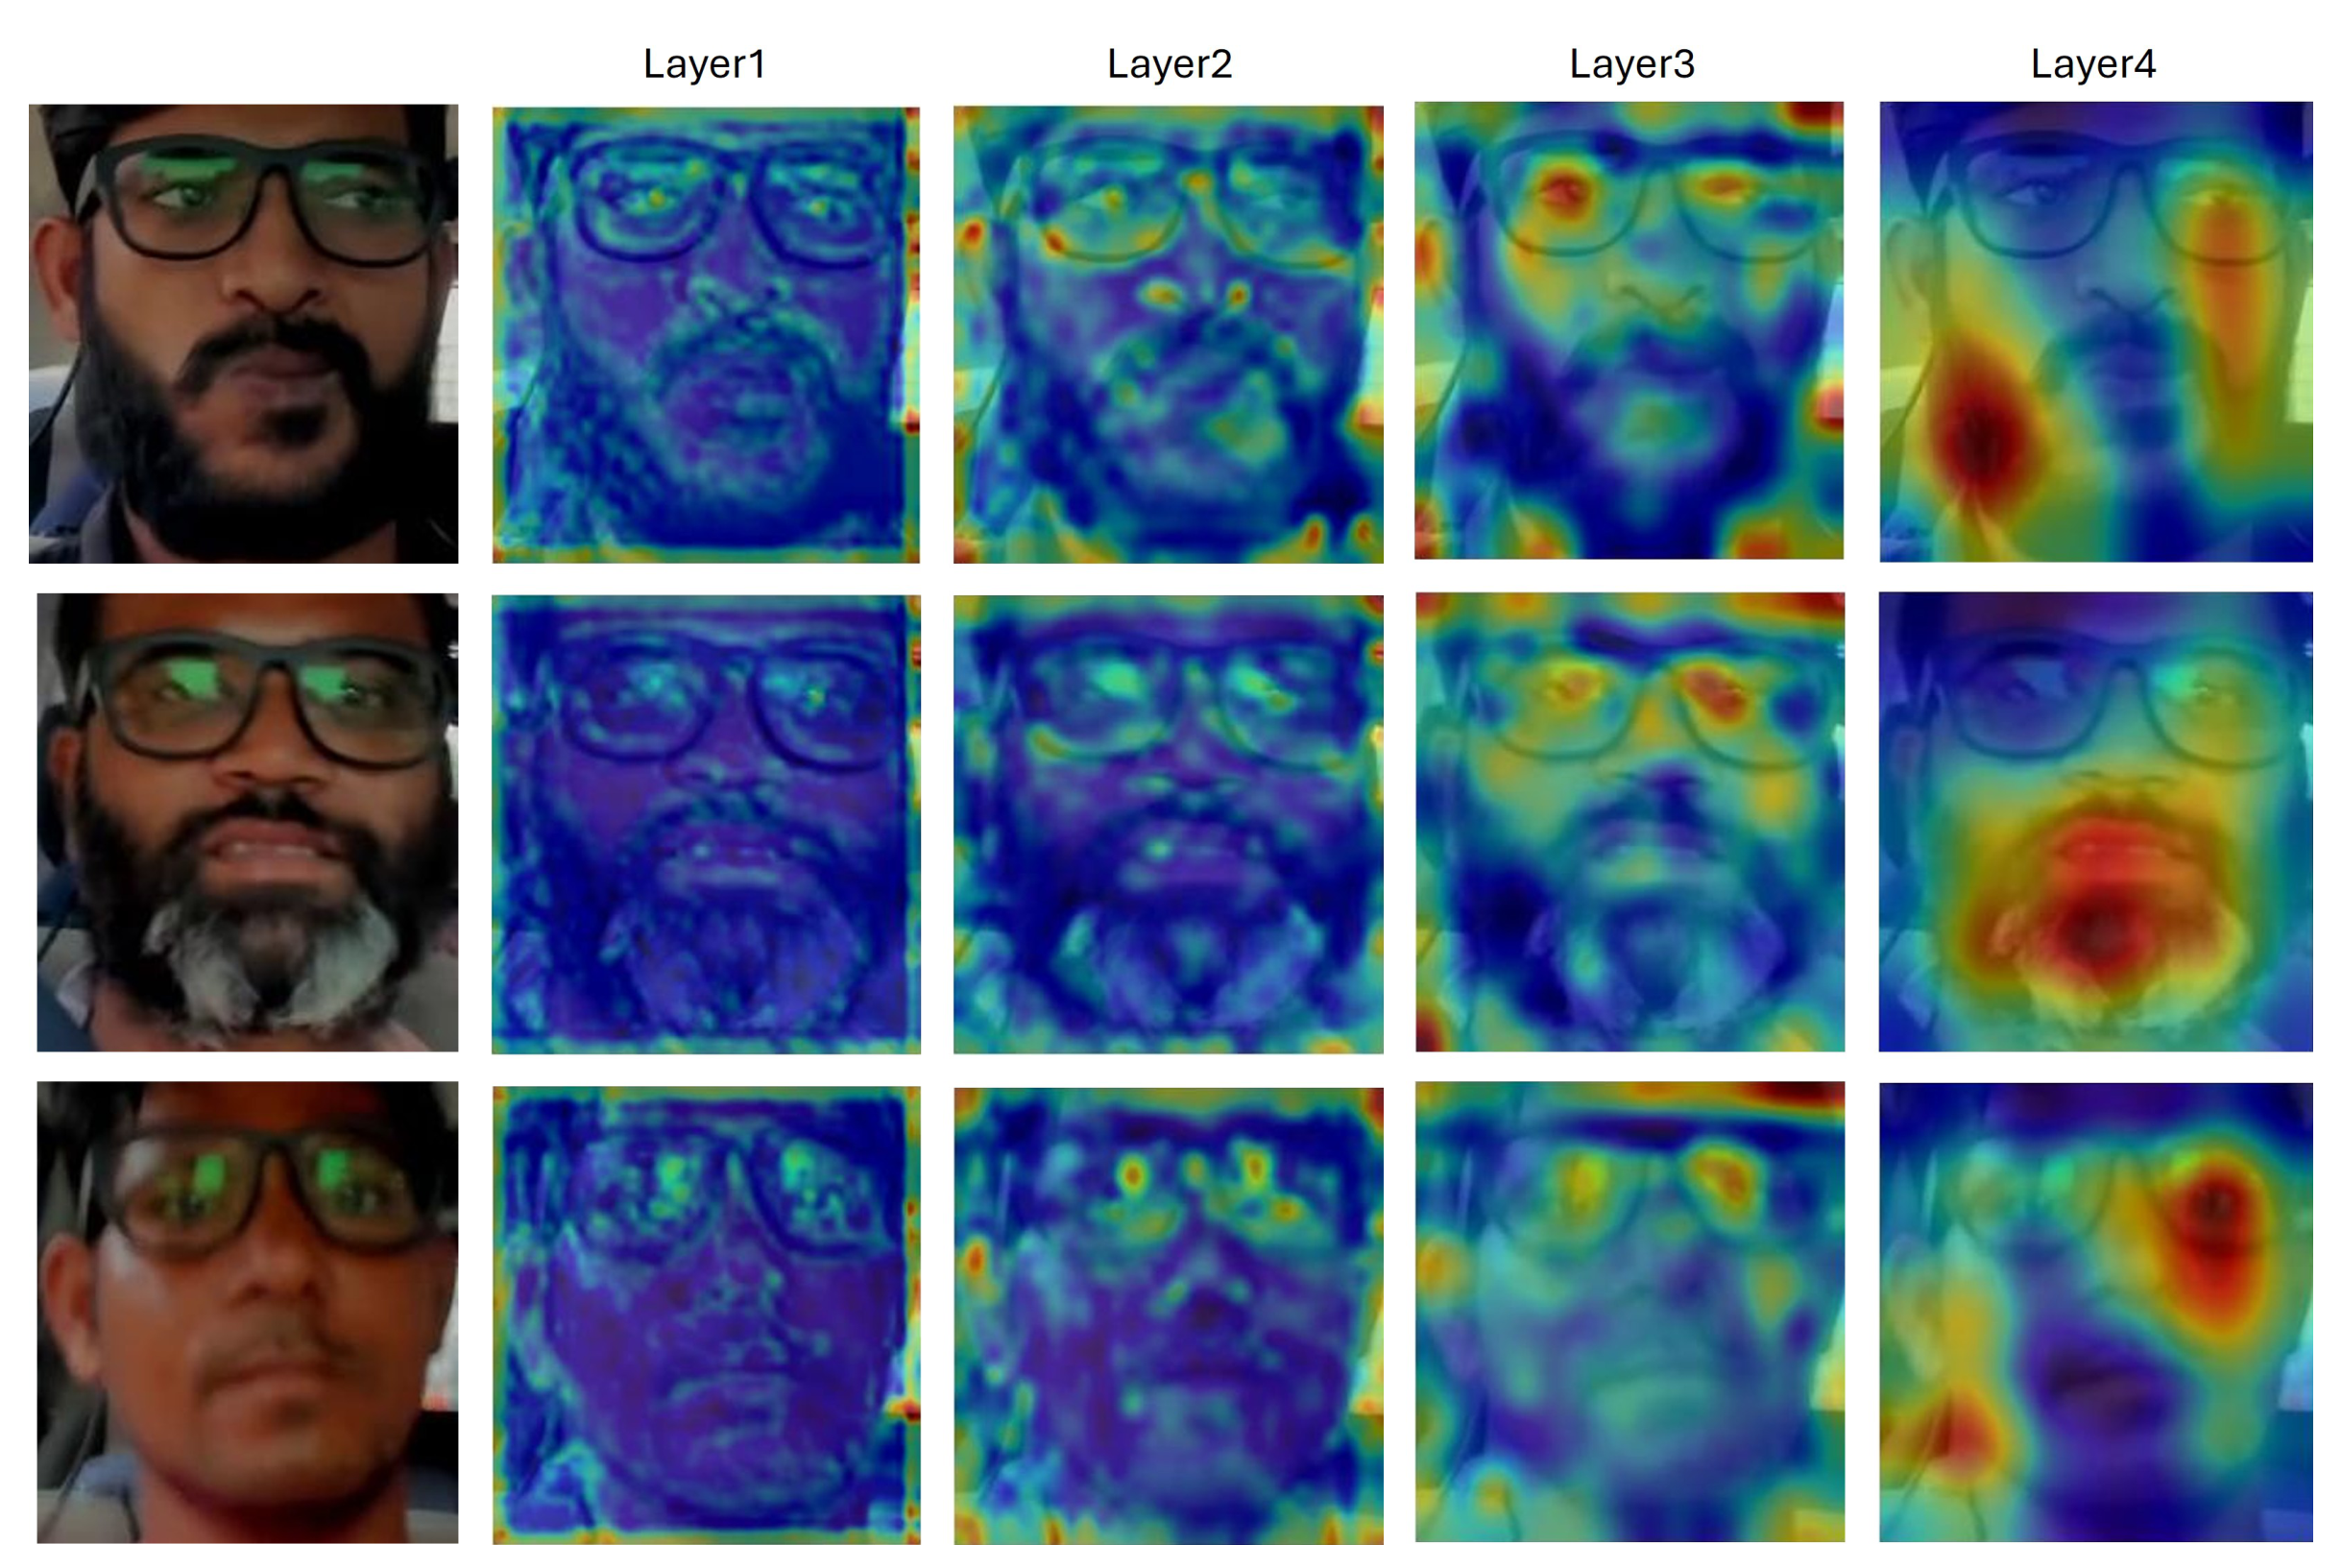
面部特征与眼部特征作为注视方向的线索,用于与场景图像中的场景目标计算相似度。从面部提取的特征表示为 f1, f2, f3, f4 ∈ ℝ256,眼部特征表示为 eL, eR ∈ ℝ256。从 ResNet-18 不同阶段提取的四个面部特征表示面部几何的局部与全局特征,从 ResNet-18 第 4 阶段(层 4)提取的两个眼部特征表示眼部的全局特征。合并面部与眼部特征,面部特征集合定义为:
最终共 6 个 token(Tf = 6)表示面部特征(四个面部特征来自 ResNet-18 的不同阶段 / 层,表示面部几何的局部与全局特征;两个眼部特征来自第 4 阶段 / 层 4,表示眼部的全局特征)。
如 3.1.6 节所述,数据分析显示约 99.78% 的帧包含 20 个及以下的目标(交通目标与背景),如图 5 所示。因此,每个场景表示为固定的 N + 1 = 20 个目标的集合,包含最多 19 个交通目标和 1 个背景目标。交通目标数 > N = 19 的图像中的目标通常非常小(因为目标离驾驶员很远)。因此,对目标数 > 19 的图像,取按面积计最大的 19 个目标。
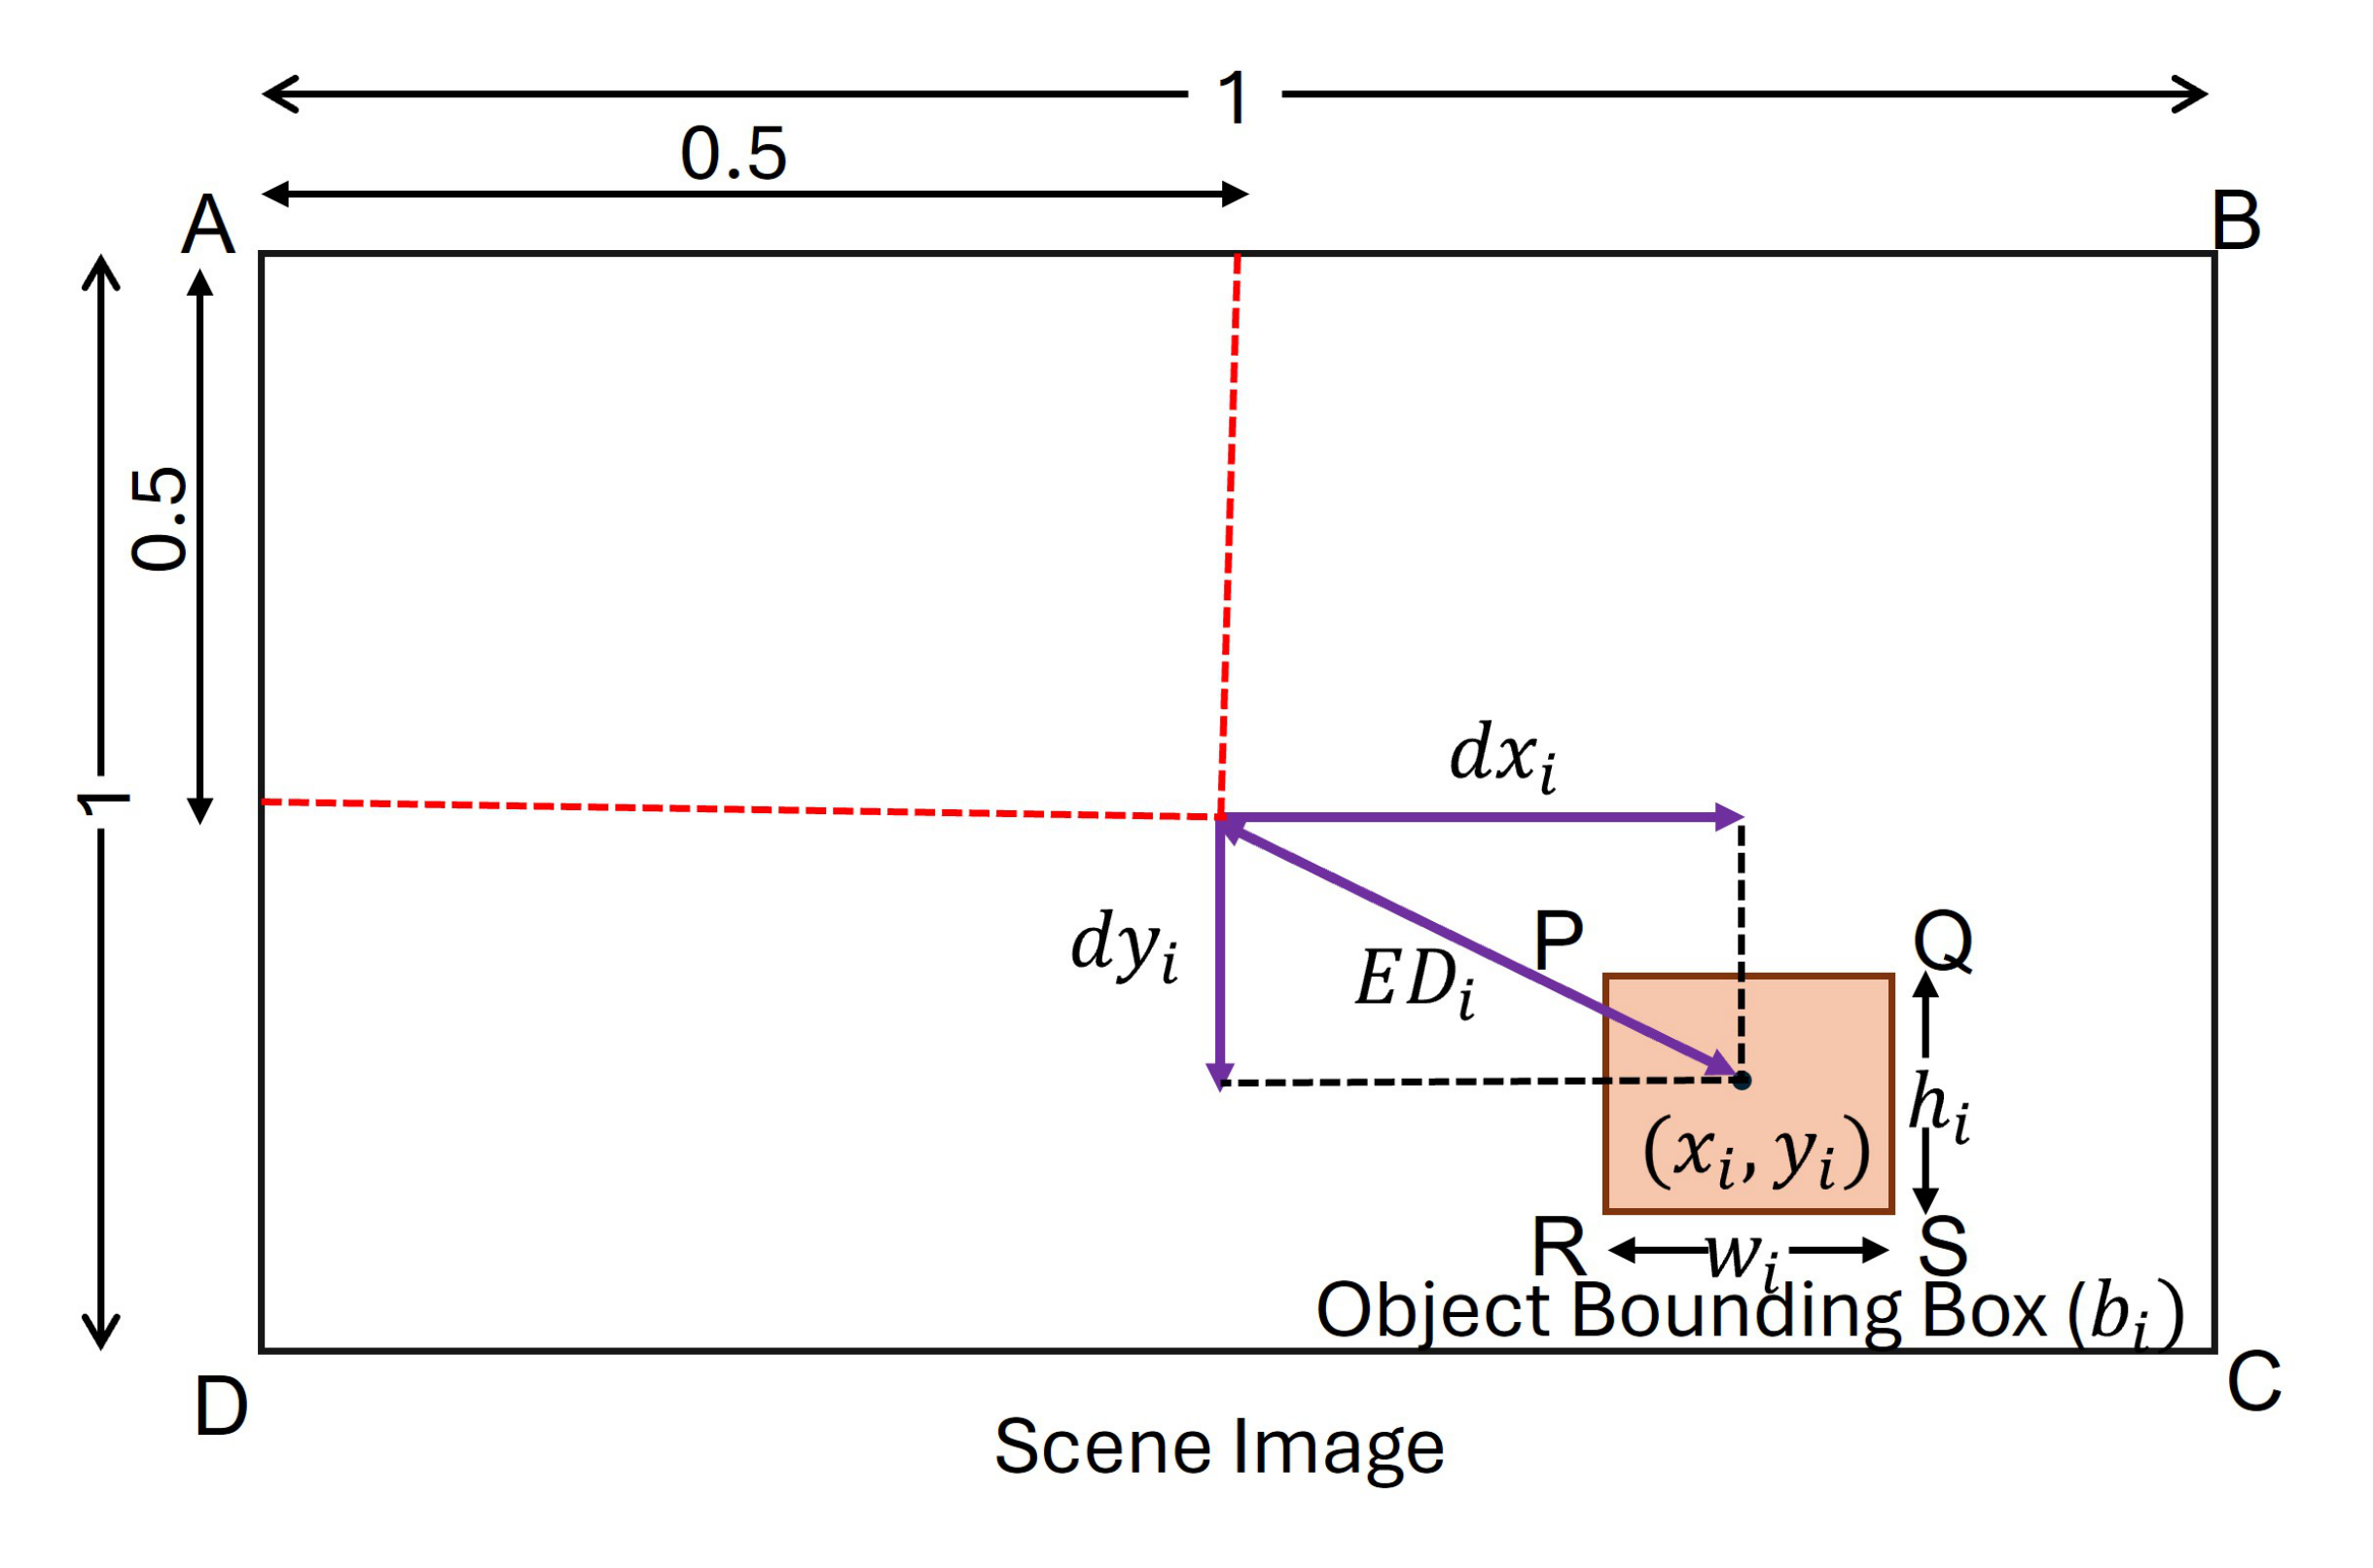
图 12 示意了为检测到的场景目标提取的空间特征。矩形 ABCD 表示完整场景图像,橙色矩形 PQRS 表示目标边界框 bi。点 (xi, yi) 表示目标边界框的归一化中心坐标,xi、yi 分别为水平与垂直中心坐标。边界框的归一化宽与高记作 wi、hi。主要的目标特征是目标边界框的位置,表示为:
为丰富目标表示,每个边界框再附加空间特征。首先计算每个目标的面积 ai = wi · hi。为捕捉位置偏置,计算相对场景图像中心 (0.5, 0.5) 的偏移量与欧氏距离:dxi = xi − 0.5、dyi = yi − 0.5,EDi = √(dxi² + dyi²)。dxi、dyi 和 EDi 的计算方式见图 12。据此,第 i 个目标的空间特征表示为:
该表示不仅编码目标的尺寸,还编码其相对图像中心的位置——这一点很关键,因为人的注视常表现出中心偏置(center bias),即驾驶员主要看前方,且场景相机放置在仪表盘中央。
空间特征用线性变换投影到更高维的嵌入空间:
其中 siobj ∈ ℝ8 表示空间特征向量,Ws ∈ ℝ8×d 与 bs 为可学习权重矩阵与偏置项。
为把背景与有效交通目标边界框区分开,给背景指定固定的空间表示 [−1, −1, 2, 2]。这些超出范围的坐标与尺寸为背景提供了独特的空间表示,并在所有场景图像间保持一致。背景的其余空间特征按与交通目标相同的方式计算。因此,背景的最终空间特征向量为 (−1, −1, 2, 2, 4, −1.5, −1.5, 2.12),在所有场景图像间固定不变。
最终,场景由所有目标(N+1 = 20)的特征组合表示:
这一投影有两个关键作用:第一,把空间特征对齐到面部特征的嵌入维度,使其能通过注意力机制有效交互;第二,让模型学习任务特定的空间属性组合(目标位置、尺寸、距离等)。
所提出的基于 Transformer 的注视目标(TransGaze-Object)预测模型基于如下假设:准确的驾驶员注视目标预测需要联合建模驾驶员面部线索与周围场景目标。多层面部特征用独立的预训练 ResNet-18 网络从面部和虹膜加权眼区提取,而检测到的场景目标的空间与几何特征独立表示。场景目标的空间与几何特征随后用多层感知机(MLP)变换到嵌入维度 d,保证与面部特征表示维度兼容,以便后续基于注意力的融合。由于这些特征是分别提取的,它们本身不携带各自特征集内部的关联关系。因此,使用两个独立的 Transformer 编码器块(分别对应面部特征与场景特征)通过自注意力学习面部特征内部、以及场景目标特征内部的上下文依赖,通过捕捉每套特征内部的交互生成增强的特征表示。
在得到上下文化的面部与场景目标表示后,模型采用交叉注意力机制建立驾驶员注视线索与周围场景目标之间的关系。该框架中,编码后的面部特征作为查询,编码后的场景目标特征作为键。这一设计的动机是:面部特征编码驾驶员的视觉意图,而场景目标代表潜在的注视目标。查询-键匹配机制使模型能识别其表示与驾驶员注视特征最匹配的目标,所得注意力得分用于预测最可能的注视目标。这一交叉注意力形式化构成 TransGaze-Object 模型的核心贡献,有效整合驾驶员外观与场景上下文以稳健地预测注视目标。
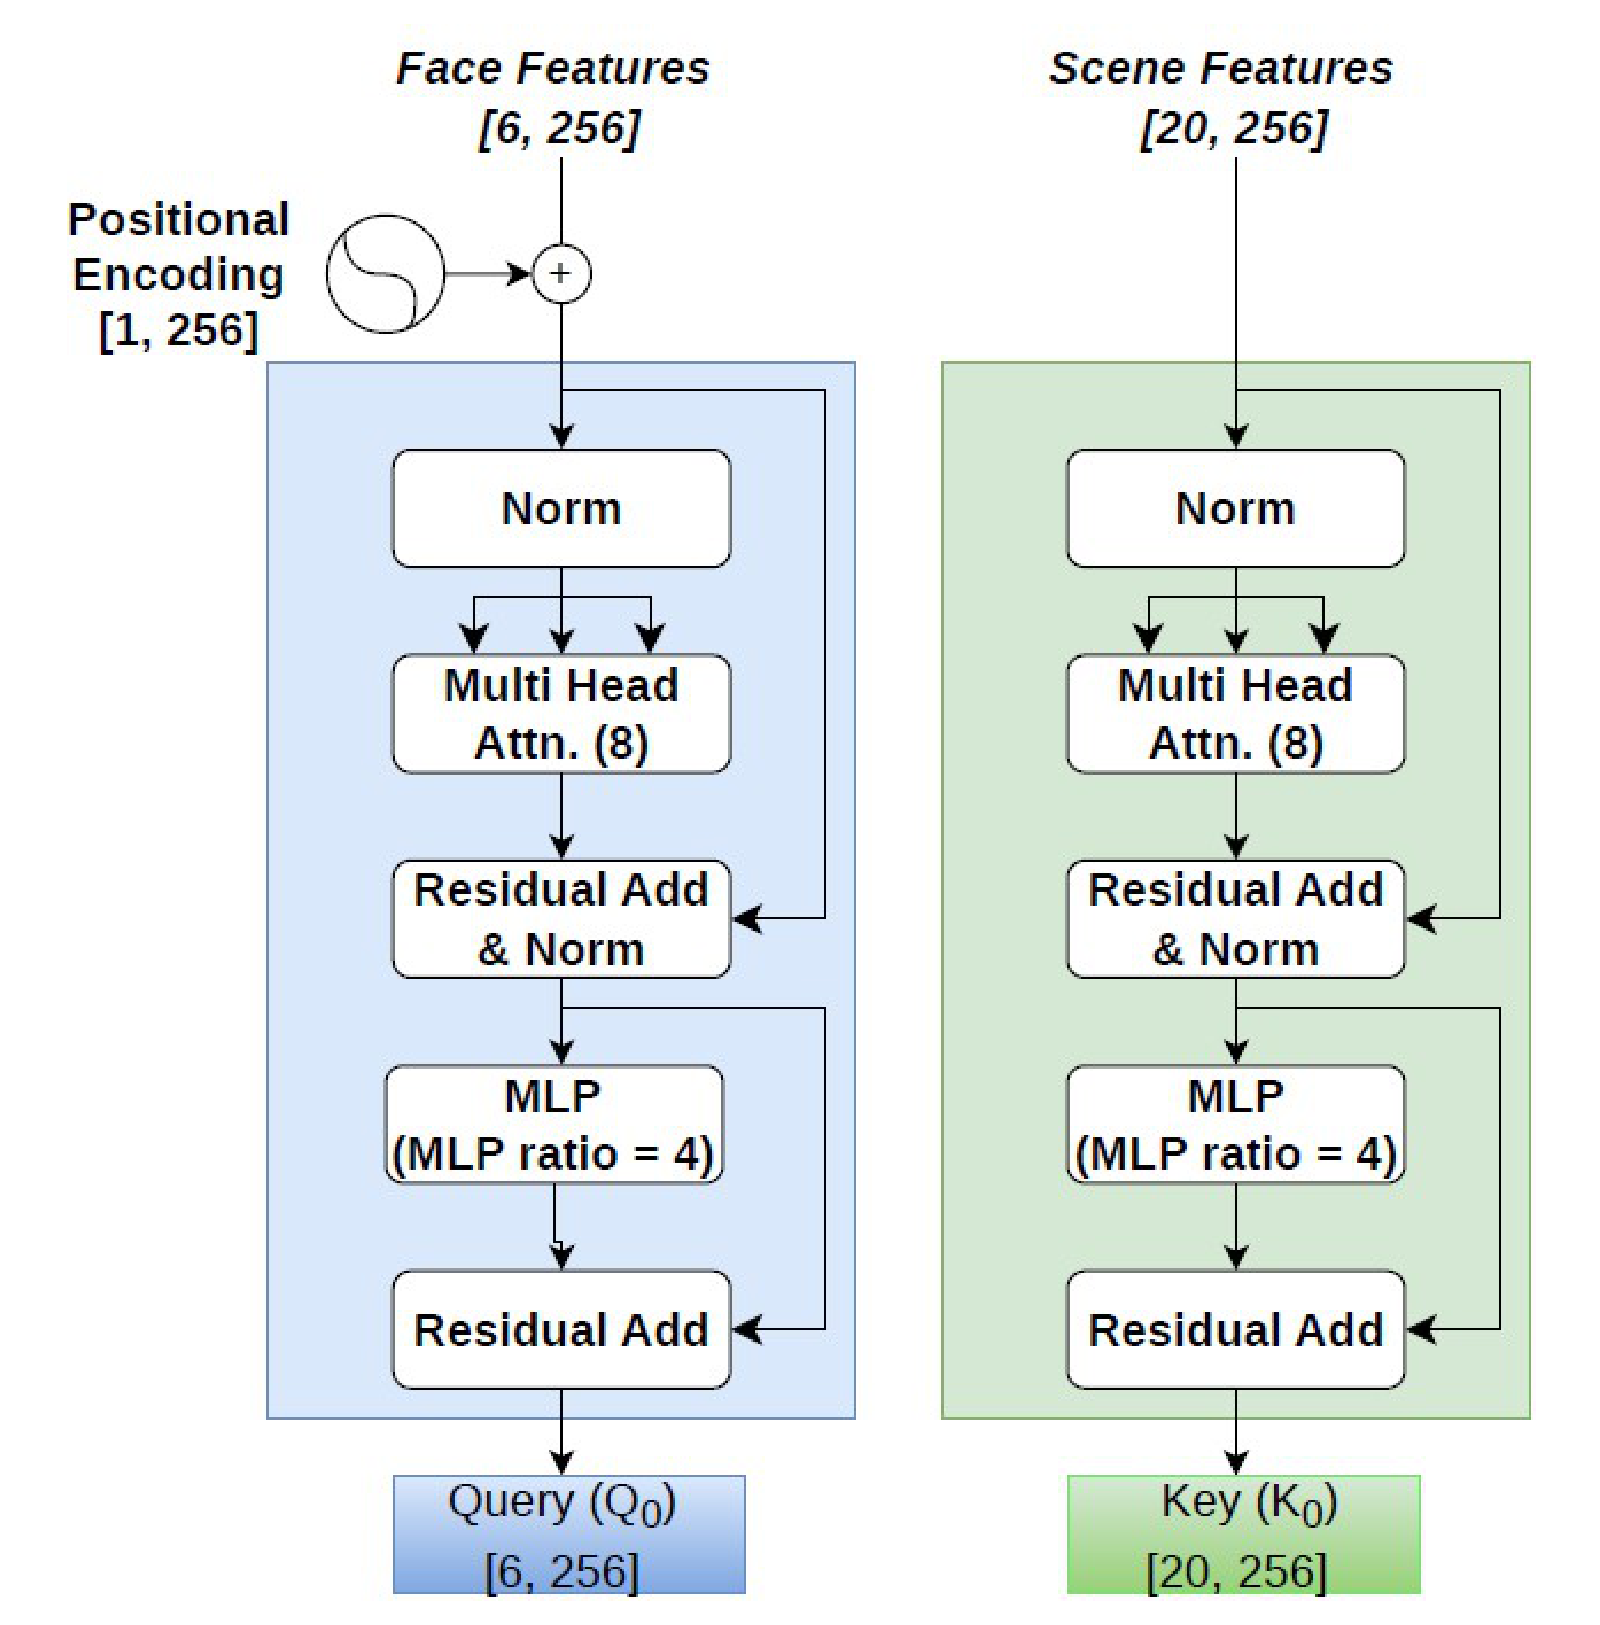
式 (14) 给出的面部特征 F 与式 (18) 给出的场景特征 Sobj 包含从面部与场景目标独立提取的原始特征,彼此没有上下文关联。由于注视估计本质上是上下文相关的问题——注视方向并非由单一面部区域决定,而是由眼部朝向、头部姿态、整体面部几何等多种线索的交互产生;同样,场景目标也不是独立的,它们的空间排布与相对重要性影响其成为注视目标的可能性——为捕捉这种上下文关系,把面部与场景特征分别通过两个独立的标准 Transformer 编码器块(Vaswani et al., 2017)。这些编码器块的流程见图 13。面部与场景特征的编码器块输出分别作为查询和键。
直接使用原始特征的局限:若不经编码直接使用原始特征,每个 token 被独立处理,面部区域之间、场景目标之间没有交互。模型因此无法捕捉:(a) 眼区与头部姿态的关系;(b) 场景中多个目标之间的交互。
Transformer 编码器的作用:Transformer 编码器通过自注意力解决这一局限,每个 token 通过关注其他所有 token 得到更新。面部与场景的更新特征如下:
其中 αij、βij 为注意力权重。该机制实现:(a) 每个面部 token(含 4 个面部 token 与 2 个眼部 token)纳入其他所有面部区域的信息;(b) 每个目标特征捕捉与其他目标的上下文关系。
面部特征编码:对面部特征,自注意力让模型学习如下依赖:(a) 左右眼特征的对齐;(b) 头部朝向对注视方向的影响;(c) 全局面部结构。由此得到上下文感知的注视线索表示。
场景特征编码:对场景特征,自注意力实现:(a) 目标间空间关系建模;(b) 目标分组与相对重要性理解;(c) 复杂驾驶环境中的上下文交互捕捉。
面部与场景的编码特征表示为:
其中 q0,1, q0,2, …, q0,Tf 表示查询向量 Q0 的元素,k0,1, k0,2, …, k0,N+1 表示键向量 K0 的元素。
从 Transformer 编码器得到编码表示 Q0 与 K0 后,再用线性投影层生成查询与键矩阵,定义如下:
虽然编码器输出捕捉了驾驶员面部特征与场景特征内部的丰富上下文信息,但它们本身并未针对「面部注视线索与场景目标」的跨模态匹配做优化。投影步骤把编码特征变换到任务特定的嵌入空间,在该空间中可通过点积注意力有效计算相似度。特别地,投影矩阵 Wq 与 Wk 学习如何调整特征表示方向,使面部特征中的注视相关模式与场景中对应的目标特征对齐。因此,注意力得分可解释为一个学到的相似度函数,而非原始特征间的简单点积。这一变换有助于提升模型的判别能力,尤其在视觉相似或空间邻近目标的场景中,从而提高注视目标预测的准确性。
用式 (22) 得到的、来自面部特征的查询 Q 与来自场景目标的键 K 的交互来计算相似度得分。相似度得分用缩放点积注意力机制计算,见式 (23):
其中 S = {si,j} ∈ ℝTf×(N+1) 为注意力得分矩阵,每个元素 si,j 定义为 si,j = qi · kj / √d,qi 与 kj 分别为第 i 个查询向量与第 j 个键向量。
对零填充目标的掩码:场景图像中若检测到的交通目标数少于 19,为保持固定输入尺寸会引入虚拟目标。这些附加目标被视为零填充目标,其对应特征向量的所有元素置零。在注意力得分计算中对这些零填充(虚拟)目标施加掩码:对应这些目标的注意力得分被赋值为 −∞。虚拟目标(填充)用下式掩码:
这样,应用 softmax 函数后这些虚拟目标的注意力权重变为零,确保它们不贡献于最终注意力输出。
注意力权重用温度缩放计算:
为计算注意力权重,在 softmax 操作前对相似度得分施加温度参数 τ = 0.5。这一缩放通过防止过大的值主导 softmax 输出来控制注意力分布的尖锐程度。若不做温度缩放,注意力权重可能过度尖锐,导致梯度不稳定、泛化差。引入温度参数后,模型可以控制注意力在目标间的分散程度——帮助模型更聚焦于最重要的目标,同时仍考虑其他可能目标,提升模型的学习稳定性。
面部-眼部注意力融合:注意力权重被分离为面部与眼部两个分量,因为驾驶员注视既取决于头部朝向,也取决于虹膜在眼内的位置(即眼动)。眼部特征提供注视方向的精确信息但对噪声和遮挡敏感;面部特征捕捉头部朝向,提供更稳定但较粗糙的注视方向线索。通过分离面部与眼部注意力权重,模型既能学习细粒度的眼部信息,又通过面部上下文保持稳健性。
最终注意力权重是眼部与面部分量在目标上注意力权重的加权组合,可学习参数 λ 决定各分量的贡献:
λ 值越大,模型给眼部分量越多权重,反之亦然。最终注意力权重矩阵 Afinal 表示模型对场景中每个目标的关注程度,定义为:
其中 ai ∈ [0, 1] 为第 i 个目标对应的注意力权重,Σi=1N+1 ai = 1。在分别来自面部特征与场景特征的查询和键之间计算完注意力权重后,接下来计算目标索引 id,详见下一节。
最终注意力权重矩阵用于计算注视目标:注意力权重最高的目标被视为注视目标(即驾驶员正在看的目标)。数学形式为:
其中 ŷ 表示预测的注视目标,即注意力权重最高的目标的索引,ŷ ∈ {1, 2, …, N + 1}。
为有效训练所提注视估计模型,采用多个损失分量引导学习的不同方面,包括分类准确性、注意力对齐、一致性以及相似目标间的判别性。各损失分量详述如下。
分类损失:首要目标是在 N 个交通目标与背景中正确估计注视目标。这被形式化为多分类问题,使用交叉熵损失:
其中 aj 为第 j 个目标的估计注意力权重,ay 为真值目标的注意力权重。分类损失保证模型给正确目标最高概率,是注视目标预测的主要监督信号。
一致性损失:为保持眼部与面部注意力的连贯性,引入一致性约束:
其中 α = 0.03。它强制眼部注意力与面部注意力保持一致,减少不一致的预测,让模型自动平衡眼部与面部分量的贡献,避免手工调参并改善优化。
混淆感知注意力损失:在复杂驾驶场景中,多个交通目标常常彼此靠近,注视目标预测天然存在歧义。传统 one-hot 监督对所有错误目标一视同仁,从而对那些更可能与真值注视目标混淆的邻近目标过度惩罚。因此引入混淆感知监督策略,显式建模这种空间歧义。所提方法基于真值目标与所有其他检测目标之间的空间距离构建软目标分布,给邻近目标更高概率;把这一距离感知分布与 one-hot 真值标签组合,用 KL 散度(Kullback & Leibler, 1951)优化预测的眼部注意力分布,在保持对正确注视目标强监督的同时学习空间感知的注意力。
目标间距离用其中心坐标的欧氏距离计算。具体地,对第 i 个目标,其到真值目标的距离定义为:
其中 (xi, yi) 与 (xgt, ygt) 分别为第 i 个目标与真值目标的中心坐标。用对负距离的 softmax 把它转换为概率分布:
其中 pi 为第 i 个目标关联的概率,γ 为控制所得概率分布尖锐度的缩放超参数。γ 越大,离注视点更近的目标获得越高概率。
最终目标分布为:
其中 y 为真值目标索引,y ∈ {1, 2, …, N + 1}。混淆感知注意力损失按下式计算:
KL 散度用于度量预测注意力分布与目标分布的差异,其中 gj 为分配给第 j 个目标的真值概率,Aeye,j 为第 j 个目标的预测注意力权重。N + 1 为场景中目标总数。最小化该散度促使预测注意力分布与目标分布紧密对齐。
困难负样本间隔损失:虽然混淆感知注意力损失鼓励模型给真值目标及其邻近目标更高注意力,但它没有显式强制真值目标与最容易混淆的错误目标之间保持足够分离。在驾驶员注视目标预测中,这些易混淆目标(称为困难负样本,hard negatives)指虽非真值目标却获得高注意力得分的那些目标。为降低这种歧义,引入基于间隔的损失,显式增大真值目标注意力得分与最难负样本注意力得分之间的差距。训练时选取注意力得分最高的 top-k 个非真值目标作为困难负样本,然后鼓励模型在分配给真值目标的注意力与这些困难负样本的平均注意力之间保持预定义间隔,从而改善判别学习。
其中 agt 为真值目标对应的注意力权重,aneg 为 top-k(本文 k=2)个最难负样本的平均注意力权重,m = 0.5 为要求的两者最小差值。
只有当真值目标注意力与困难负样本注意力之差小于预定义间隔 m 时,间隔损失才激活;此时损失惩罚模型,促使其增大真值目标的注意力、抑制竞争性困难负样本的注意力。一旦达到所需间隔,损失变为零,避免不必要的优化。由此模型学到更具判别性的注意力表示,减少真值注视目标与视觉或空间相似目标之间的混淆,同时提升注视目标预测性能。
最终损失:最终损失由分类损失、一致性损失、混淆感知注意力损失和困难负样本间隔损失组成,共同有效训练所提注视估计模型:
一致性损失与混淆感知注意力损失捕捉所提注视估计框架的不同侧面,训练期间可能表现出不同的优化特性。给这些损失项分配固定权重需要手工调参,且未必在整个训练过程中提供最优平衡。因此采用基于不确定性的加权策略,各项损失的贡献通过可学习的不确定性参数 σ1、σ2 自动确定。
每个损失项乘以指数因子 e−σ1 / e−σ2:不确定性更高的损失权重更低,更可靠的损失贡献更强。但若只用加权项 e−σ1Lcons / e−σ2Lattn,优化会平凡地增大 σ1 / σ2,把对应损失权重推向零,等于把这些损失项从训练目标中移除。为避免这种退化解,每个不确定性参数附带额外的正则项 +σ1 / +σ2,惩罚过大的不确定性值,迫使优化在「降低加权损失」与「保持不确定性有界」之间学到合适的折中。
模型用准确率评估,准确率定义为估计注视目标索引与真值索引一致的样本占比。形式上,对含 M 个测试样本的数据集,准确率计算为
其中 yi 与 ŷi 为第 i 个样本的真值与预测注视目标索引,𝕀(·) 为指示函数。
所提模型用 PyTorch 框架在配有 4 块 NVIDIA GeForce RTX 3080 GPU(各 10 GB VRAM)和 CUDA 11.4 的 GPU 服务器上训练。训练、验证、测试所用数据细节见第 2 节的表 2,分别为 165,969、9,208 和 14,673 张图像。模型用 AdamW 优化器优化,初始学习率 1 × 10⁻⁵,并使用权重衰减以改善泛化;采用余弦退火学习率调度器在训练中逐步降低学习率,保证稳定收敛;以 64 的 mini-batch 训练,并施加最大范数 1.0 的梯度裁剪以防止梯度爆炸。
本节先评估所提基于 Transformer 的注视目标(TransGaze-Object)预测模型的性能;然后把我们的结果与现有最先进的注视点估计模型 SGAP-Gaze(Sharma & Chakraborty, 2026)通过后处理把注视点关联到目标边界框进行对比;最后讨论所提模型错误注视目标预测的分析。
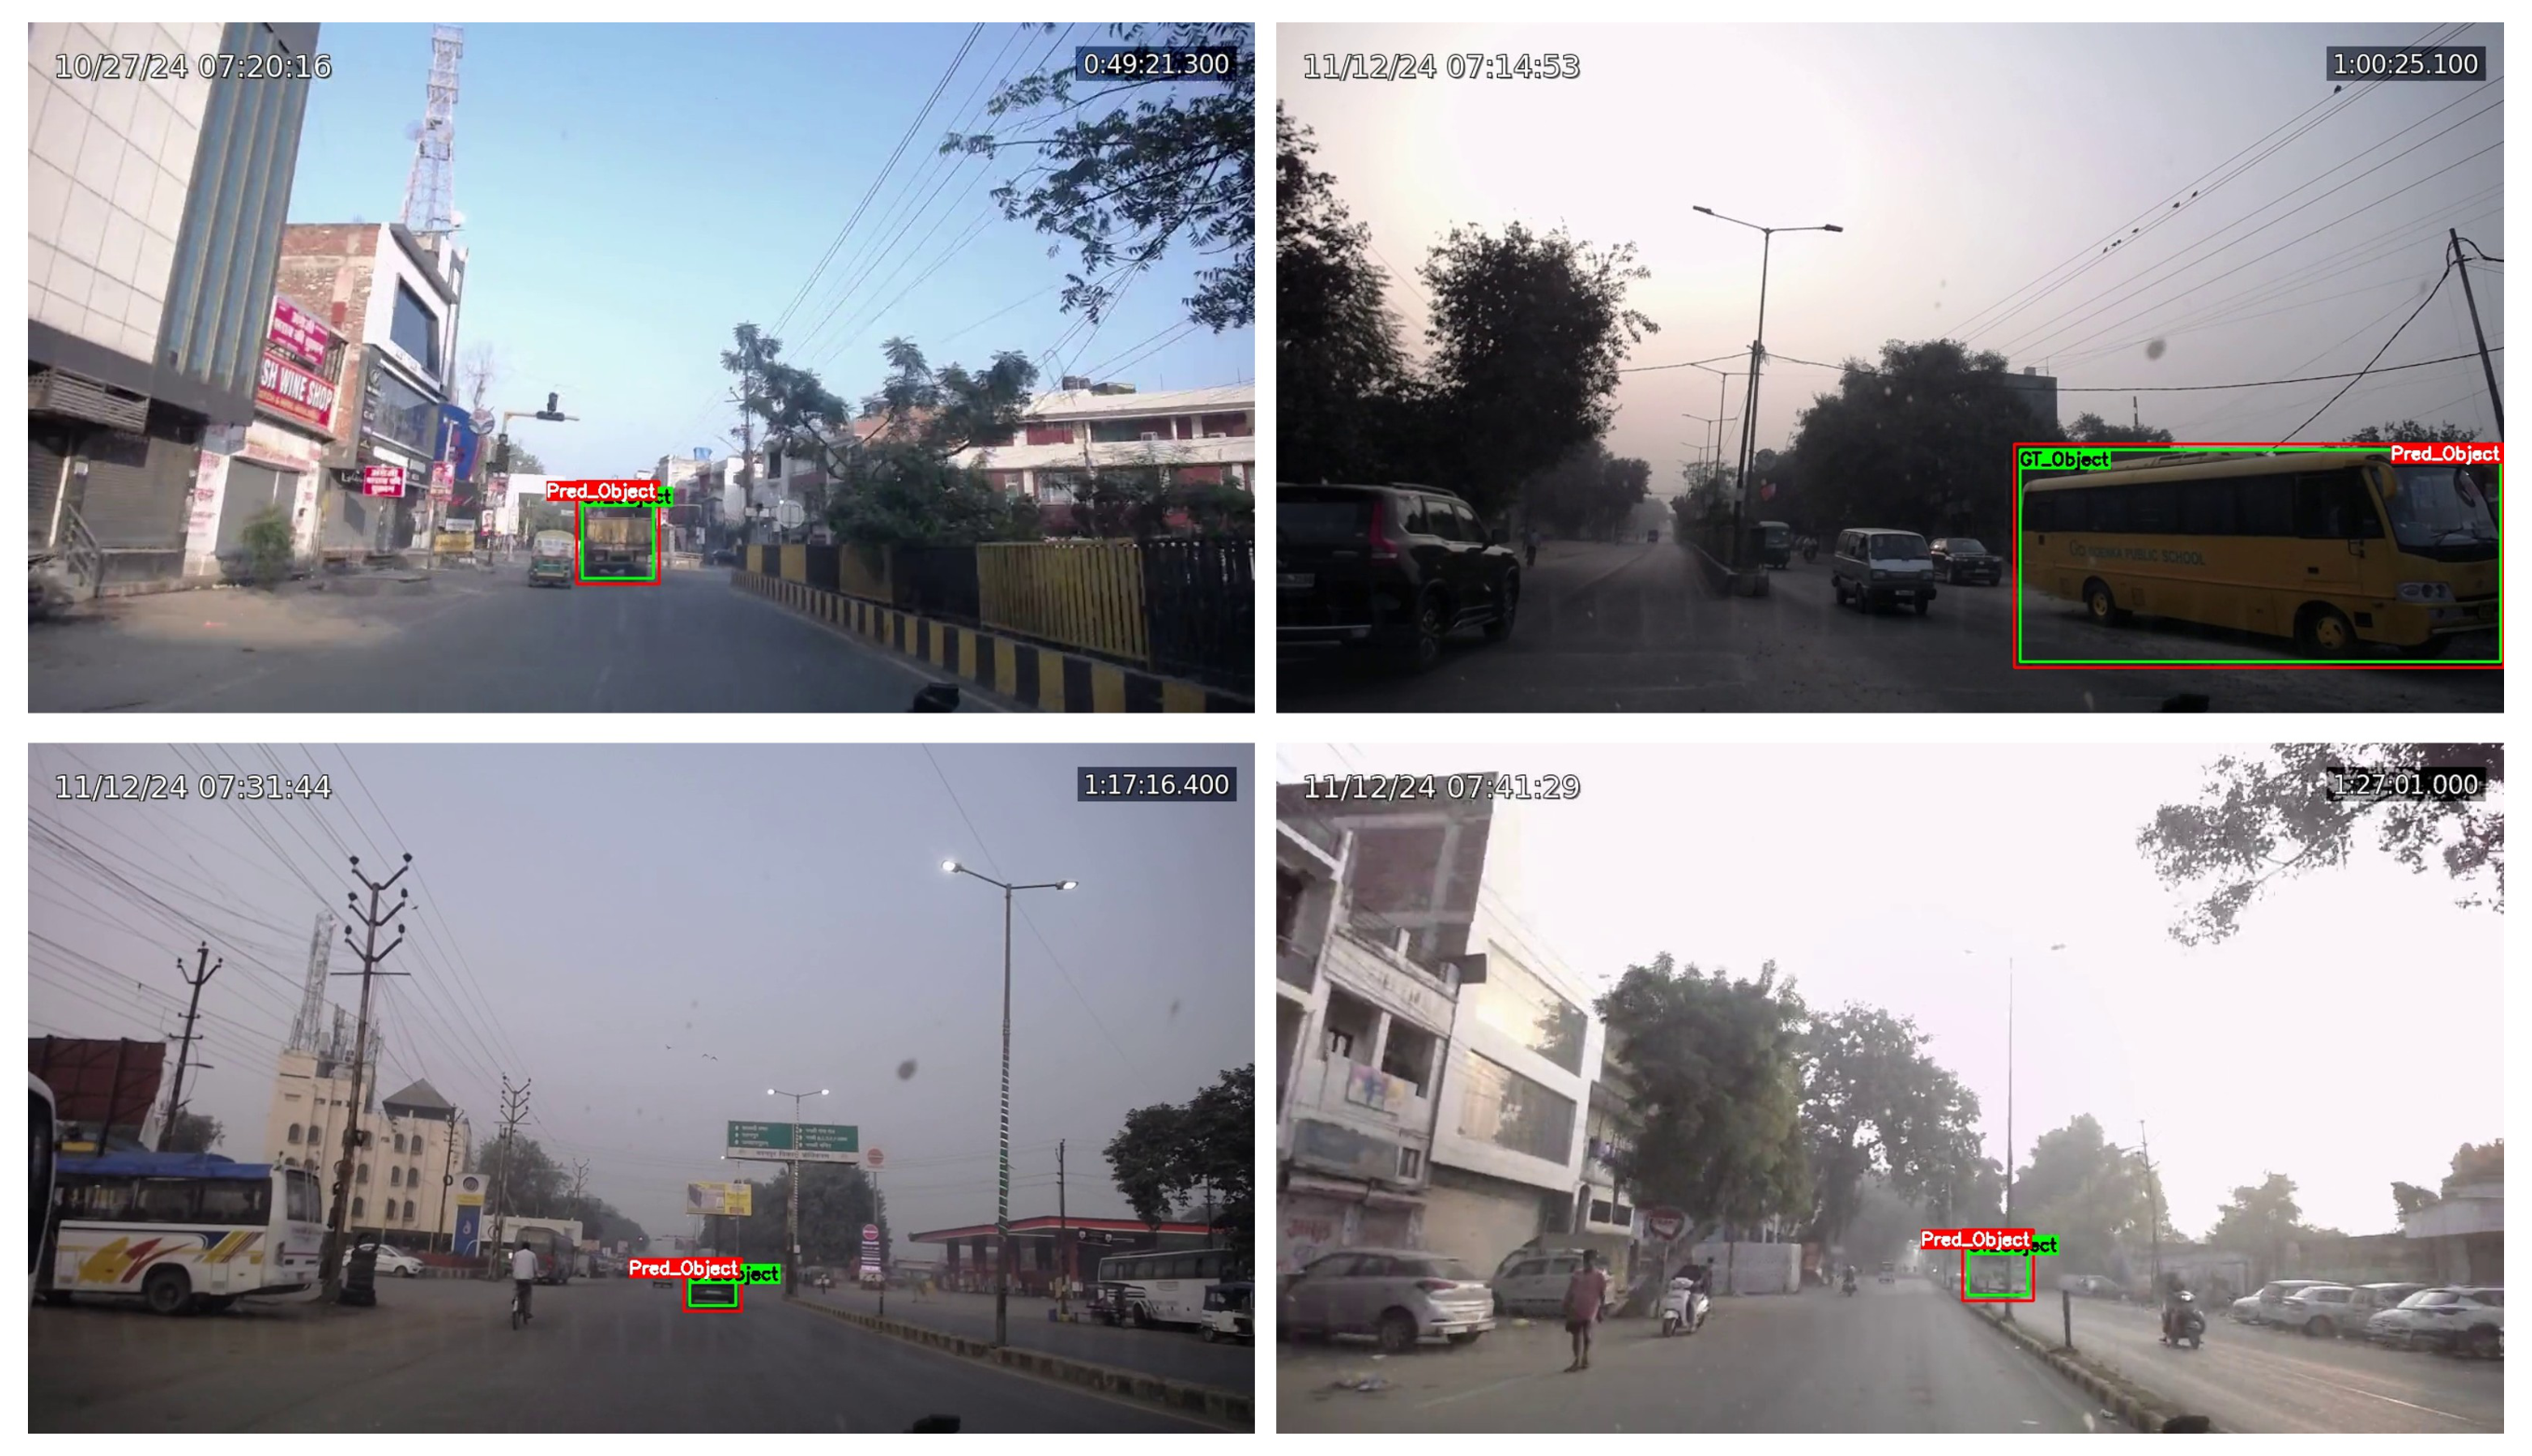
模型在 3 名不同驾驶员的 14,673 个测试样本上评估,测试数据与训练、验证所用数据完全不同。模型对 14,673 个测试样本预测注视目标,其中 8,723 个预测正确,总体注视目标预测准确率为 59.45%(按 4.5.3 节式计算)。正确预测注视目标的代表性测试样本见图 14:每个样本中红色与绿色边界框分别表示预测与真值注视目标;由于预测正确,两个边界框对应同一交通目标。
所提 TransGaze-Object 预测模型与 PoG 模型的对比方式是:把估计的注视点与目标边界框关联。请注意,据作者所知,文献中尚不存在能直接以目标形式表示注视的注视目标预测模型。因此我们用我们先前提出的最先进 PoG 模型 SGAP-Gaze(Sharma & Chakraborty, 2026)做对比:通过后处理把注视点与场景图像中检测到的目标边界框关联——若注视点落在某边界框内,则对应目标被指定为注视目标。
为评估性能,SGAP-Gaze 与 TransGaze-Object 两个模型在同一测试数据集上评估。先用 SGAP-Gaze 模型估计测试样本的注视点,再把所得注视点与场景图像中检测目标的边界框关联:若估计的注视点落在某目标边界框内、且该目标为真值目标,则记 1(正确预测的注视目标);否则记 0。通过注视点模型的关联取得 50.98% 的准确率;而所提 TransGaze-Object 模型取得 59.45% 的准确率,相比 SGAP-Gaze 总体提升 8.47%,证实加入边界框信息能提高注视目标预测准确率。不过,我们所提模型的准确率仍然不高——只有约 60% 的注视目标被正确预测。鉴于即使最先进的基于 PoG 的注视目标预测也只取得约 51% 的准确率,这一发现凸显了注视目标预测是一个相当有挑战性的问题——这种挑战性往往不被注视方向估计文献中报告的较小角度误差(约 6°)所反映(Kasahara et al., 2022; Cheng et al., 2024)。接下来,为研究错误预测的可能原因,我们分析注视目标预测错误的贡献因素。
为理解失败案例的可能原因,把预测错误的注视目标分为三组。第一类:预测与真值注视目标都是交通目标,但对应不同的目标 ID。第二类:预测注视目标为背景,而真值为场景中某个交通目标。第三类:预测注视目标为交通目标,而真值为背景。三类失败案例的结果见表 3。
第一类(真值与错误预测的注视目标都是交通目标)中,TransGaze-Object 与 SGAP-Gaze 的表现几乎相同:如表 3 所示,对应错误预测分别为 16.23% 与 16.55%。注意,这些百分比都相对测试样本总数(14,673)计算。
第二类(真值注视目标为交通目标、预测为背景)中,所提 TransGaze-Object 模型表现出显著改进:仅产生 11.68% 的错误预测,而 SGAP-Gaze(PoG 关联到目标)把总测试样本的 23.21% 错误预测为背景。这些结果表明,加入目标级空间信息使所提 TransGaze-Object 模型能更有效地区分交通目标与背景,把这类错误相比 SGAP-Gaze 减少了近一半。
第三类(真值为背景、预测为交通目标)中,TransGaze-Object 的表现略逊于 SGAP-Gaze:对应错误率分别为 12.62% 与 9.24%。这表明,虽然所提模型在减少把交通目标误判为背景注视目标方面更有效,但它把背景误判为交通目标的情况略有增加。不过总体上,TransGaze-Object 模型的性能提升主要来自减少「背景到交通目标」的错误预测(第二类),证明了先验提供边界框信息的有用性。
| 类别 | TransGaze-Object | PoG-目标关联 | ||
|---|---|---|---|---|
| 数量 | 百分比(%) | 数量 | 百分比(%) | |
| 交通目标-交通目标 | 2,382 | 16.23 | 2,429 | 16.55 |
| 交通目标-背景 | 1,715 | 11.68 | 3,407 | 23.21 |
| 背景-交通目标 | 1,853 | 12.62 | 1,357 | 9.24 |
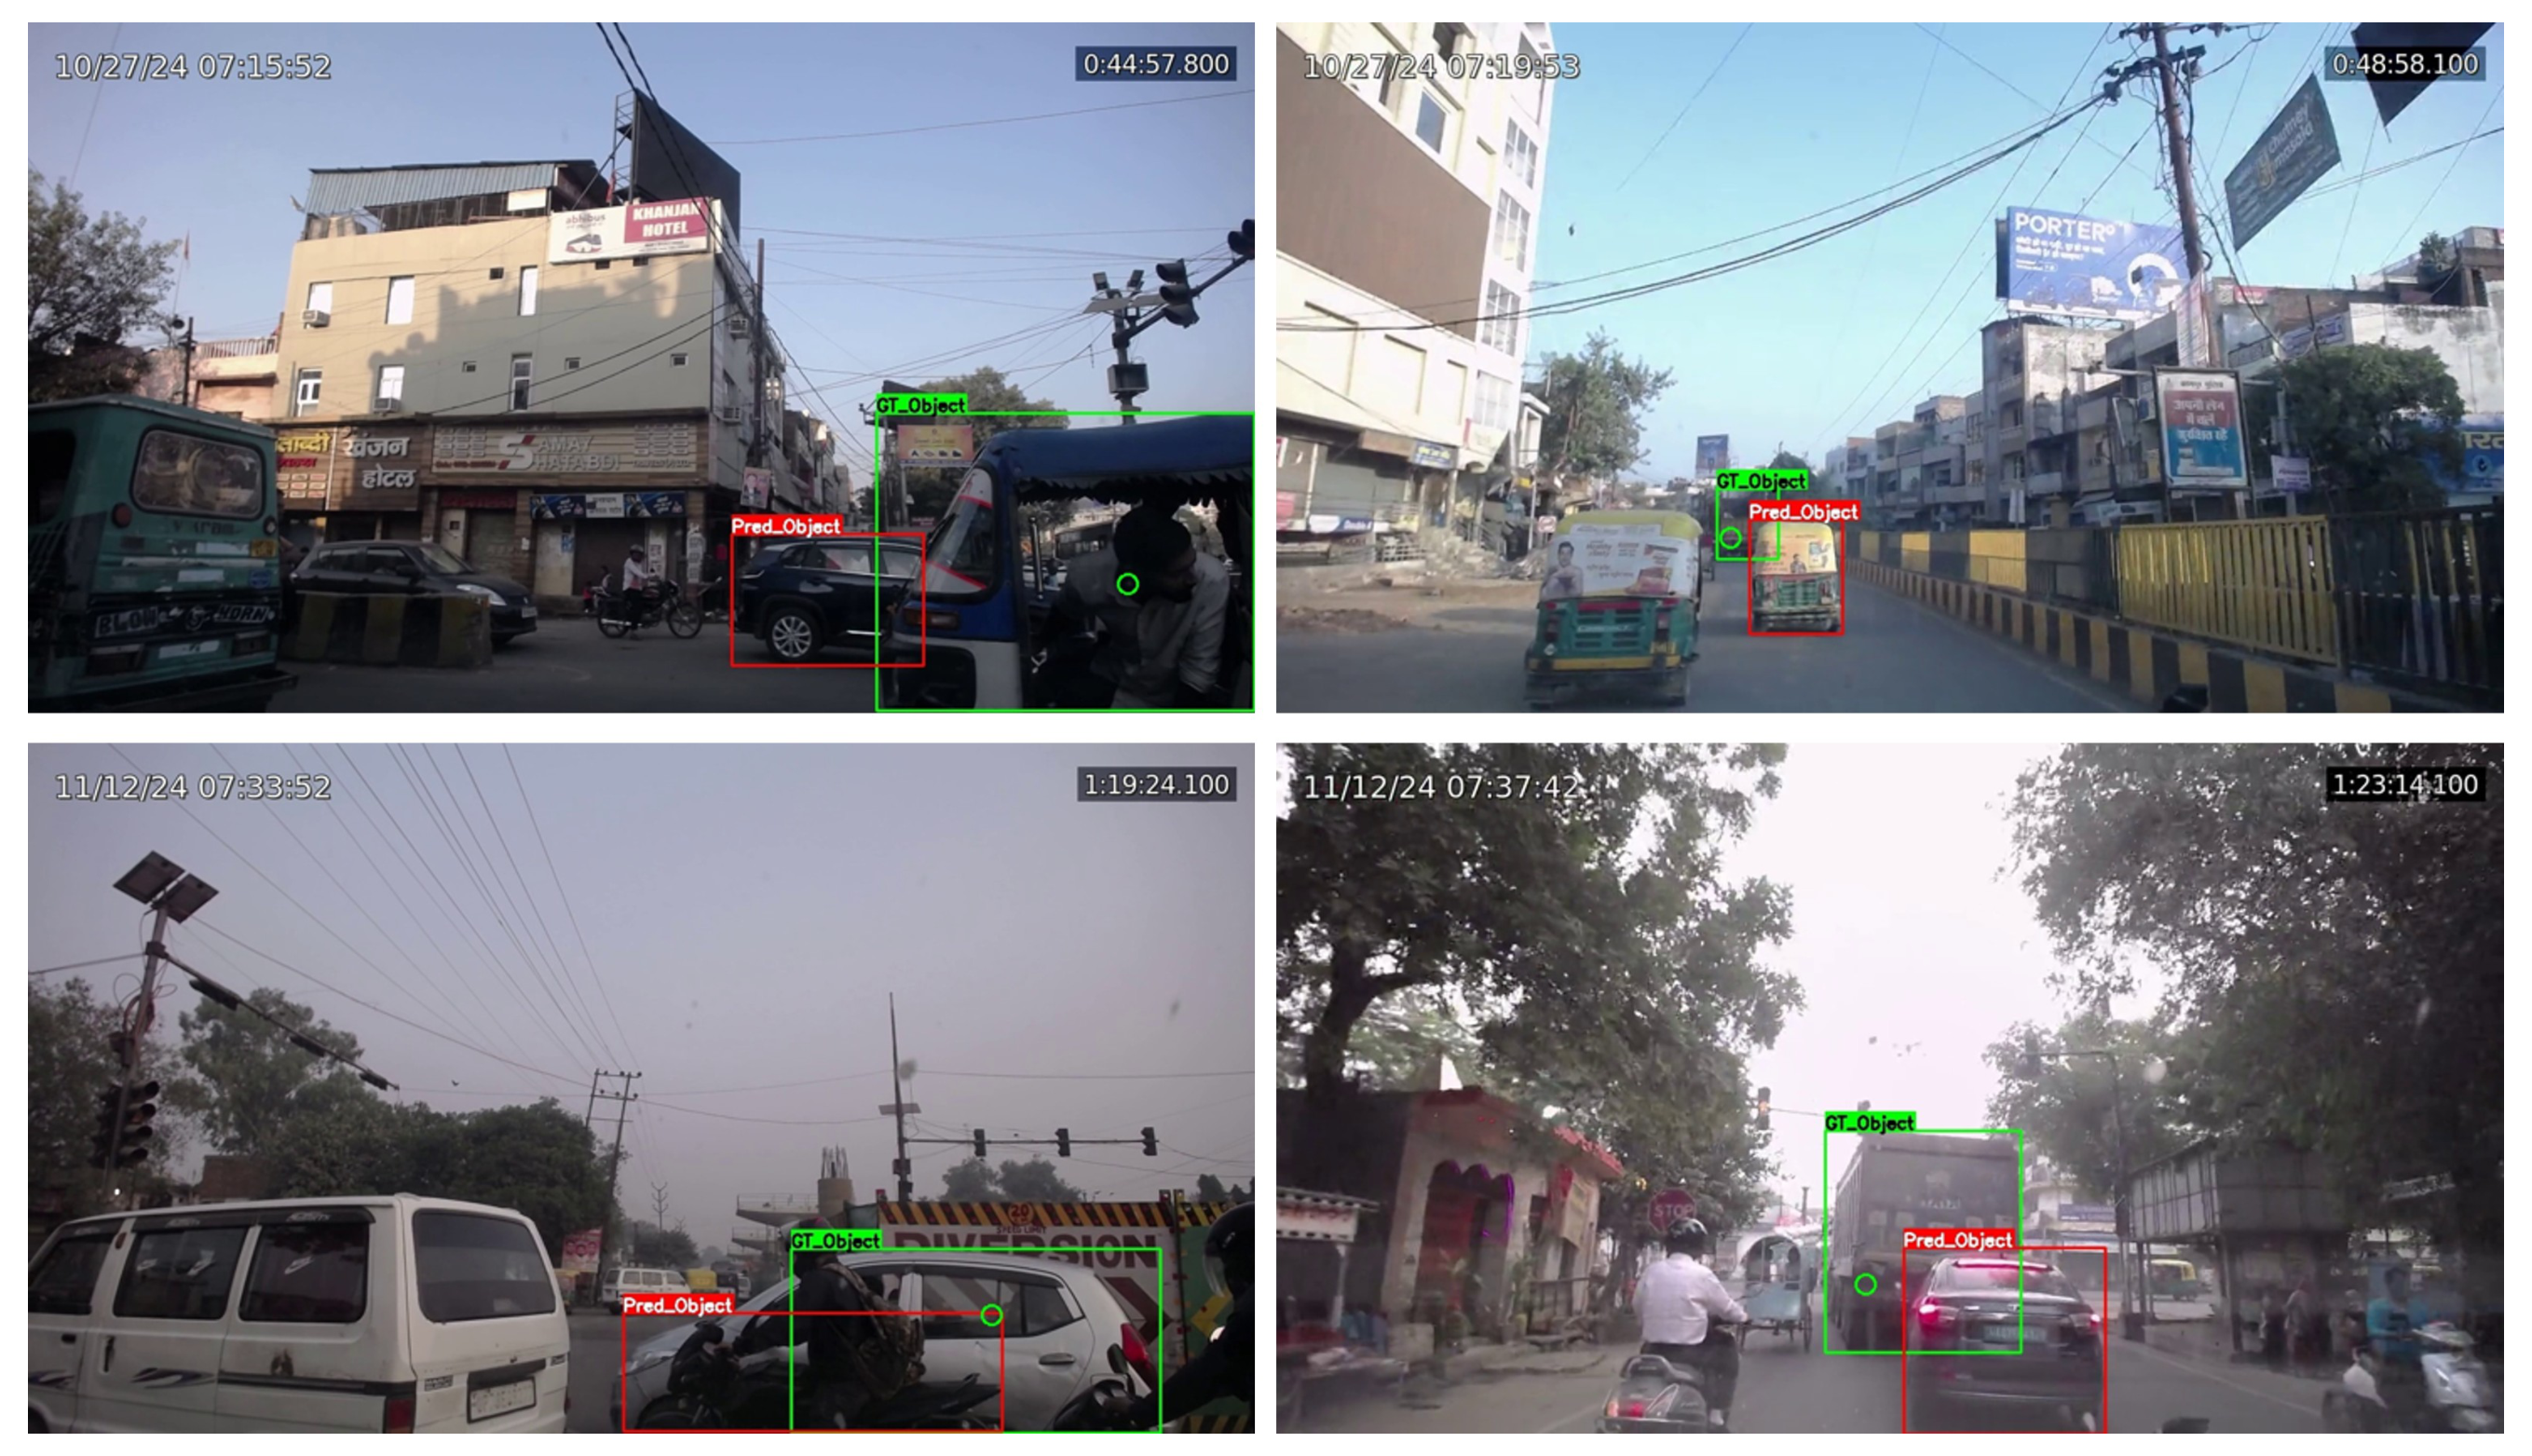
表 4 进一步给出真值与预测目标都是交通目标的错误预测的详细分析。基于真值与预测目标边界框,这些错误预测又被分为「重叠」与「非重叠」两类:若真值与预测边界框有公共面积(即交集非零),视为重叠错误预测,否则为非重叠。如表 4 所示,所提 TransGaze-Object 模型有 353 例(2.40%)重叠的交通目标-交通目标错误注视目标预测,略高于 SGAP-Gaze 的 331 例(2.25%)。这些错误主要发生在多个交通目标位置接近、边界框互相重叠、视觉上难以区分的情形。图 15 展示了因真值与预测交通目标重叠而导致注视目标错误预测的样本。
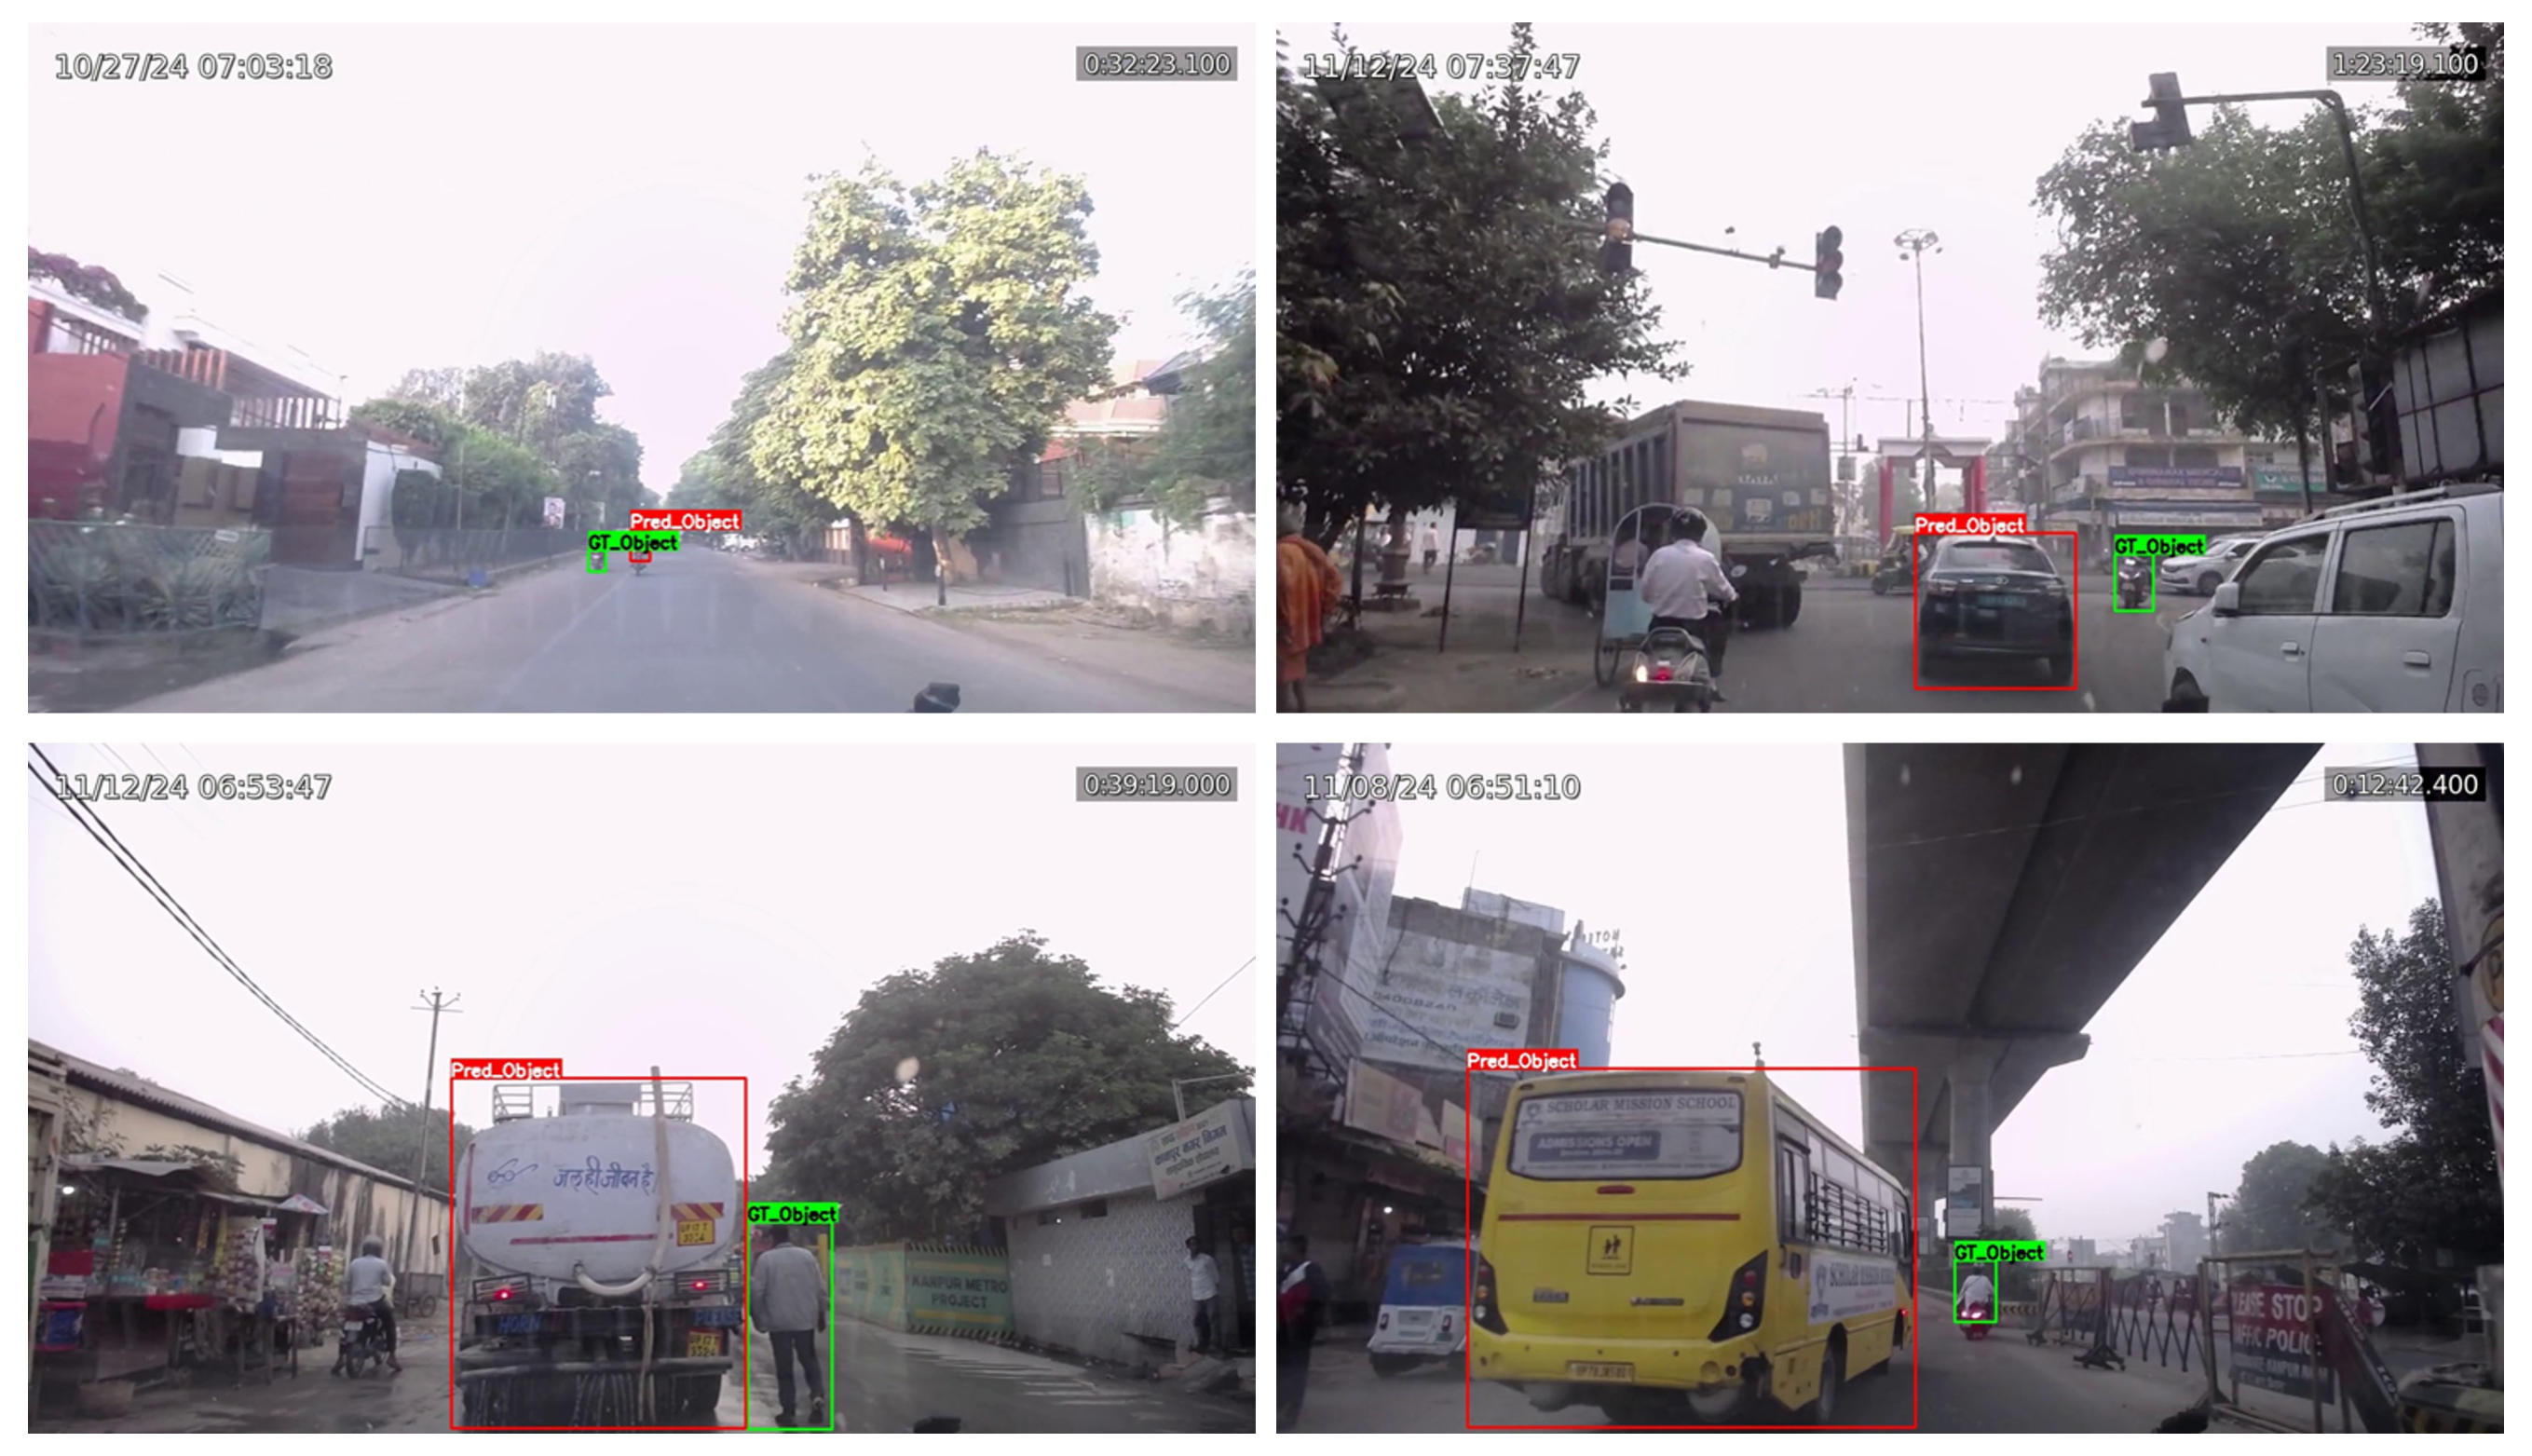
非重叠的交通目标-交通目标错误预测中,TransGaze-Object 记录 2,029 例(13.82%),SGAP-Gaze(PoG-目标关联)记录 2,098 例(14.29%)。TransGaze-Object 略低的错误率表明所提模型在区分空间上分离的交通目标方面稍微更有效。图 16 展示了因非重叠导致注视目标错误预测的样本。总体而言,两种方法的交通目标-交通目标错误率相当,说明所提 TransGaze-Object 模型的主要优势在于减少交通目标与背景之间的混淆,而非不同交通目标之间的混淆。
| 类别 | TransGaze-Object | PoG-目标关联 | ||
|---|---|---|---|---|
| 数量 | 百分比(%) | 数量 | 百分比(%) | |
| 交通目标-交通目标(重叠) | 353 | 2.40 | 331 | 2.25 |
| 交通目标-交通目标(非重叠) | 2,029 | 13.82 | 2,098 | 14.29 |
为研究目标尺度对注视估计性能的影响,我们分析了预测边界框面积与注视估计误差的关系。估计误差计算为真值注视点坐标与预测注视目标边界框最近边之间的最短距离。边界框坐标原本是归一化形式,先用图像分辨率(1280 × 720)转换为像素坐标,再以像素为单位计算每个估计边界框的面积。为了在不同尺寸目标之间公平比较,注视误差按边界框面积的平方根归一化,提供尺度无关的定位误差度量。
此外,按边界框面积把目标分为小、中、大三组。分类采用分位数划分:数据集按边界框面积分布等分为三个子集,保证目标尺寸的均衡表示,便于在不同尺度间有意义地比较模型性能。然后计算每个尺寸组的平均归一化误差,评估目标尺度对注视目标预测准确率的影响。
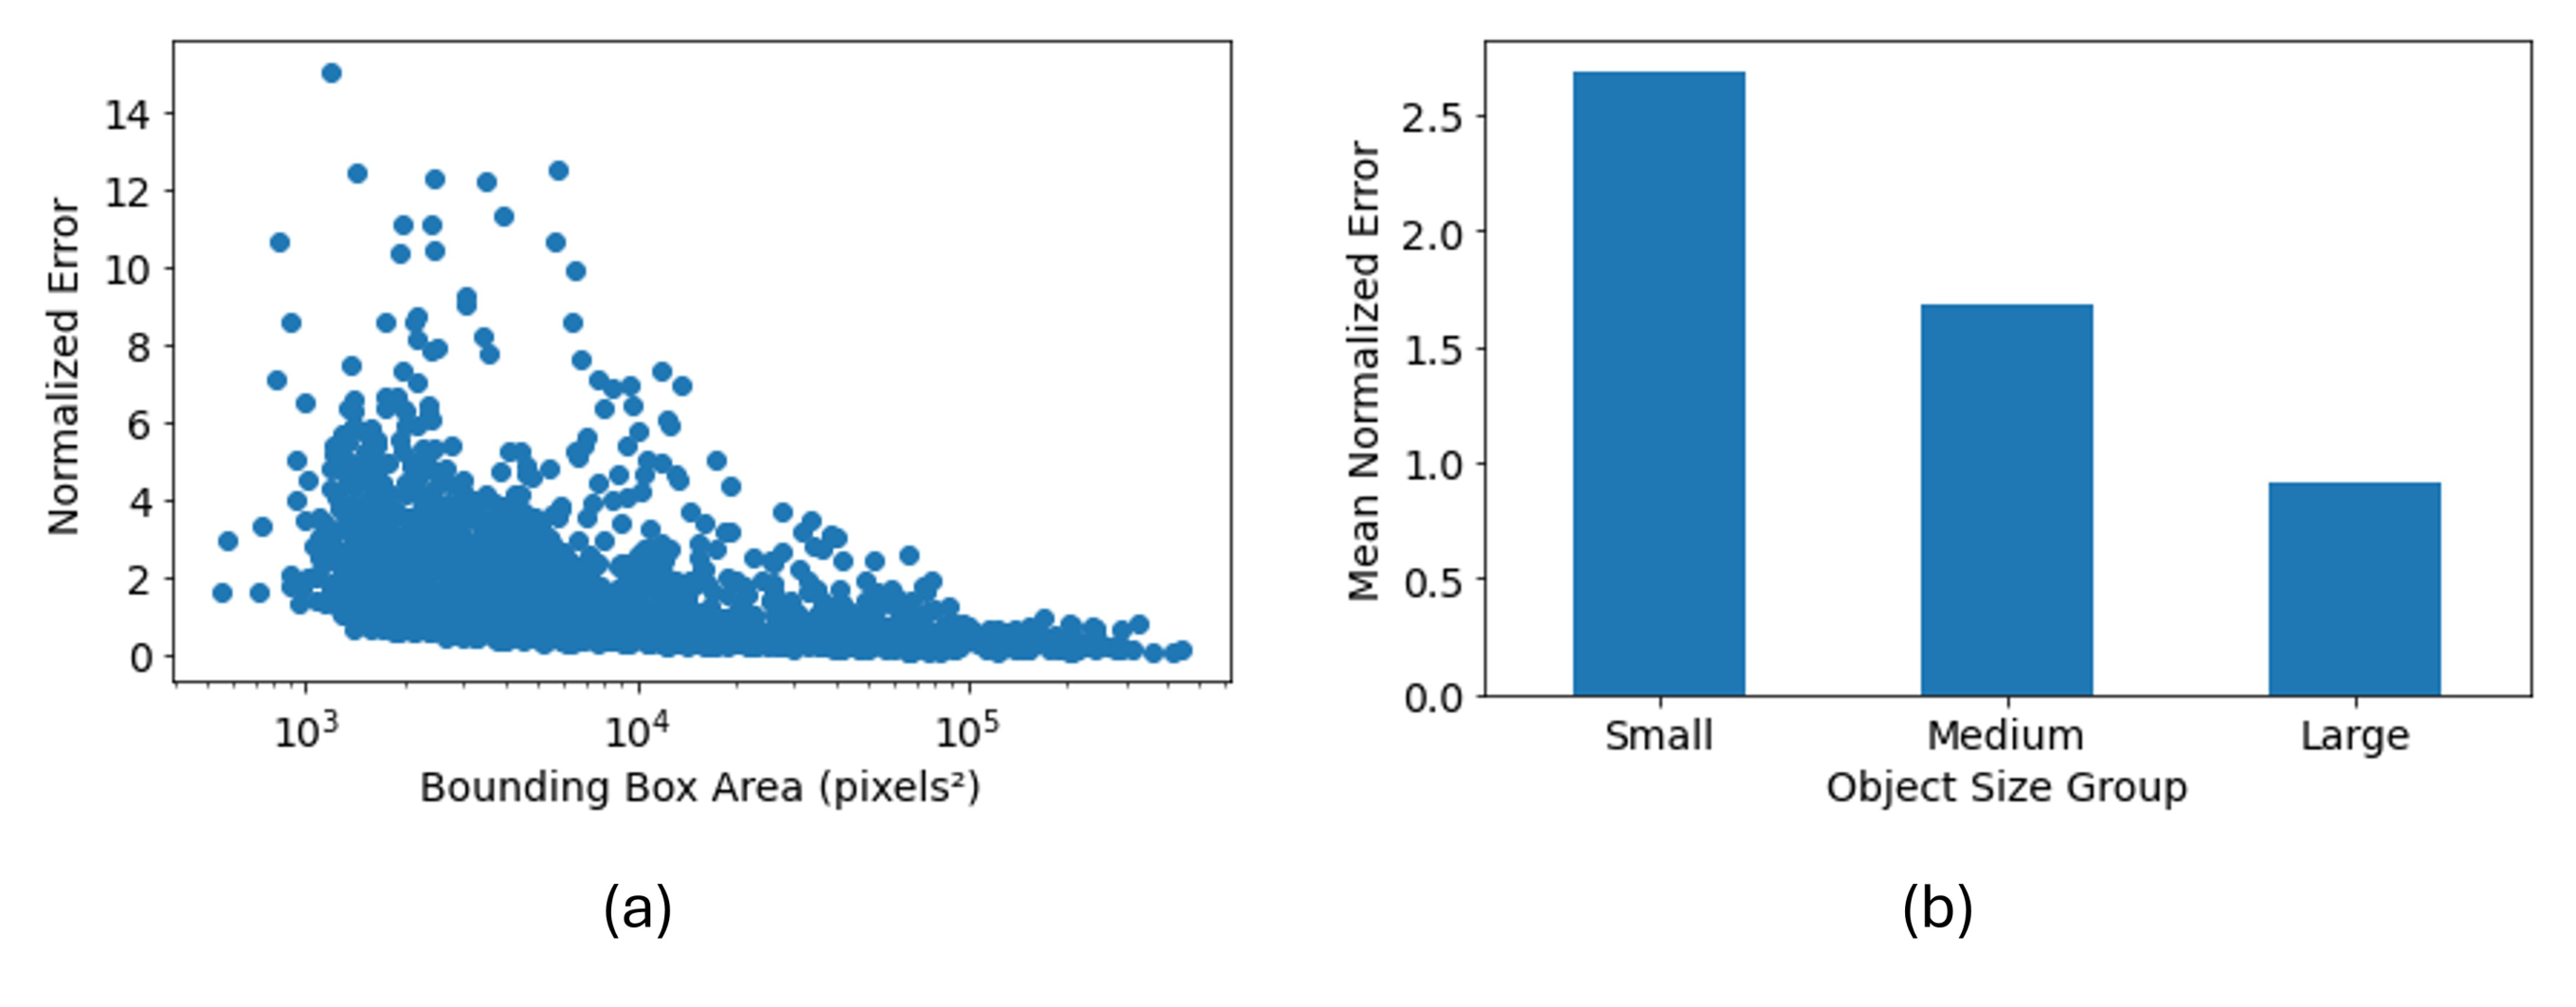
分析显示,边界框面积与归一化注视误差呈明显负相关(Pearson = −0.286,Spearman = −0.622),见图 17a,表明目标越大相对误差越低。此外,分尺寸评估显示小目标的归一化误差显著高于中、大目标,见图 17b。这表明所提模型对较大目标更可靠,而较小的目标由于其空间范围有限、注视-目标关联歧义更大,仍然具有挑战性。
驾驶员注视在评估驾驶员视觉注意力与态势感知方面作用显著。现有驾驶员注视估计方法把驾驶员注视表示为车辆内部区域(如前风挡、侧翼后视镜)或场景图像上的注视方向向量 / 注视点。物体级注视信息为驾驶员视觉注意力与态势感知提供更有语义意义的线索,有助于开发基于注视的驾驶员监测系统以提升驾驶员安全。然而,现有研究尚未开展端到端的注视目标预测。因此,本研究提出了基于 Transformer 的注视目标预测框架(TransGaze-Object),直接把驾驶员注视表示为交通目标或背景。所提框架以面部与场景图像为输入提取面部特征与场景特征:首先用两个独立的自定义 YOLOv8 检测器分别在面部与场景图像中检测面部-眼睛-虹膜(FEI)与交通目标;然后提取面部特征(包括面部特征与虹膜加权眼部特征)以及检测到的交通目标的空间特征;再用基于 Transformer 的交叉注意力机制计算相似度得分与注意力权重,预测驾驶员的注视目标。为训练该模型,我们提出了基准驾驶员注视数据集 UD-FSG(Urban Driving-Face Scene Gaze),包含同步的驾驶员面部与交通场景图像、场景目标边界框,以及以 2D 注视坐标和对应注视目标表达的注视标签。我们引入了由分类、一致性、混淆感知注意力与困难负样本间隔损失组成的混合损失函数,以提高 TransGaze-Object 模型训练的稳健性。
所提 TransGaze-Object 模型取得 60% 的总体注视目标预测准确率;相比之下,用最先进的基于 PoG 的方法把预测注视点与目标边界框关联取得 51% 的总体准确率。因此,所提模型的注视目标预测准确率提升约 9%,相对 SGAP-Gaze 提升 17.5%,凸显了在训练中融入目标级几何与空间信息以建立驾驶员注视与场景目标间更可靠关联的收益。误差分析显示,TransGaze-Object 减少了交通目标与背景之间的混淆,错误率为 11.68%,而基于 PoG 的后处理注视目标关联为 23.21%。然而,区分交通目标与背景仍然具有挑战性;进一步的误差分析表明,对小目标的注视预测仍然困难。通过把驾驶员注视估计形式化为端到端的注视目标预测问题,本工作旨在推动对驾驶员视觉注意力物体级表示的进一步研究。
未来工作中,所提框架可在预测准确率、稳健性以及跨多样驾驶条件的泛化能力上进一步改进。框架可通过显式纳入相应的相机内外参来扩展到不同相机配置与仪表盘相机安装位置;也可以从当前的前视场景扩展到侧窗与更宽的车内区域,实现更广视野的驾驶员注视估计。未来研究还可利用连续帧的时序信息建模驾驶员注视的动态特性,提高挑战性真实驾驶条件下注视目标预测的稳定性。
写作过程中生成式 AI 与 AI 辅助技术的声明:作者声明在本文写作中使用 ChatGPT 辅助语法检查与语言修正。工具生成的所有内容均经作者仔细审阅、修改与批准,作者对出版内容承担全部责任。
CRediT 作者贡献声明:Pavan Kumar Sharma:概念化、数据整理、形式分析、研究、方法学、软件、验证、初稿写作。Ayush Pande:概念化、研究、审阅与编辑。Pranamesh Chakraborty:概念化、研究、方法学、资源、监督、验证、审阅与编辑。
利益冲突声明:作者声明不存在可能影响本文所报告工作的已知竞争性经济利益或个人关系。
数据可用性:支持本研究结果的数据集发布于:https://github.com/pavans20/Urban-Driving-Face-Scene-Gaze-Dataset.git。
Caesar, H., Bankiti, V., Lang, A. H., Vora, S., Liong, V. E., Xu, Q., Krishnan, A., Pan, Y., Baldan, G., & Beijbom, O. (2020). nuscenes: A multimodal dataset for autonomous driving. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR).
Cheng, Y., & Lu, F. (2022). Gaze estimation using transformer. In 2022 26th International Conference on Pattern Recognition (ICPR) (pp. 3341–3347). IEEE.
Cheng, Y., Zhu, Y., Wang, Z., Hao, H., Liu, Y., Cheng, S., Wang, X., & Chang, H. J. (2024). What do you see in vehicle? comprehensive vision solution for in-vehicle gaze estimation. In 2024 IEEE/CVF Conference on Computer Vision and Pattern Recognition (CVPR) (pp. 1556–1565). IEEE.
Chuang, M.-C., Bala, R., Bernal, E. A., Paul, P., & Burry, A. (2014). Estimating gaze direction of vehicle drivers using a smartphone camera. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition Workshops (pp. 165–170).
Deng, P., Yang, J. J., & Bian, J. (2026). Cross-paradigm evaluation of gaze-based semantic object identification for intelligent vehicles. arXiv preprint arXiv:2602.01452, .
Dingus, T. A., Guo, F., Lee, S., Antin, J. F., Perez, M., Buchanan-King, M., & Hankey, J. (2016). Driver crash risk factors and prevalence evaluation using naturalistic driving data. Proceedings of the National Academy of Sciences, 113, 2636–2641.
Dua, I., John, T. A., Gupta, R., & Jawahar, C. (2020). Dgaze: Driver gaze mapping on road. In 2020 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS) (pp. 5946–5953). IEEE.
Fischler, M. A., & Bolles, R. C. (1981). Random sample consensus: a paradigm for model fitting with applications to image analysis and automated cartography. Communications of the ACM, 24, 381–395.
Fridman, L., Langhans, P., Lee, J., & Reimer, B. (2016a). Driver gaze region estimation without use of eye movement. IEEE Intelligent Systems, 31, 49–56.
Fridman, L., Lee, J., Reimer, B., & Victor, T. (2016b). ‘owl’and ‘lizard’: Patterns of head pose and eye pose in driver gaze classification. IET Computer Vision, 10, 308–314.
Ghosh, S., Dhall, A., Sharma, G., Gupta, S., & Sebe, N. (2021). Speak2label: Using domain knowledge for creating a large scale driver gaze zone estimation dataset. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 2896–2905).
He, K., Zhang, X., Ren, S., & Sun, J. (2016). Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition (pp. 770–778).
Hu, D., Li, X., Cui, M., & Huang, K. (2025). Lnet: Lightweight network for driver attention estimation via scene and gaze consistency. IEEE Transactions on Image Processing, 35, 27–41.
Hu, Z., Lv, C., Hang, P., Huang, C., & Xing, Y. (2021). Data-driven estimation of driver attention using calibration-free eye gaze and scene features. IEEE Transactions on Industrial Electronics, 69, 1800–1808.
Kasahara, I., Stent, S., & Park, H. S. (2022). Look both ways: Self-supervising driver gaze estimation and road scene saliency. In European Conference on Computer Vision (pp. 126–142). Springer.
Kullback, S., & Leibler, R. A. (1951). On information and sufficiency. The Annals of Mathematical Statistics, 22, 79–86.
Lal, S. K., & Craig, A. (2001). A critical review of the psychophysiology of driver fatigue. Biological Psychology, 55, 173–194.
Li, G., Wang, Y., Zhu, F., Sui, X., Wang, N., Qu, X., & Green, P. (2019). Drivers’ visual scanning behavior at signalized and unsignalized intersections: A naturalistic driving study in china. Journal of Safety Research, 71, 219–229.
Li, M., Feng, Z., Zhang, W., Wang, L., Wei, L., & Wang, C. (2023). How much situation awareness does the driver have when driving autonomously? a study based on driver attention allocation. Transportation Research Part C: Emerging Technologies, 156, 104324.
Li, T., Peng, J., Li, Q., Li, X., Zhao, B., & Zhang, G. (2026). A geometry-guided multimodal framework for train driver gaze target estimation. Engineering Applications of Artificial Intelligence, 179, 115156.
Li, Y., Hong, Y., Wang, Z., Chen, J., Liu, R., Ding, S., & Tan, B. (2025). Nonlinear multi-head cross-attention network and programmable gradient information for gaze estimation. Scientific Reports, 15, 27135.
Liu, D., Li, D., Ding, H., Cao, Y., & Gao, K. (2025). Beyond vision: A unified transformer with bidirectional attention for predicting driver perceived risk from multi-modal data. Transportation Research Part C: Emerging Technologies, 179, 105270.
Louw, T., & Merat, N. (2017). Are you in the loop? using gaze dispersion to understand driver visual attention during vehicle automation. Transportation Research Part C: Emerging Technologies, 76, 35–50.
LRD, M., Mukhopadhyay, A., & Biswas, P. (2022). Distraction detection in automotive environment using appearance-based gaze estimation. In 27th International Conference on Intelligent User Interfaces (pp. 38–41).
Martin, S., Vora, S., Yuen, K., & Trivedi, M. M. (2018). Dynamics of driver’s gaze: Explorations in behavior modeling and maneuver prediction. IEEE Transactions on Intelligent Vehicles, 3, 141–150.
Mathew, A. M., Hermassi, H., Kadavil, T., & Khan, A. A. (2026). Gazevlm: A vision-language model for multi-task gaze understanding. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition (pp. 9241–9250).
Nieva-Suárez, Á., Marron-Romera, M., Losada-Gutierrez, C., & Guardiola-Luna, I. (2025). Towards fusing gaze estimation and object prediction: What are you looking at? Engineering Applications of Artificial Intelligence, 157, 111113.
Ortega, J. D., Kose, N., Cañas, P., Chao, M.-A., Unnervik, A., Nieto, M., Otaegui, O., & Salgado, L. (2020). Dmd: A large-scale multi-modal driver monitoring dataset for attention and alertness analysis. In European Conference on Computer Vision (pp. 387–405). Springer.
Palazzi, A., Abati, D., Solera, F., Cucchiara, R. et al. (2018). Predicting the driver’s focus of attention: the dr (eye) ve project. IEEE Transactions on Pattern Analysis and Machine Intelligence, 41, 1720–1733.
Rangesh, A., Zhang, B., & Trivedi, M. M. (2020). Driver gaze estimation in the real world: Overcoming the eyeglass challenge. In 2020 IEEE Intelligent Vehicles Symposium (IV) (pp. 1054–1059). IEEE.
Regan, M. A., Lee, J. D., & Young, K. (2008). Driver distraction: Theory, effects, and mitigation. CRC press.
Ribeiro, R. F., & Costa, P. D. (2019). Driver gaze zone dataset with depth data. In 2019 14th IEEE International Conference on Automatic Face & Gesture Recognition (FG 2019) (pp. 1–5). IEEE.
Shah, S. M., Sun, Z., Zaman, K., Hussain, A., Shoaib, M., & Pei, L. (2022). A driver gaze estimation method based on deep learning. Sensors, 22, 3959.
Sharma, P. K., & Chakraborty, P. (2024a). Driver gaze zone estimation using deep neural network. In International Conference on Transportation Planning and Implementation Methodologies for Developing Countries (pp. 227–236). Springer.
Sharma, P. K., & Chakraborty, P. (2024b). A review of driver gaze estimation and application in gaze behavior understanding. Engineering Applications of Artificial Intelligence, 133, 108117.
Sharma, P. K., & Chakraborty, P. (2025). Evaluation of data collection and annotation approaches of driver gaze dataset. Behavior Research Methods, 57, 172.
Sharma, P. K., & Chakraborty, P. (2026). Sgap-gaze: Scene grid attention based point-of-gaze estimation network for driver gaze. arXiv preprint arXiv:2604.19888, .
Tawari, A., Chen, K. H., & Trivedi, M. M. (2014). Where is the driver looking: Analysis of head, eye and iris for robust gaze zone estimation. In 17th International IEEE Conference on Intelligent Transportation Systems (ITSC) (pp. 988–994). IEEE.
Tayal, D., & Mishra, S. K. (2025). On the Road to Equality: Gender, Transport and Economic Empowerment in India. South and South-West Asia Office (SSWA), Economic and Social Commission for Asia and the Pacific (ESCAP).
Tonini, F., Dall’Asen, N., Beyan, C., & Ricci, E. (2023). Object-aware gaze target detection. In Proceedings of the IEEE/CVF International Conference on Computer Vision (pp. 21860–21869).
Tonsen, M., Baumann, C. K., & Dierkes, K. (2020). A high-level description and performance evaluation of pupil invisible. arXiv preprint arXiv:2009.00508, .
Ultralytics (2023). Yolov8. URL: https://github.com/ultralytics/ultralytics.
Varma, G., Subramanian, A., Namboodiri, A., Chandraker, M., & Jawahar, C. (2019). Idd: A dataset for exploring problems of autonomous navigation in unconstrained environments. In 2019 IEEE Winter Conference on Applications of Computer Vision (WACV) (pp. 1743–1751). IEEE.
Vaswani, A., Shazeer, N., Parmar, N., Uszkoreit, J., Jones, L., Gomez, A. N., Kaiser, Ł., & Polosukhin, I. (2017). Attention is all you need. Advances in Neural Information Processing Systems, 30.
Vicente, F., Huang, Z., Xiong, X., De la Torre, F., Zhang, W., & Levi, D. (2015). Driver gaze tracking and eyes off the road detection system. IEEE Transactions on Intelligent Transportation Systems, 16, 2014–2027.
Vora, S., Rangesh, A., & Trivedi, M. M. (2018). Driver gaze zone estimation using convolutional neural networks: A general framework and ablative analysis. IEEE Transactions on Intelligent Vehicles, 3, 254–265.
Wang, B., Guo, C., Jin, Y., Xia, H., & Liu, N. (2024). Transgop: transformer-based gaze object prediction. In Proceedings of the AAAI Conference on Artificial Intelligence (pp. 10180–10188). volume 38.
Wang, Y., Nan, H., Yan, R., Ding, X., Wang, J., & Fu, X. (2026). Pigaze: Personalized in-vehicle gaze estimation with plug-and-play adaptation. Knowledge-Based Systems, 348, 116336.
World Health Organization (2023). Global Status Report on Road Safety 2023. Geneva: World Health Organization. Licence: CC BY-NC-SA 3.0 IGO.
Wu, X., Li, L., Zhou, G., Wu, Q., Zuo, X., Zhu, H., & He, S. (2025). Multi-task driver gaze estimation in real world driving scenes. Engineering Applications of Artificial Intelligence, 160, 111892.
Yahyaabadi, R., & Nikan, S. (2026). Driver gaze zone estimation using multi-head attention graph neural network. IEEE Transactions on Intelligent Transportation Systems, .
Yang, L., Dong, K., Dmitruk, A. J., Brighton, J., & Zhao, Y. (2019). A dual-cameras-based driver gaze mapping system with an application on non-driving activities monitoring. IEEE Transactions on Intelligent Transportation Systems, 21, 4318–4327.
Yang, Y., Liu, C., Chang, F., Lu, Y., & Liu, H. (2021). Driver gaze zone estimation via head pose fusion assisted supervision and eye region weighted encoding. IEEE Transactions on Consumer Electronics, 67, 275–284.
Yarbus, A. L. (2013). Eye movements and vision. Springer.
Yuan, G., Wang, Y., Yan, H., & Fu, X. (2022). Self-calibrated driver gaze estimation via gaze pattern learning. Knowledge-Based Systems, 235, 107630.
Zhou, J., Liu, C., Chang, F., Wang, W., Hao, P., Huang, Y., & Yang, Z. (2025). Eraw-net: Enhance-refine-align w-net for scene-associated driver attention estimation. IEEE Transactions on Multimedia, 27, 5922–5935.
本章为译者面向驾驶员监测(DMS)方向工程实践的评估,不代表论文观点。阅读顺序建议:先看第 1 节划边界,再决定是否深入。
先说清楚:这不是一个能直接拿来用的 DMS 方案。
——训练管线不可复现于我们的场景。整个框架的监督信号来自眼动仪(Pupil Invisible)真值:需要风挡贴 AprilTag、每位驾驶员 10–12 对标定图像、Pupil Cloud 云端坐标变换、RANSAC 单应估计,再加仪表盘相机与眼动仪的秒表对时。这套数据基建只属于 IIT Kanpur 的试验车车队,我们没有等效的注视真值来源。
——两个前置检测器都是自训的。FEI(面部-眼睛-虹膜)检测器用 481 名司机 2,200 张标注图训练;交通目标检测器在 IDD + nuImages + UD-FSG 共 10,981 张图上微调,且nuImages 缺的类别是人工用 CVAT 补标的。推理时框架还要求场景目标边界框作为先验输入——即必须先跑一个 mAP 只有 79.1% 的 YOLOv8,漏检目标直接变成「背景」候选。
——60% 的准确率撑不起产品级判定。即使是作者自己的结论也承认「只有约 60% 的注视目标被正确预测」。做分心 / 视线偏离告警的 DMS 需要的是二值的视线离开道路检测,而不是 11 类目标归属——问题形式不同,不能移植。
——数据域高度特化。35 名被试全部是印度坎普尔的男性职业驾驶员(年龄 25–51,驾龄 3–30 年),场景是高密度异构交通(大量自动载客三轮车、摩托车)。模型与数据都不能假设可迁移到其他地区、非职业驾驶员或乘用车私家车场景。
(a) UD-FSG 数据集本身(开源)。373,488 对同步面部-场景图像、35 名驾驶员、10 类交通目标边界框 + 注视目标标签,是目前第二个公开的 face+scene 同步注视数据集,也是第一个含异构交通的。做注视 / 注意力方向的研究可以直接下载使用,不用自建车队。
(b) 混淆感知注意力损失(式 33–36)。核心想法零成本可搬:用真值目标与其他目标的中心距离做负距离 softmax(式 34),与 one-hot 按 0.9 / 0.1 混合(式 35)得到软标签,再对注意力分布做 KL 监督(式 36)。任何「从多个候选里选一个」的注意力式预测器(目标级注意力、区域选择、关键帧选择)都吃这套监督,能缓解「邻近候选过度惩罚」问题。
(c) 困难负样本间隔损失(式 37)。k=2、m=0.5 的 hinge:压低 top-2 高注意力非真值候选。与 (b) 是一对——(b) 管「附近该给点概率」,(c) 管「最像的那个必须拉开」。两个公式五行代码量级。
(d) 不确定性加权多任务损失(式 38)。e−σ·L + σ 的经典 Kendall 式加权,用于自动平衡一致性损失与混淆感知损失,免手调权重。多损失 DMS 模型(检测 + 分心分类 + 疲劳回归)直接可用。
(e) 虹膜高斯加权眼部特征(式 11–13)。裁眼图 → 常数灰度 114 填充到 224×224 → ResNet-18 layer4 特征 → 以虹膜中心为中心、σ=1.2 的高斯权重图做空间加权 → GAP。相比直接对整眼做 GAP,把表征重心压到虹膜位置。虹膜中心坐标可由任意现行人脸关键点 / 虹膜分割方案给出,不依赖论文自训的 FEI 检测器。
(f) 工程细节两个小而实用:有效性感知门控(双眼虹膜都检不到时停用虹膜 token、只留面部与场景线索);背景类用哨兵向量 [−1, −1, 2, 2] 编码进空间特征,免去单独的分类头。
从站点内容工程(驾驶员监测 / 智能座舱方向)的视角,我们手里有论文没有的几样东西:
——法规与测评语境。站点已积累 GB/T 44497、GB 44721(欧盟 GSR 与 DDAW / 方向盘脱离检测相关的国内对应标准)以及 Euro NCAP 路线图类内容;这些框架关心的是「视线是否离开前方道路」的二值判定与时延指标,而论文的 11 类目标归属任务目前不在任何法规测评项里——这本身就是一条值得写的内容判断:物体级注视是研究前沿,不是合规指标。
——产品侧错误代价模型。DMS 落地讨论的是误报率 / 漏报率与告警疲劳的平衡;论文的误差三分类(目标-目标 / 目标-背景 / 背景-目标)恰好可以映射到漏报与误报,我们能把它的 Table 3 重述为产品语言,这是论文自己没做的。
——跨论文的合成点。站内已有多篇 gaze / DMS 方向的论文解读:注意力图方法(EyeCue)、眼动标签方法(EyeTAG)、以及 TransGaze-Object 早期的 arXiv 版本解读。本文的缺口(无时序建模、无消融)正好是另一类工作(时序 DMS、消融驱动的工程评测)的产物;UD-FSG 的「37.98% 帧注视落在目标上、62% 看背景」这个分布本身,对任何做驾驶员注意力先验的内容都是有用的统计事实。
第一步(零训练成本):把 Table 3 的三分类误差口径与「60% 上限」写进 DMS 内容库。「即使端到端建模,物体级注视准确率也只有六成,而角度误差仅 6° 的注视方向模型换算成目标归属只有 51%」——这一对数字是反驳「注视估计已解决」这一常见误读的最有力证据,适合作为解读文的核心数字。
第二步(低成本):搬三个损失项(式 35–38 的软标签混合比例 0.9/0.1、k=2/m=0.5 的 hinge、e−σ+σ 加权)到任何多候选注意力任务。这些超参有论文背书,作为初始化默认值合理;但注意论文没做消融,上线前需要自己的小规模对照。
第三步(有标注预算时):UD-FSG 做预训练或评测集。若做驾驶员注意力相关的模型,用它预训练特征、或作为异构交通域的 out-of-distribution 评测集,比自采数据便宜两个数量级。
不建议做:复现完整 TransGaze-Object。复现链路需要眼动仪标定基建 + 两个自训检测器 + 未公开的若干实现细节(γ 取值、编码器堆叠层数、d 的正式声明),投入产出比差。
——任何使用 UD-FSG 或复现其协议的工作,先确认注视真值的标注链:GT 注视目标由眼动仪 PoG 落框(10px 容差)生成,而眼动仪坐标本身经 AprilTag + Pupil Cloud + 单应三级变换;每级都有误差,论文只做了人工抽查。若你的任务对边界样本敏感,这个标签噪声不可忽略。
——域一致性:全体被试为印度男性职业司机、右舵 SUV、高密度异构交通。若目标场景是中国乘用车左舵 + 高速 / 城市快速路,场景先验(目标类型分布、中心偏置强度)都会漂移。
——物体级注视的下游可用性:确认你要的到底是「看哪个物体」还是「是否看路」。前者是本文的任务,后者才是现行 DMS 法规的任务。两者混用会导致指标错配。
——实时性未知:论文完全没报告推理时延与模型参数量;6 token × 20 token 的交叉注意力本身很轻,但前置的 YOLOv8 目标检测 + 三个 ResNet-18 分支的开销需要自己测。