近年来自动驾驶技术蓬勃发展,同时对海量高质量数据的渴求也与日俱增。然而,真实世界数据集高昂且耗时的实验与标注成本,使其难以跟上需求变化的步伐。因此,越来越多的研究者转向合成数据集,以便捷地生成丰富而多变的数据,作为对真实世界的有效补充并提升算法性能。本文梳理了合成数据集生成方法的演进过程,评述了迄今为止与自动驾驶感知研究中单任务与多任务类别相关的合成数据集工作。我们还讨论了合成数据集在自动驾驶相关算法测试的评估、域差距测试(gap test)与积极作用中所扮演的角色,尤其是在可信性(trustworthiness)与安全性方面的作用,并给出评估实验的实例。最后,我们讨论了合成数据集的局限与未来方向。据我们所知,这是第一篇聚焦于合成数据集在自动驾驶中应用的综述。本文也唤起了对自动驾驶技术真实世界部署问题的关注,并为研究者提供了一种可能的解决路径。
自动驾驶研究的最新趋势催生了大量感知与系统测试算法的研究,它们都对高质量数据极度渴求。大量丰富而准确的数据不仅是算法实验的基础,也会影响算法性能。为满足目标检测与跟踪、实例分割、深度估计、光流估计等各类自动驾驶感知任务的需求,KITTI [1]、Waymo Open [2]、BDD100K [3] 等大规模真实世界数据集相继被创建,为自动驾驶算法的开发提供了实验基础与平台。这些数据集如今已被广泛用作训练与测试感知算法的基准数据集。
然而,由于物理实验的固有属性,来自真实场景与传感器的数据集也有其局限与缺陷。这类实验往往需要昂贵的硬件(如车辆、LiDAR 等)和大量标注工作。对于更复杂的问题,比如研究某些变量对感知任务的影响,通常还需要更多实验时间,因为天气、边角案例等一些因素是不可控的,这限制了对这些罕见但重要的场景做更深入的研究。此外,当系统测试对采集数据有特定要求时,例如扩展场景与天气的覆盖面和多样性,则需要长得多的行驶距离与时间,从而降低测试的速度与可靠性。一些研究者发现,克服真实世界数据局限的最有效方法之一就是创建合成数据集 [4],[5],[6]。其有效性在于能够精心控制各种在真实数据采集中难以甚至不可能实现的环境因素、场景和数据分布。
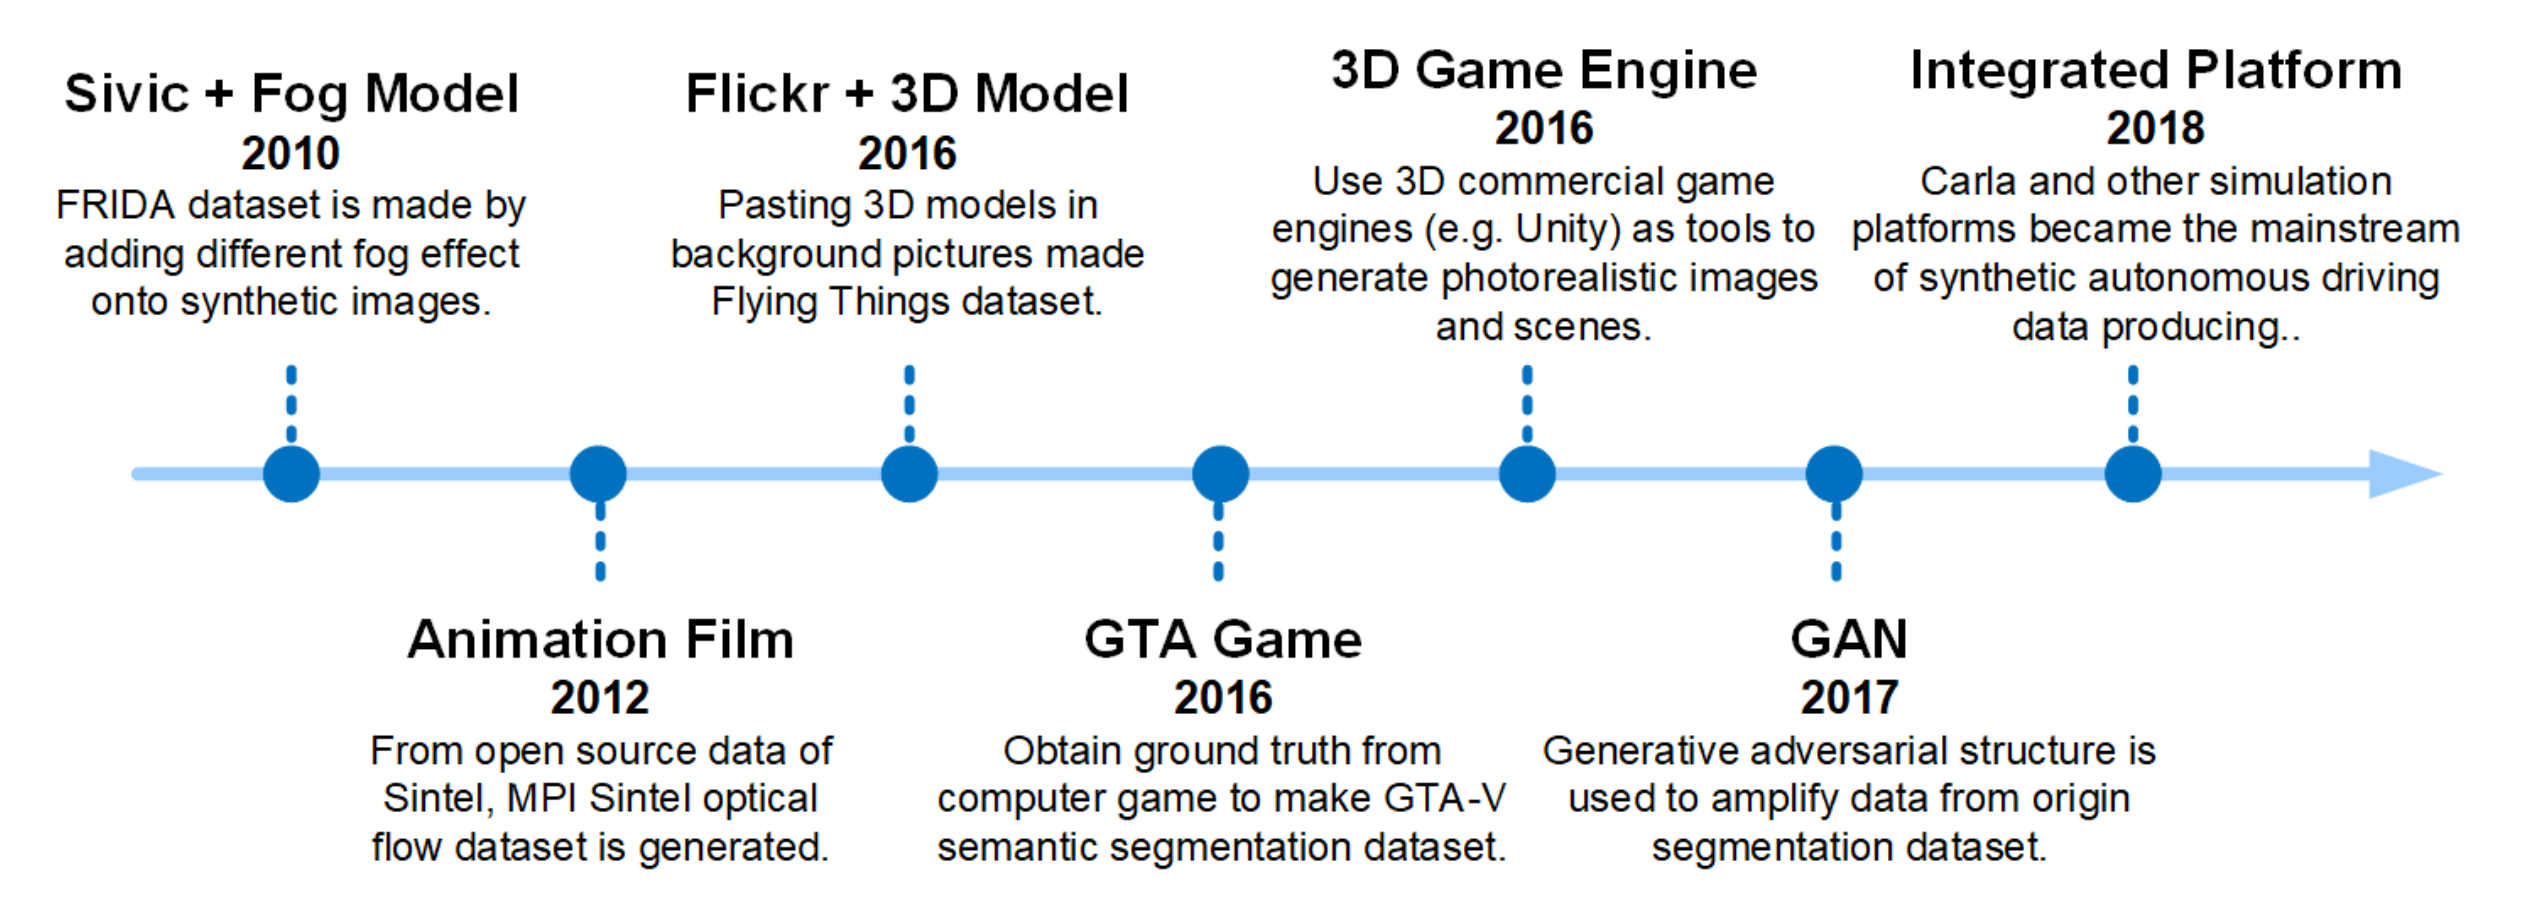
合成数据的发端可以追溯到 20 世纪 60 年代,当时它被用来为计算机视觉算法生成比真实数据更简单的线条图 [6],[7]。随后,合成数据被用作固定算法(如 Lucas-Kanade 光流估计方法)的测试集 [8]。随着深度学习的发展,合成数据不再局限于广为人知的计算机视觉领域,还被用作神经编程(neural programming)[9]、生物信息学(bioinformatics)[10] 与自然语言处理 [6],[11] 的训练来源。就自动驾驶相关合成数据集的生成技术而言,它们经历了若干发展阶段,见图 1。
第一个公开可用、应用于自动驾驶任务的合成数据集是 Tarel 等人 [12] 于 2010 年使用 Sivic 软件生成的雾天道路图像数据库(Fog Road Image Database,FRIDA)。它针对雾天条件下的深度估计任务,提供了 18 个城市道路场景、共 90 张带不同类型合成雾的图像。FRIDA2 于 2012 年发布,包含更多图像与道路场景 [13]。2012 年,Bulter 等人 [14] 以动画电影《Sintel》为数据源生成了 MPI Sintel 数据集,其中包含 1,041 对用于光流估计的图像,并成为第一个被广泛使用的合成数据集。然而,从开源电影获取数据的途径相对有限,主要是因为只有少数电影采用了诸如知识共享署名 3.0 许可(Creative Commons Attribution 3.0 License)[15] 或类似授权,允许研究者自由使用其内容来构建数据集。
2016 年,Mayer 等人 [16] 利用 ShapeNet 数据库 [17] 中的 3D 物体模型创建了约含 25,000 立体帧的 Flying Things 光流数据集,并用同一模型池构建了 Driving 数据集,其街景更自然、类似 KITTI 数据集。但这种拼接图像与 3D 模型的方法保真度较低、场景相对简单。因此,研究者逐渐探索利用已有图像资源合成自动驾驶数据集的多种方法。2016 年,Richter 等人 [18] 开发了一种无需开源代码即可从现代计算机游戏中生成像素级语义分割标注的工具。该方法可以通过游戏与图形硬件之间的通信快速完成语义标注。同年,Gaidon 等人 [19] 推出了 Virtual KITTI。此后,商业 3D 游戏引擎(如 Unity)一直被用作生成工具,并被证明是创建合成数据集的热门选择。
2017 年,Isola 等人 [20] 用带生成对抗结构的 Pix2Pix 网络从原始数据生成更大规模的语义分割数据。Wang 等人于 2018 年进一步完成 Pix2PixHD [21],可以从语义标注合成出细节更多的场景图像。此外,CRN [22]、SIMS [23]、GauGAN [24]、SelectionGAN [25]、TSIT [26]、PIS [27]、DAGAN [28]、SMIS [29]、MaskGAN [30] 与 SEAN [31] 也都是用 GAN 结构从语义图像合成场景图像的经典算法。如 [32] 所示,GAN 最初被用于生成 3D 场景布局,最近也与 U-Net 等结构结合使用来生成合成图像 [33]。在其早期图像生成应用中,难以对生成输出做细粒度控制,有时还会出现形变与异常细节结构,这对自动化标注流程的可行性有负面影响。
2018 年,基于虚幻引擎 4(Unreal Engine 4,UE4)的 Carla 平台 [34] 发布,为自动驾驶场景下的性能测试与数据集生成提供了一种新颖的系统性方案。此后,得益于 Carla 仿真平台及其配套传感器套件逼真、灵活、开源的使用模式,更多数据集得以便捷地合成。如今,随着大语言模型(LLM)的发展,它还被与 LLM 结合起来模拟多样且可控的环境 [35]。
合成数据集的激增促使研究者对这一主题进行综述 [5],[6]。这些综述虽覆盖了生成合成数据集的各类方法与技术,却往往忽略了与自动驾驶任务直接相关的合成数据集。这一空白促使我们深入研究自动驾驶语境下的合成数据集。在本研究中,我们依据广泛认可度、实际采用率、与自动驾驶感知任务的相关性以及真值标注的可获得性,选取了一部分合成数据集。此外,这些数据集还因其在表征不同驾驶场景方面的多样性而被选中。它们在此前的研究中发挥了核心作用,对自动驾驶开发与评估的深入分析至关重要。我们的目标是呈现这些合成数据集所涵盖的自动驾驶感知任务,探讨生成合成数据集所面临的挑战,从而为评估与生成提供指导。
早期合成数据集主要聚焦于某个特定自动驾驶感知任务,如光流估计或语义分割。随着生成技术的进步,合成数据集变得更加多样,适用范围也更广,涵盖的任务包括 2D/3D 目标检测、多目标跟踪、深度估计等。据此,我们可以把现有的自动驾驶相关合成数据集按其涵盖的任务类型分为两大类:单任务数据集与多任务数据集。
本综述的主要贡献包括:(a)我们对面向自动驾驶感知任务设计的合成数据集做了全面综述,对单任务与多任务合成数据集都提供了深入洞察。据我们所知,这是第一篇聚焦自动驾驶领域所用合成数据集的综述。(b)我们提出了一个评估合成数据集的框架,以促进可信数据集的生成。该框架为未来合成数据集评估与生成方向的研究提供了有价值的基础。(c)我们提出了一套带评估反馈的自动驾驶合成数据集系统化生成流程。该流程确保产出可信的数据集,这些数据集可以被有效评估并迭代改进,以满足自动驾驶研发的具体需求。
为更好地呈现我们的工作,本文其余部分组织如下:第二节阐述在自动驾驶领域生成合成数据集的动机;第三、四节分别详细介绍单任务与多任务合成数据集;第五节提出合成数据集的评估框架,并展示它们如何促进安全可信的自动驾驶系统;第六节在数据集样例上开展所提评估方法的实验;最后,第七节讨论未来研究方向,第八节给出总结。
已有研究强调了数据在自动驾驶系统开发中的重要性。然而,面对快速演进的、依赖大规模真实数据集的新兴算法,跟上其步伐并非易事。合成数据凭借其成本效益与获取速度吸引了越来越多研究者的关注,而且合成数据集相对真实世界数据集确实具备一些优势。本节概述合成数据集被越来越广泛使用的几个原因。
首先,在真实世界中构建大规模自动驾驶数据集往往成本高昂。获取足量高质量的原始数据需要特定场地和大量实验。而且,对多模态传感器或不同任务做精确的人工标注是一项艰苦的长期工作,往往需要专业团队昂贵的协助。例如,单个工人标注一个片段(segment)平均花费 0.86 美元,而一张图像通常有 15 到 30 个片段 [36]。如此高的成本对真实数据集的开发施加了许多限制,尤其是漫长更新迭代周期。
其次,对于某些特定问题的研究,例如探究算法模型在不同域偏移(domain shift,如天气与光照条件变化)下的性能,真实场景中很难获得各种可控的条件变化。因此,研究者常常依赖合成数据作为宝贵资源,来克服这些局限并开展全面研究。
第三,由于真实数据集在系统安全测试中存在严重的长尾问题,采集到的数据大多来自常规驾驶场景,因而对安全至关重要的挑战性场景(如交通事故、违规驾驶等)发生频率过低。为确保系统鲁棒性,有必要识别 [37]、设计并执行大量测试用例,这显著增加了测试成本。相比之下,合成数据集可以按具体需求构建安全相关场景,提高测试的速度与可靠性。例如,场景工程(scenarios engineering,SE)已被用于生成具有挑战性的合成场景 [38]。
由于合成自动驾驶数据集具备获取便捷、生成灵活的优势,它是上述挑战的潜在解决方案。需要注意的是,虽然生成合成数据的初始成本可能相对高于采集并标注单张真实图像,但随着合成数据量的增大,其成本效益会逐渐改善。这种数据生成方式可以自动生成精确标注而无需人工,便于高效地更新与迭代数据集,还能随需求变化展现出丰富的特异性,降低过拟合问题的影响。研究者希望将计算机生成的虚拟场景数据作为真实世界的替代或补充,从而提升算法与系统在真实世界中的性能。与此同时,可信人工智能(trustworthy AI)概念的出现强调了对算法可信度进行评估与测试的重要性,尤其是与机器学习和 AI 模型相关的算法。这一方面也与合成数据集的设计与应用密切相关。
早期合成数据集聚焦于单任务,如深度估计、光流估计与语义分割,显著降低了对人工标注的依赖。这些数据集为多任务合成数据集的诞生铺平了道路。本节对这些数据集做简要概述与性能评估,其样例如图 2 所示,对比见表 I。
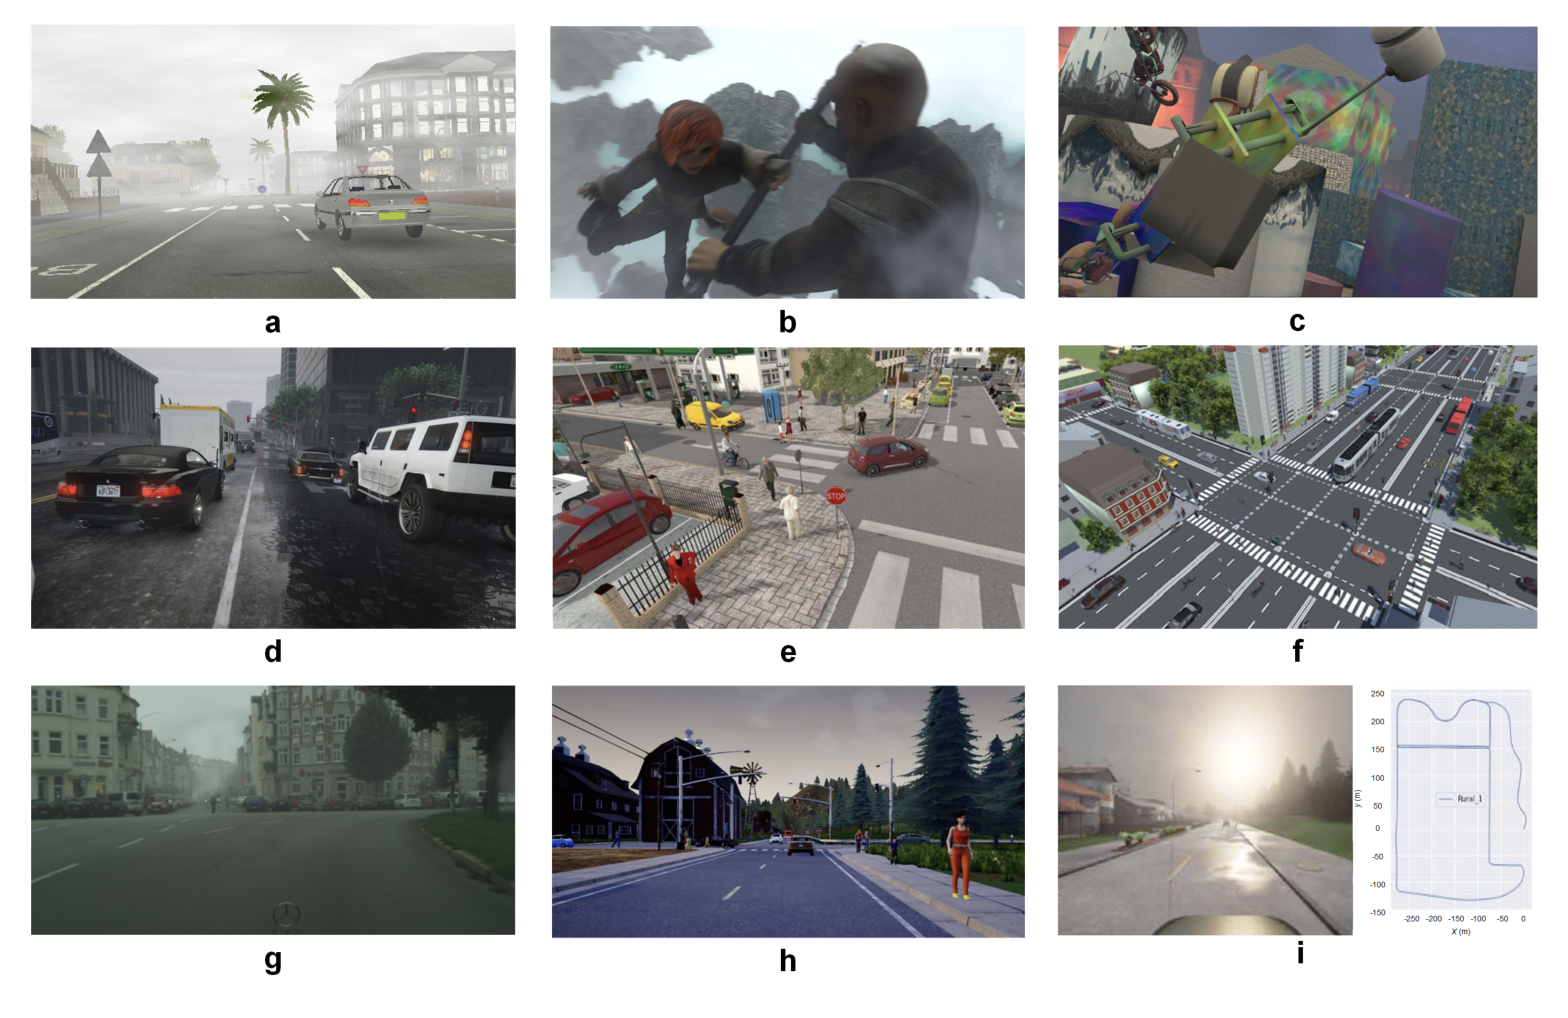
FRIDA [12] 由 Tarel 等人于 2010 年发布,是一个聚焦雾天条件的合成数据集。他们使用 Sivic 软件构建了逼真的 3D 城市环境,并应用 Koschmieder 定律来模拟各种类型与密度的雾。每张无雾图像配有 4 张雾化版本和一张深度图。FRIDA 由 18 个城市道路场景的 90 张合成图像组成,为研究者探索雾密度与场景深度的关系提供了宝贵资源。
在 FRIDA 的基础上,研究者于 2012 年发布了扩展数据集 FRIDA2 [13]。FRIDA2 包含 66 个不同道路场景的 330 张合成图像。FRIDA 与 FRIDA2 中同时包含清晰图像与雾天图像,这也便利了对能见度增强与去雾(dehazing)算法的评估 [44],[45]。这些算法是提升自动驾驶系统在恶劣天气条件下性能的关键组件。
MPI Sintel [14] 由 Bulter 等人于 2012 年创建,专为光流估计设计。光流估计帮助车辆感知环境的时间连续性,在时序任务中扮演重要角色 [46]。例如,车辆传感器可以从光流中恢复物体的 3D 结构与运动,为更高级的视觉任务提供可靠支持,最终控制车辆的转向与速度 [47]。
该数据集基于开源 3D 动画短片《Sintel》,包含 1,064 张合成立体图像与来自 23 个不同场景的真实世界数据。生成过程在 [48] 中有详细描述。MPI Sintel 的统计特性经过分析,被发现与自然电影相似。然而,MPI Sintel 常常忽略物理约束,在用它训练和评估高度依赖真实世界物理定律的算法时应保持谨慎 [14]。
为便于光流估计模型的验证,还创建了一个公开可访问的评估网站,展示了多种专攻光流估计的方法,如 PWC-Net [49]、SelFlow [50] 与 ScopeFlow [51]。迄今,MPI Sintel 已成为光流任务中使用最广泛的数据集之一,因为它很好地表征了自然场景与运动。
Flying Things [16] 由 Mayer 等人于 2016 年推出。它把此前的光流估计任务扩展到包含视差估计(disparity estimation)与场景流估计(scene flow estimation)。生成的运动剪切粘贴(motion cut-and-paste)前景被用于获得训练数据对。该数据集聚焦于沿随机 3D 轨迹飞行的日常物体集合,利用随机性与高级渲染能力生成。它由超过 25,000 对立体图像组成,包含视差、光流与场景流的真值数据。
仿真结果表明,Flying Things 能够成功训练大型卷积网络,并以高精度支持富有挑战性的任务。其他光流合成数据集也用与 Flying Things 相同的方法创建。例如,Driving 数据集 [16] 使用与 Flying Things 相同的车辆模型,具有自然的动态街景和与 KITTI 数据集相近的视角。
侠盗猎车手 V(Grand Theft Auto V,GTA-V)数据集 [18] 由 Richter 等人于 2016 年发布,是一个依赖商业视频游戏逼真度的像素级语义分割数据集。它具备对材质外观、光传输、玩家交互以及物体与环境的真实摆放的精确模拟。具体而言,它在游戏与操作系统之间引入了一个封装层(wrapper),便于捕获、修改与复现渲染指令。通过对从游戏传递到图形硬件的几何、纹理、着色器等各种渲染资源进行哈希,它在不同场景与游戏会话间生成物体签名(object signature)。这一流程使创建像素级物体标签无需边界跟踪。
将 GTA-V 数据集并入 CamVid、KITTI 等现有真实世界数据集,可以在最大限度减少昂贵的真实数据人工标注需求的同时,大幅提升模型训练精度 [18]。一些最先进的模型,如 MIC [52]、HRDA [53] 与 SePiCo [54],也在 GTA-V 数据集的语义分割上表现出色。
SYNTHIA [39] 由 Ros 等人于 2016 年发布,旨在应对语义分割的挑战并提升对驾驶场景的理解。该数据集由 Unity 开发平台中的虚拟城市渲染生成,并配以恰当的材质系数以确保逼真效果,还带有外观各异的不同季节。此外,动态光照引擎可以创建不同光照条件来模拟白昼变化。它提供了从不同视角、季节、天气条件与光照下采集的超过 213,400 张合成图像,并为 13 个类别提供像素级标注,包括天空、建筑、道路、人行道、栅栏、植被、车道标线、立杆、汽车、交通标志、行人、骑行者与杂项。仿真结果表明,在 SYNTHIA 上训练并在真实世界数据集上微调的模型,其语义精度得到提升。
此外,基于 SYNTHIA 还发布了 SYNTHIA-旧金山(SYNTHIA-SF)[55] 与 SYNTHIA-AL [56]。SYNTHIA-SF 包含 2,224 张带精确深度信息的合成图像与 19 类语义标注,非常适合评估深度与语义分割的精度。SYNTHIA-AL 则包含实例分割、2D 与 3D 边界框以及深度信息标注,专为评估道路场景视频中用于目标检测的主动学习(active learning)而设计。
实例分割虚拟环境(Virtual Environment for Instance Segmentation,VEIS)[40] 由 Saleh 等人于 2018 年创建,为实例分割任务提供了一个合成环境。VEIS 构建于 Unity3D 游戏引擎之上,用安装在虚拟车辆上的虚拟相机拍摄城市环境。每个实例被赋予唯一 ID,系统在实时渲染纹理与着色器的同时捕获合成图像与实例级语义分割图。该数据集包含 61,305 帧多类别与单类别场景,标注了前景类别的实例分割。
文中提出了一个在纯合成数据上训练实例分割的框架:背景与前景被独立处理,分割结果再行合并。该框架帮助自动驾驶车辆有效区分前景与背景类别,实现高效的实例分割。
Foggy Cityscapes [41] 由 Sakaridis 等人于 2018 年开发,是一个以雾天图像为特征的合成语义分割数据集。它在 MATLAB 平台上实现雾的光学模型,将合成雾添加到 Cityscapes 数据集 [57] 上生成带雾图像。它由 20,550 张图像组成,每张都带有来自 Cityscapes 的细粒度语义标注。图像中的雾是通过把一个更大、粗标注数据集中的 20,000 张图像与 550 张高质量图像做合成而生成的。
Foggy Driving 的创建是为了评估模型在真实世界雾天场景中的性能。研究表明,Foggy Cityscapes 能够提升模型在全监督与半监督设定下、具有挑战性的雾天环境中语义分割与目标检测的性能。该数据集还可用于实时快速去雾系统 [58]。
ItalDesign 数据集(ItalDesign DAtaset,IDDA)[42] 由 Alberti 等人于 2020 年创建,是当时最大的合成语义分割数据集。在 Carla 平台上,使用 RGB 相机、语义分割传感器与深度传感器来生成该数据集。利用 UE4 中的物体蓝图(object blueprint),语义分割传感器可以实时生成像素级标注图像,而深度传感器捕获在 RGB 色彩空间中编码深度信息的图像。该数据集包含超过 100 万张图像,具有 100 多种不同的场景组合、5 个视角、7 座城市与 3 种天气条件。图像带有像素级语义信息与深度图标注。
文中对有无域自适应的语义分割方法做了比较,证明 IDDA 是评估这些方法在域迁移(domain transfer)中性能的有效基准。在 IDDA 上训练的网络也被应用于真实世界数据集,结果表明尽管域自适应技术仍存在显著性能差距,IDDA 展现出与真实场景某种程度的接近。此外,文中还采用特征嵌入(feature embedding)方法量化了 IDDA 与真实世界数据集之间的差异 [59],为域自适应领域的进一步研究提供了有价值的启示。
CarlaScenes [43] 由 Kloukiniotis 等人于 2022 年开发,用于测量自动驾驶车辆的行驶里程。它由 Carla 平台生成,包含七个难以测量的场景,如上下坡、乡村环境、环岛、不同天气与光照条件、多个运动物体、复杂城市环境以及长距离道路。 ego 车辆穿越这些场景,并由相机、LiDAR、IMU 与 GNSS 采集数据用于里程计(odometry)测量。三种单目视觉方法(DSO [60]、LEGO-LOAM [61] 与 DVSO [62])在该数据集上测试后均被发现不适合这些具有挑战性的场景。不过,文中认为经过恰当的训练与验证,基于深度学习的里程计方法可以在各种场景中准确测量车辆里程。CarlaScenes 为真实场景数据标注这一困难任务提供了便捷的解决方案。
| 数据集 | 帧数 | 生成工具 | 任务 |
|---|---|---|---|
| FRIDA [12] | 90 | Sivic | 深度估计 |
| MPI Sintel [14] | 1K | Blender¹ | 光流估计 |
| Flying Things [16] | 25K | Blender¹ | 光流估计 |
| GTA-V 数据集 [18] | 25K | GTA 游戏 | 语义分割 |
| SYNTHIA [39] | 213K | Unity 开发平台 | 语义分割 |
| VEIS [40] | 61K | Unity 开发平台 | 实例分割 |
| Foggy Cityscapes [41] | 20K | MATLAB 平台 | 语义分割 |
| IDDA [42] | 1M | Carla 平台 | 语义分割 |
| CarlaScenes [43] | - | Carla 平台 | 里程计 |
为解决真实世界数据集标注成本高昂、测试场景受限的问题,依托 Unity 与虚幻引擎(UE)等日益成熟的虚拟引擎获取成套的模拟传感器与标注,已成为一个重要发展方向。随着生成工具的进步,现在已经可以生成面向多任务的合成数据集。本节从传感器套件、目标任务、域偏移等方面总结现有的多任务自动驾驶合成数据集。这些数据集的样例见图 3,对比见表 II。
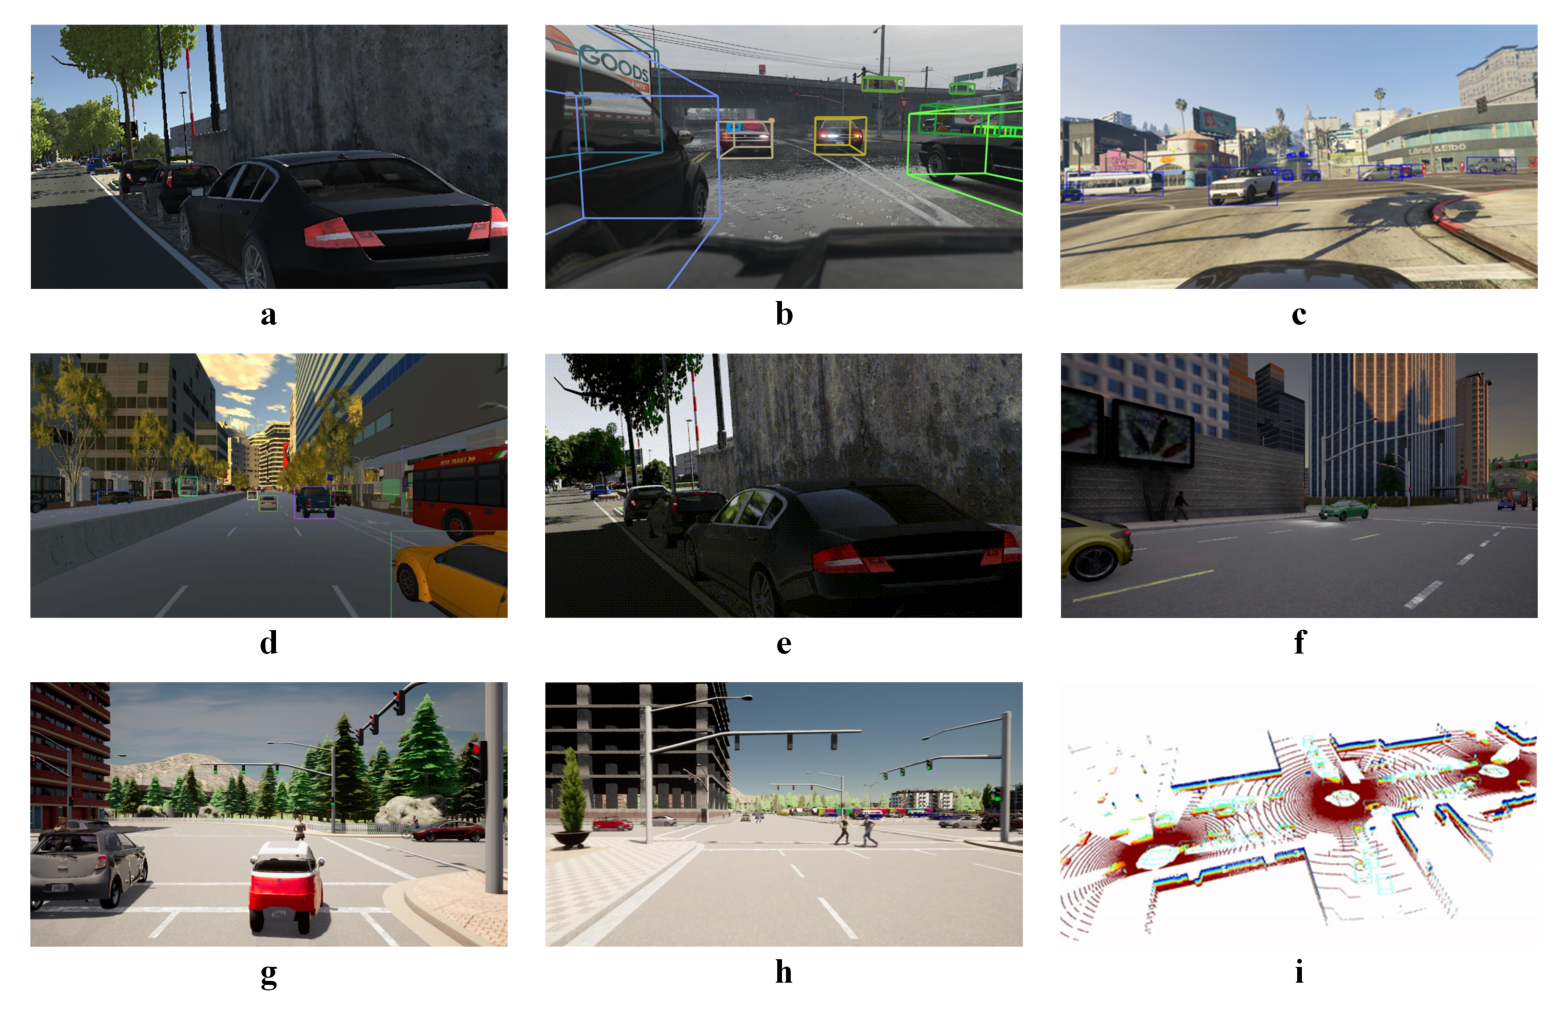
Virtual KITTI(VKITTI)[19] 由 Gaidon 等人于 2016 年发布,是最早开发自动驾驶合成数据集的工作之一。它基于 KITTI 的 5 个真实数据序列,用 Unity 引擎创建了 35 段合成视频,包含约 17,000 帧高分辨率图像。其传感器套件包括一个提供单目视觉图像的 RGB 相机。Virtual KITTI 的每一帧都带有多任务标注:2D 目标检测、多目标跟踪、深度估计、光流估计以及像素级语义与实例分割。域偏移包括不同相机角度、光照条件以及四种天气:晴天、阴天、雾天与大雨。
Virtual KITTI 还首次提出了一个实用的定义与一组实验,以证明其在真实域与合成域之间的有效性与可迁移性。
视觉感知基准(VIsual PERception benchmark,VIPER)[63] 由 Richter 等人于 2017 年开发。该数据集采用一种新颖的方法在 GTA-V 中标注,无需开源代码即可从现代计算机游戏的图形硬件通信中获取数据。VIPER 包含 254,064 帧高分辨率图像,覆盖不同环境条件下总计 184 公里的驾驶、骑行与步行。其传感器套件包括带 GPS 与 IMU 的相机,为 2D/3D 目标检测、多目标跟踪、光流估计、像素级语义分割、稠密实例分割、视觉里程计与相对位姿估计任务提供逐帧标注。域偏移覆盖 5 种不同环境条件:白天(多云)、日落、雨天、雪天与夜晚,以及不同类型的场景(郊区、市中心等)。
VIPER 及其他合成数据集已被与真实数据一起用于训练目标实例分割方法 [71] 与语义分割方法 [72]。通过设计恰当的域自适应方法,模型可以从合成数据中学习有用信息,逼近真实世界最先进的性能。VIPER、SYNTHIA 与 Virtual KITTI 常被用作合成数据源,与来自 KITTI 和 Cityscapes 的真实数据交互。
精确合成图像与 LiDAR(Precise Synthetic Image and LiDAR,PreSIL)[64] 由 Hurl 等人于 2019 年发布,它基于 GTA-V 创建了一个精确的 LiDAR 仿真器,为提取的游戏数据生成 LiDAR 点云图像并增加了更多类型的标注。PreSIL 数据集配备 RGB 相机与 LiDAR,提供超过 50,000 帧高分辨率图像与带全分辨率深度信息的 LiDAR 点云数据。然而,GTA-V 点云中没有可用的反射率(reflectance)值,这对点云分割与检测有负面影响。详细标注面向图像深度估计、语义分割(图像)、逐点分割(点云)、2D/3D 目标检测与多目标跟踪任务。域偏移覆盖不同环境条件。
上述合成数据集也被用于弥合域差距的实验。条件域归一化(Conditional Domain Normalization,CDN)[73] 利用现有的合成数据 Foggy Cityscapes、Virtual KITTI、Synscapes [74]、SIM10K [75] 与 PreSIL,以及真实的 BDD100K、KITTI 与 Cityscapes,构建了真实到真实与合成到真实的自适应基准。
ParallelEye 数据集 [65] 由 Li 等人于 2019 年提出。它由 Unity3D 生成,包含 7 个子数据集、共 40,251 帧。ParallelEye 是一个纯视觉数据集,带有不同朝向的车载相机,提供目标检测、目标牵引(object traction)、深度、光流、实例分割与语义分割的标注。ParallelEye 的图像还具有多样的环境条件——天气(如晴天、雨天、雾天等)与光照(日出、日落等),以扩展其多样性。
研究者在 ParallelEye 数据集与 KITTI、Cityscapes 等真实数据集上开展了域偏移测试实验,以证明其实用性。这项工作也是近期相关工作 ParallelEye 流水线 [76] 的基础,后者提出了一个为自动驾驶生成照片级逼真图像数据的框架。研究者还于 2019 年后续开发了用于视觉智能测试的 ParallelEye-CS [77]。
Virtual KITTI2(VKITTI2)[66] 由 Cabon 等人于 2020 年在 Virtual KITTI 基础上用更新版 Unity 引擎改进而成。Virtual KITTI2 具有更逼真的图像细节与特征,使用与 Virtual KITTI 相同的 5 个真实数据序列构建。除原有相机外,传感器套件增加了第二视角相机以提供双目视觉,从而提供双目 RGB 图像与深度图像。Virtual KITTI2 包含面向 2D 目标检测、多目标跟踪、深度估计、语义/实例分割与光流的完整标注。域偏移与 Virtual KITTI 相同。
一些后续感知工作以 Virtual KITTI 1&2 为实验基础,如 3D 检测 [78]、深度补全 [79],[80]、3D 分割 [81] 等。
SHIFT [67] 由 Sun 等人于 2022 年发布。作为最大的自动驾驶合成数据集,SHIFT 由 Carla 仿真器创建,包含在 8 个不同位置采集的 4,800 多个序列和约 250 万(2.5M)张标注图像。其传感器套件包含 11 种不同的传感器:5 相机多视角 RGB 相机组、双目 RGB 相机组、光流传感器、深度相机、GNSS 传感器、IMU 传感器以及提供视觉图像与点云数据的 128 线 LiDAR 传感器。SHIFT 覆盖 13 个感知任务的标注:2D/3D 目标检测、2D/3D 多目标跟踪、单目/双目深度估计、语义/实例分割、光流估计、点云配准、视觉里程估计、轨迹预测与人体姿态估计。
SHIFT 的特色在于其丰富的域偏移,包括连续与离散的不同场景、天气、时间、交通与人群密度,且每个变量的变化均匀分布。值得注意的是,SHIFT 为域偏移算法提供了基准与实验基础,我们将在第五节介绍这部分内容。
车与万物互联(V2X)-Sim [68] 是第一个面向自动驾驶的协同感知(collaborative perception)合成数据集,由 Li 等人基于 Carla 开发,包含来自 3 个 Carla 城镇 100 个场景的共 10,000 个样本。传感器方面,每辆车配备 6 个不同水平角度的 RGB 相机、一个鸟瞰图(BEV)透视相机、一个全景 32 线 LiDAR、一个 GPS 与一个 IMU,与路侧单元(RSU)的 4 个不同 RGB 相机和 LiDAR 传感器相对应。V2X-Sim 提供车辆与路侧不同水平视角及 BEV 视角的视觉图像与点云数据,为开发和测试协同感知算法提供了实验基础。该数据集为 3D 目标检测、深度估计与像素级语义分割提供精确标注。
V2X-Sim 的另一贡献是最先进协同感知算法的开源测试床(testbed)。凭借充足的合成数据以及检测、跟踪、分割任务的基准,它推动了 V2X 算法的改进。
一体化驾驶(All-In-One Drive,AIODrive)[69] 是 Weng 等人于 2021 年专为高密度长距离点云数据设计的多任务数据集。该数据集包含 100 段视频序列、约 10 万张标注图像以及带 8 种常用传感器套件的点云数据:RGB 相机、双目相机、深度相机、LiDAR、SPAD-LiDAR、毫米波雷达、IMU 与 GPS。特别地,该数据集提供了多种不同密度的 LiDAR 点云数据和一种特殊的长距离高密度类型。同时,AIODrive 也是第一个在公开自动驾驶数据集中提供 SPAD-LiDAR 的。数据集为 2D/3D 目标检测、多目标跟踪、预测、实例分割与深度估计提供完整标注。在域偏移方面,AIODrive 包含丰富的场景地图、恶劣天气以及带有事故与违反交通规则行为的特殊场景。
面向 V2V 通信感知的开放数据集(Open Dataset for Perception with V2V communication,OPV2V)[70] 由 Xu 等人于 2022 年提出,是一个大规模车对车协同感知数据集。该数据集包含 11,464 帧与 232,913 个带标注的车辆 3D 框,并提供了多达 16 个模型的综合基准,以评估融合策略与先进的目标检测算法。数据集传感器包括 4 个 RGB 相机、一个 64 线 LiDAR、一个 GPS 与一个 IMU,为研究者提供带标注的 RGB 图像、LiDAR 点云数据与 BEV 感知图像。OPV2V 数据集支持使用相机或 LiDAR 传感器的协同 3D 目标检测、BEV 语义分割、跟踪与预测。同时,用户可以通过添加额外传感器来定义任务,如深度估计、传感器数据融合等。其域偏移覆盖 70 个不同场景,地图来自 Carla 中构建的 8 个虚拟城镇以及洛杉矶真实 Culver City 的数字复刻。
得益于这些数据集的可用性,协同感知算法的发展得以推进。以时延感知感知系统 SyncNet [82] 为例,它在 V2X-Sim 上测试,验证了其性能优势与鲁棒性。其他协同感知工作,如 CoAlign [83] 与 Where2com [84],也在 OPV2V、V2X-Sim 以及真实世界协同数据集 DAIR-V2X [85] 上做实验。
| 数据集 | 帧数 | 传感器 | 任务 | ||||||||||
|---|---|---|---|---|---|---|---|---|---|---|---|---|---|
| 单目相机 | 双目相机 | LiDAR | 雷达 | 2D 检测 | 3D 检测 | MOT | 分割 | 深度 | 光流 | 位姿 | 预测 | ||
| VKITTI [19] | 17K | ✓ | - | - | - | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | - |
| VIPER [63] | 250K | ✓ | - | - | - | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | - |
| PerSIL [64] | 50K | ✓ | - | ✓ | - | ✓ | ✓ | ✓ | ✓ | - | - | - | - |
| ParallelEye [65] | 40K | ✓ | - | - | - | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | - | - |
| VKITTI2 [66] | 17K | ✓ | ✓ | - | - | ✓ | - | ✓ | ✓ | ✓ | ✓ | - | - |
| SHIFT [67] | 2.5M | ✓ | ✓ | ✓ | - | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ |
| V2X-Sim [68] | 10K | ✓ | - | ✓ | - | ✓ | ✓ | - | ✓ | ✓ | - | - | - |
| AIODrive [69] | 100K | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | ✓ | - | - | ✓ |
| OPV2V [70] | 11K | ✓ | - | ✓ | - | ✓ | ✓ | - | - | - | - | - | ✓ |
随着合成数据集的发展,迫切需要对它们进行彻底的评估。这些评估至关重要,因为合成数据集是自动驾驶应用中训练与测试的基础。本节为合成数据集提供综合评估:我们先给出一个评估框架并总结常见评估方法;然后讨论域差距测试以及弥合合成数据集与真实世界数据集之间鸿沟的途径;最后,针对阻碍自动驾驶部署的可信性与安全性问题,并为了避免捷径学习(shortcut learning)[86] 与长尾 [87],[88] 陷阱,我们强调需要在整个数据开发与系统测试过程中牢记这两条教训。
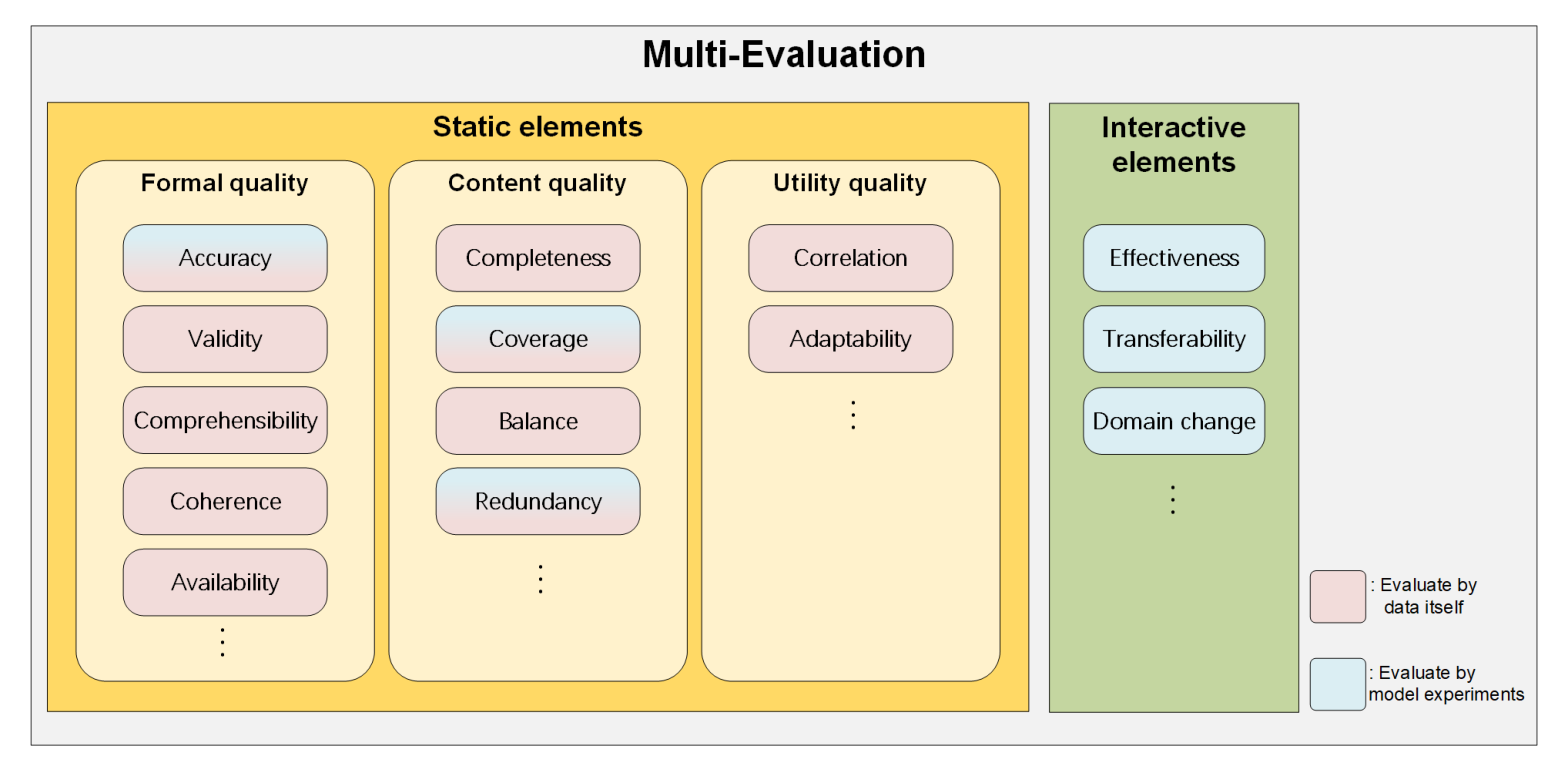
面向自动驾驶的合成数据集在促进真实世界感知任务、算法优化与可信性评估方面发挥积极作用。然而,目前尚无被普遍接受的合成自动驾驶数据集评估标准理论。这里,我们考虑两大类元素来评估数据集:静态元素与交互元素。见图 4。
静态元素包括数据本身的静态属性,从三个方面描述数据:内容质量(content quality)、形式质量(formal quality)与效用质量(utility quality)。
形式质量包括数据集的准确性、有效性、可理解性、连贯性与可用性,从数据表达与形式的角度评估数据集。准确性(Accuracy)是对文件与数据的基本筛查,选出符合格式的文件以避免信息偏差与错误,从而影响后续工作;有效性(Validity)主要考虑数据集所描述的概念与对象和实际目标的关系,即数据集是否与实际目标一致、能否有效应用于真实世界的目标;可理解性(Comprehensibility)指数据集反映业务逻辑的能力,可从主观与客观两个视角评估,以判断字段与取值的清晰度;连贯性(Coherence)用于判断是否存在由传输线路、采集设备等故障引起的数据不连续现象;可用性(Availability)主要考察获取数据集的难易程度,避免使用非常规手段获取的数据与不基于原理的数据。同时,数据应满足通用性要求,避免极端且难以复现的数据。
内容质量包括数据集的完整性、覆盖度、均衡性与冗余性,主要描述数据集包含的具体信息以及它能否满足用户需求。完整性(Completeness)涉及对场景中所有元素整体情况的分析与评估,可以从数据需求类型的静态与动态两方面考察。覆盖度(Coverage)则从更宏观的视角评估数据集类型的完整性,涵盖场景覆盖与数据集覆盖。好的数据集应包含各种可能的场景,覆盖大多数潜在情况,并兼顾信息不完全、复杂环境、高实时性要求等功能。均衡性(Balance)围绕评估指标之间的比例平衡展开,主要分为元素均衡与场景均衡。元素均衡旨在度量数据集内各类元素之间的均衡;场景均衡指多样化场景的均衡,包括天气条件、移动场景、极端情况等。冗余性(Redundancy)检查数据集内重复的部分,防止过度冗余导致模型过拟合。这可以从动态与静态两个视角评估,包括行为与元素两个方面来考察数据冗余。数据冗余度量数据的重复,而元素冗余更关注静态元素内部的冗余。
效用质量包括相关性与适应性,描述需求特征与发展空间。相关性(Correlation)指数据集与实际目标之间的对应程度,即数据能否满足实际需求并被有效、充分地利用;适应性(Adaptability)用于评估数据的可扩展性以及编辑与重组场景的能力。具体而言,它可以分为可编辑性(editability)、可扩展性(scalability)与可重构性(reconstructibility)。可编辑性一般描述软件、数据或计算机语言变更的可控性质,即在保持某些部分或方面不变的同时改变其他部分,以判断能否满足使用需求。可扩展性意味着当面对新的任务需求时,能够通过一定手段从现有数据派生或生成新数据。可重构性指其内部结构被改造的难易程度,以及面对新的测试任务时能否通过调整结构来满足新需求。
静态元素的质量可以从数据获取与数据处理两方面讨论。数据获取层面是对数据本身相对于任务的评估,包括数据完整性、标签丰富度与场景均衡性 [89]。这类静态元素通常可以直接从发布信息中评估并相对直接地比较。数据类型或标签能否满足模型训练任务的需求,以及天气、周边环境等背景元素与场景的分布是否均衡,都可以从数据描述、传感器套件、域偏移等信息中判断。不过,有些静态元素,如准确性与覆盖度,需要人工整理与分析,但在应用于机器学习特定任务时也会自动体现。还有一些方法可以在数据处理层面评估并改进静态元素得分。常见数据处理方法包括数据清洗与数据增强。数据清洗检测有害样本点(如标签错误),并通过置信学习(confident learning)[90],[91] 或其他框架将其剔除以提升质量。数据增强 [92],[93] 作为低成本、有效的方法,已被广泛用于在数据受限环境中提升机器学习模型的性能并降低误差,它可以通过修改当前样本或融合多个样本来实现 [94]。
交互元素描述数据集如何作用于感知等算法或其他数据集,例如训练、测试、改进、比较模型以及评估系统的性能。一方面,交互元素由数据集的静态元素决定,因为所配备的传感器种类限制了对某类算法实验的支持;另一方面,它也受数据集所含数据固有分布以及合成与真实世界之间差距的影响。如何定性与定量分析合成数据集的交互元素,例如对算法的有效性及其他影响,一般需要借助实验来评估。在评估方法上,主要考虑模型的效果,下面讨论几个评估方面。
对算法训练的有效性。在判断合成数据集能否有效训练算法模型或提升算法性能方面,一个相当直接的方法是用合成数据集训练模型,然后在指定的真实世界环境中测试。然而,由于合成数据与获得的真实世界数据之间往往存在一定的数据差距,模型的训练结果常常不如原始真实数据集的训练结果。Virtual KITTI [19] 数据集在发布时提出了一套测量方法,通过比较合成数据训练结果、真实数据训练结果以及先用合成数据预训练再用真实数据微调的结果来评估算法性能。通过对比,证明合成数据集是真实世界的有效补充,可以提升算法性能。
在 SYNTHIA 数据集中,采用 Ros 等人 [95] 提出的均衡梯度贡献(balanced gradient contribution,BGC)方法来优化算法模型,证明合成数据是真实世界的有效模拟与补充。大多数合成数据集,如 VIPER,也把基准算法在其自身数据集及其他主流数据集上的训练性能作为主要度量指标,并通过比较测试结果来判断数据集的真实性、挑战性与质量。
结论的可迁移性。Virtual KITTI 数据集通过展示真实序列与克隆序列之间多目标跟踪算法性能的有限差距,证明了结论在合成数据集与真实世界结果之间的可迁移性。在 SHIFT 数据集中,通过比较 SHIFT 本身与 BDD100K 在相同离散域偏移下、多个感知任务中模型性能的趋势,评估了合成数据集实验结论的可迁移性。
合成数据集的域变化功能。合成数据集可以通过测试算法在不同域偏移子集下的性能退化,来评估模型的鲁棒性与过拟合。它还可以用于测试不同的数据增强方法与训练策略如何降低域偏移问题的不利影响。
SHIFT 数据集使用不同的先进域自适应策略 [96],[97],[98],[99],[100],在离散与连续域偏移下测试多种感知算法的性能,并用 Softmax [101]、MCDO [102] 与 Deep Ensembles [103] 方法估计期望校准误差(expected calibration error,ECE)。其他方法,如 CDN [73] 与平行视觉(parallel vision)[71],则利用 Virtual KITTI、VIPER 等来支撑其结果。上述实验证明,合成数据集为域自适应算法研究提供了实验平台,并强调了域变化覆盖面与细粒度划分对合成数据集的重要性。
合成数据集的真实性是学术界与工业界热议的话题。这些数据集使用先进仿真平台生成大量自标注数据,为真实世界数据采集提供了快速补充。然而,弥合合成数据集与真实数据集之间域差距的挑战依然存在。差距主要有两类:外观(appearance)与内容(content)。外观差距指像素级或实例级差异,如颜色、材质、纹理与亮度;内容差距主要包括任务标签分布与场景布局的差异 [104],[105]。我们还基于 RGB-D 图像与点云提出一些弥合这些差距的方法。
我们可以使用配备高质量渲染器、逼真传感器模型与精细 3D 物体模型的更先进仿真平台,来缩小合成数据集与真实世界数据集之间的外观差距。例如,NVIDIA 的 DRIVE Sim 软件利用 Omniverse 中的 RTX 路径追踪渲染器,为相机、雷达、LiDAR 与超声波传感器生成物理精确的传感器数据。
为进一步弥合合成数据与真实世界数据之间的差距,研究者正在探索生成更逼真合成数据集的方法,包括域随机化(domain randomization)[104],[106],[107],[108]、图像翻译(image translation)[109],[110],[111] 与无监督域自适应 [112],[113],[114],[115],[116]。具体而言,Tremblay 等人 [107] 提出一种域随机化技术:在仿真环境中刻意引入随机变化,以提升识别物体本质特征的能力。结果表明,仅用域随机化的合成数据训练有效的目标识别模型是可能的,其性能与其他处理过的数据集相当。Tsai 等人 [112] 提出,对语义分割而言,源域与目标域的图像具有很高的空间相似性。基于这一想法,他们提出了一种在输出空间使用对抗学习的域自适应算法,利用空间与局部信息在像素级预测结构化输出。仿真结果表明,该方法能有效适应合成到真实数据之间以及不同城市之间的域变化。
仿真器也提供了一些方案,例如 DRIVE Sim 仿真软件包含各种 3D 物体模型与域随机化功能,用于组织不同的数据生成场景。然而,我们仍需改进所生成数据集的域自适应,并确保它们即使在真实世界图像数据上也具有良好的泛化能力。常用的填补内容差距的技术包括用伪标签自训练(self-training with pseudo-labels)[116],[117],[118] 与自动学习生成场景 [119],[120],[121]。特别是,Yu 等人 [116] 使用优化后的伪标签与纠错训练流程进行自训练。训练过程包括伪标签初始化、自训练以及用更好标签的迭代,从而在目标域中用高质量伪标签完成数据集标注。伪标签以相近的内容分布到目标域,从而帮助缩小内容差距。Kar 等人 [119] 提出 Meta-Sim 方法来获得与真实数据相当的仿真数据。该方法用神经网络参数化数据集生成器,学习如何修改场景图(概率场景文法)的属性,缩小生成数据分布与真实数据分布之间的差距,从而提升图像质量。
总体而言,合成数据集与真实数据集中的数据分别分布于两个差异很大的域。虽然可以通过上述特定手段缩小域差距,但用合成数据集训练的模型仍需要在真实数据集上微调,以同时学习两个域的特征并应用于真实场景。然而,这种预训练加微调的学习模式也有缺点,例如浪费计算资源、学习结果欠佳。如果可以基于实际采集的数据进行高保真的虚拟 3D 重建或渲染,就可以轻松生成与真实数据分布非常相似的虚拟数据。在这样的数据上训练的模型可以直接应用于真实场景,无需先用合成数据预训练再用真实数据微调的过程。
自动驾驶数据集使用的传感器是多模态的,因此采集的数据主要基于 RGB-D 相机拍摄的图片以及雷达与 LiDAR 捕获的点云。在生成合成数据集的过程中,图像提供的信息可用于生成新视角的图像,但缺点是 2D 图像无法提供全面的 3D 信息,且容易受遮挡影响。点云虽能提供直观的 3D 结构信息,缺点是缺乏语义信息,而且室外场景生成的点云非常稀疏且不准确。
RGB-D 图像。对于车载相机或路侧相机拍摄的多角度图像,神经辐射场(NeRF)及其变体 [122],[123],[124],[125],[126] 可以利用隐式 3D 表示,通过重新渲染场景的不同角度来进行数据生成。NeRF 是最近提出的 3D 场景重建与新视角合成方法。NeRF 的核心思想是把场景表示为一个连续的 3D 函数,该函数可以评估空间中任意点以获得对应的颜色与不透明度。该函数由神经网络建模,在一组输入图像及对应相机位姿上训练。NeRF 及其变体代表了使用深度学习进行 3D 场景重建与新视角合成的重大进展。把场景表示为连续函数、捕捉精细细节以及光照与纹理变化的能力,使 NeRF 成为在虚拟现实、游戏、机器人等广泛领域中应用的新兴技术。
点云。由于车载 LiDAR 扫描室外场景获得的点云比室内场景至少稀疏一个数量级,语义场景补全(semantic scene completion)对于恢复 3D 场景表示变得非常重要。SSCNet [127] 首次将 3D 形状补全与语义场景标注结合在一起,并通过实验证明这两种不同的任务可以互相启发,同时完成两项任务的端到端算法优于单独的场景重建或语义分割。然而,基于 3D CNN 的一系列工作 [128],[129],[130] 的主流输入形式是深度图或 RGB-D 图像等 2D 图像,而 S3CNet [131] 面向大场景中的稀疏点云做语义场景补全,两类方法都对细化合成数据集的采集发挥重要作用。
此外,还可以进行一些迁移合成,例如利用桌面数据集 [132],[133] 或 3D 形状数据集 [134] 来丰富自动驾驶室外数据集的合成。例如,对一般物体使用截断符号距离函数(truncated signed distance function,TSDF)[135] 等方法,对人体使用蒙皮多人线性(SMPL)模型 [136] 或隐式场 [137] 等方法,可以重建桌面、室内物体或行人的 3D 表示并迁移到室外场景。借助 ShapeNet [134],自动驾驶场景中不常出现的物体也可以被迁移到自动驾驶合成数据集中,解决自然数据的长尾分布问题并丰富边缘数据分布。这不仅丰富了自动驾驶数据集所涵盖的数据范围,也提升了其生成的灵活性。
对研究者而言,可信性与安全性始终是自动驾驶算法的最高优先级。由于自动驾驶特殊的应用场景,一个微小的错误就会对人身安全与财产构成严重威胁。在《美国国家人工智能研究与发展战略计划》[138] 中,自动驾驶算法的有效评估方法也被列为最重要的问题之一。
评估 AI 可信性的一个重要方式是基于数据开展合理的测试与实验。面对日益先进的人工智能算法,更多研究者意识到数据质量极大影响模型的泛化性与可靠性。数据集及其标签中学到的虚假关联与偏差会严重降低可信度 [139]。因此,专注于数据设计与数据生成路径,以便可靠地监控与评估模型的生成过程,极具价值。在可信性方面,分布的良好覆盖与标签的细粒度划分对后续测试意义重大,为此,建立可持续迭代、社区共建的数据集平台是满足上述需求的重要手段。
关于可信性的评估方法,可以用消融实验的思想来评估数据质量:在模型训练中移除不同子集,观察 AI 的性能变化 [89],例如计算数据集的 Shapley 值以实现公平估值 [140],[141],[142],[143]。数据集的清洗也可以通过预测数据的不确定性 [90] 来完成,从而提升训练模型的可信度。此外,合成自动驾驶数据的标注来自场景模型的自动生成。与人工标注相比,它不仅降低成本,还减少了人工作业的偏差误差,并且通过聚合标签降低噪声的方法,可信性得以进一步提升。Li 等人 [160] 还提出了面向 AI 信任的 SE 方法,包括保障质量与信任的智能与指标(I&I)、保障结果质量与部分性能的校准与认证(C&C),以及保障正确运行流程与输出的验证与确认(V&V)[144]。2023 年提出了 SEEFMM 框架的相关工作,包含面向基础模型信任模型的六个层级 [145]。
对自动驾驶算法的安全评估而言,使用自然采集的数据集在重要场景上面临严重的长尾问题。根据加利福尼亚州机动车管理局(DMV)的数据,安全驾驶的关键场景平均每行驶 30,000 英里才出现一次 [146]。如此低的频率使安全测试往往需要巨大的经济与时间成本,尤其是因为这种长尾分布要求评估方法按概率收敛,以确保结果的可信度。一些重要方法,如重要性采样(importance sampling,IS)[147],[148] 与过采样 [149],通过优化采样与分布密度估计技术来处理长尾分布。另一些方法在训练过程中通过调整交叉熵(CE)[150]、logit 函数 [151] 或归一化权重 [152] 来平衡稀有标签。然而,上述方法在面对更复杂的分布问题时往往遭遇瓶颈,难以准确估计安全风险。其他保障日常驾驶安全的直接途径是扩大真实数据集的覆盖面,即扩展感兴趣的场景 [153],或对场景评分以从长尾分布中偏置数据选择 [154],不过这需要昂贵的实验。这些想法同样可以通过合成数据来采纳并规避其缺点。
因此,另一种解决方案是专门为安全测试设计具有泛化能力的重要场景数据,例如先前使用对抗生成 [155],[156],[157] 或知识 [158],[159] 来合成面向任务的安全测试数据集的工作。目前也有平台为此类测试提供实验条件。例如,SafeBench 平台在安全测试中提供 2,352 个生成的安全关键场景(如直行障碍物与变道的良性场景),其评估结果基于碰撞率、闯红灯频率、平均路径完成率等十项指标 [139]。
本节在数据集样例上开展一系列评估实验。我们展示了多维度评估、安全性与可信性的评估结果,然后指出可能的补充生成方向以提升数据集质量。
为证明多维度评估框架的有效性,我们首先选取两个合成自动驾驶数据集做静态元素评估:Virtual KITTI 数据集与 SHIFT 数据集。采用我们的评估方法,我们使用网络分析法(Analytic Network Process,ANP)[160],[161] 来分析形式质量、内容质量与效用质量各指标之间的关系,形成指标关系网络,从而计算权重。我们给每个准则赋予最高 5.00 分,并根据前述指标的定义与计算公式确定客观得分。通过应用 ANP 方法生成的权重,我们可以计算一个全方位的分数,综合评估各类自动驾驶数据集。评估结果与指标权重见表 III。
在形式质量方面,对准确性、有效性与连贯性,我们选取数据集中正确数量占总数的比值作为得分。对可理解性,我们用单张图像的质量评估指标(如 PSNR 与 SSIM [162])来计算;对可用性,通过计算其时间成本与空间成本,并用层次分析法(Analytic Hierarchy Process)[163],[164] 得出得分。在内容质量方面,我们人工计算各类元素与场景相关的分布来确定完整性与覆盖度得分,并综合结果得到连贯性得分。在冗余性方面,我们计算时间冗余与元素冗余的百分比,并取加权平均得到相应的质量得分。在效用质量方面,相关性反映数据集能否满足实际需求、能否针对实际目标被有效且充分地利用,可以由特定感知任务下所有数据集中有效数据集的占比确定。在适应性方面,比较使用当前数据集训练模型再应用于其他数据集时的性能退化,作为评估准则。对于网络分析法,不同权重之间的重要性关系与元素影响基于用户需求设定,并使用 Super Decision(SD)软件 [165] 获得各指标的权重,从而得到数据集的整体质量。
| 数据集 | Acc | Val | Com | Con | Ava | E.C. | Cov | Bal | Red | Cor | Ada | Overall |
|---|---|---|---|---|---|---|---|---|---|---|---|---|
| Virtual KITTI | 5.00 | 5.00 | 5.00 | 5.00 | 4.80 | 3.84 | 4.52 | 4.24 | 4.78 | 4.75 | 4.50 | 4.73 |
| SHIFT | 5.00 | 5.00 | 5.00 | 5.00 | 4.60 | 4.67 | 4.80 | 4.58 | 4.71 | 4.90 | 4.60 | 4.84 |
| 权重 | 0.061 | 0.040 | 0.176 | 0.064 | 0.034 | 0.039 | 0.046 | 0.126 | 0.121 | 0.148 | 0.152 | 1.000 |
根据表格,我们可以得出一些结论。总体而言,SHIFT 数据集的质量高于 Virtual KITTI 数据集。首先,两个数据集在形式质量上都很优秀——对自动驾驶合成数据集而言,遇到形式错误并不常见,而且与真实世界数据集相比通常更具成本效益。然而,与 Virtual KITTI 相比,SHIFT 数据集规模大得多,可能需要根据用户需求改变天气,因此其可用性低于 Virtual KITTI。在内容质量方面,Virtual KITTI 数据集的主要缺陷是只包含车辆,缺乏行人、骑行者等其他交通参与者,并且不包含夜间数据。这些场景在驾驶中经常遇到。相比之下,SHIFT 数据集表现出更优的性能。不过,就效用质量而言,合成数据集与真实世界数据集之间的差异不可避免:合成数据集的可扩展性与相关性往往较差。要在真实世界场景中应用合成数据集,必须弥补这些差距,以确保模型的可用性。
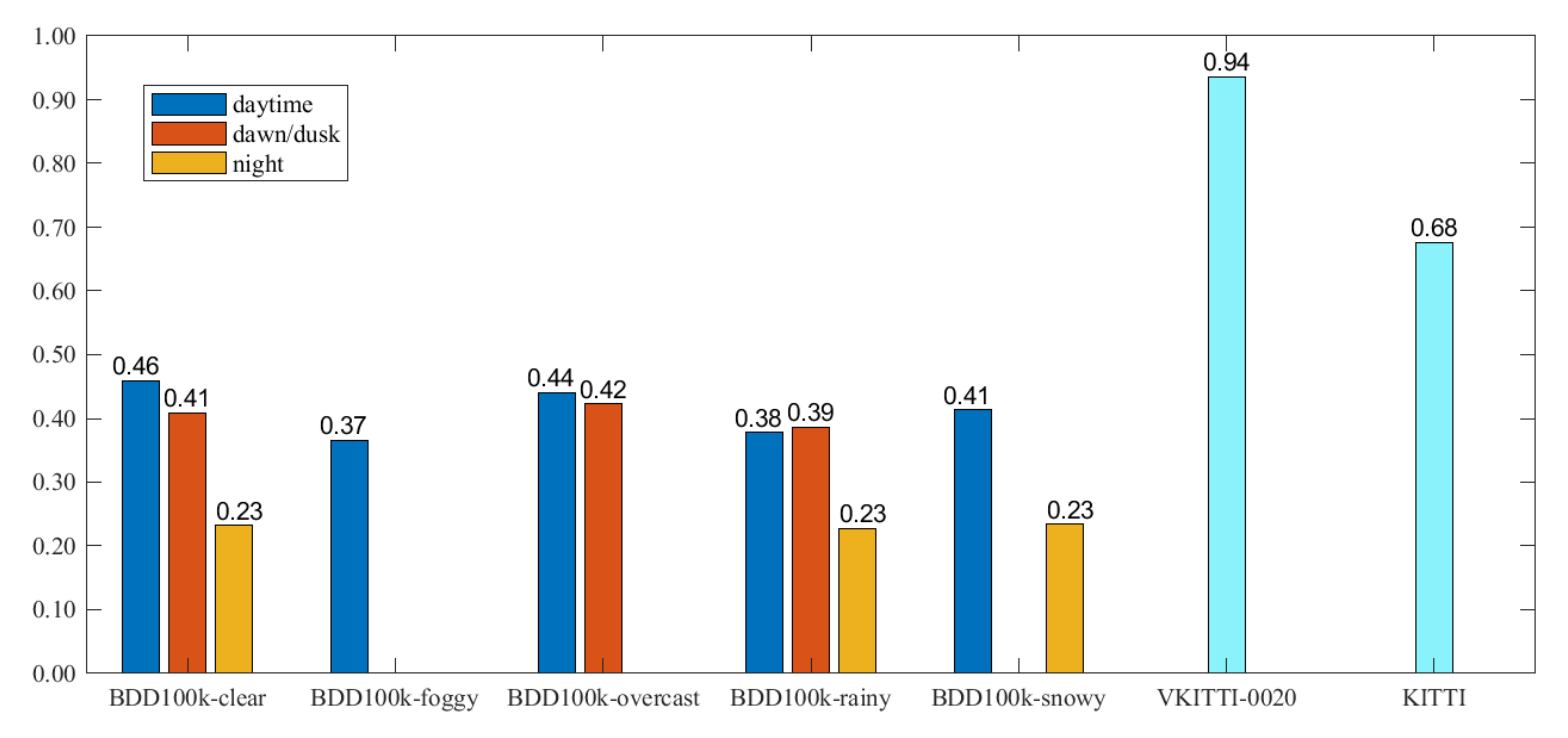
至于交互元素,我们还在 Virtual KITTI 上进行域偏移测试,以估计其可迁移性以及在不同条件下的安全性。我们在视频 0001、0002 与 0006 上训练 2D 车辆检测模型 YOLOv5s,并在 Virtual KITTI 0020、来自 KITTI 的 3,769 张图像随机子集以及来自 BDD100K 验证集的约 10,000 张图像上测试。为更细致地探究域偏移性能,我们按一天中的时间与天气划分 BDD100K 验证集中的图像(排除图像数少于 50 张的条件)。结果如图 5 所示。我们还计算了相对鲁棒性(relative robustness)R,其定义为
以展示不同条件的影响,R 矩阵见表 IV [166]。注意,模型在原始 Virtual KITTI 测试集上表现最好。由于 Virtual KITTI 模仿 KITTI 数据集,它在 KITTI 上也有相对较好的表现。对于 BDD100K 数据集的可迁移性实验,由于域差距,性能出现下降。最差的三项性能以红色标出,显然,它们都是 BDD100K 中的夜间场景。如前所述,Virtual KITTI 没有夜间场景的数据,因此这一结果是合理的。这也表明,要进一步提升 Virtual KITTI 的质量、使其在更宽的条件范围内更安全,补充夜间场景可能会很有效。
| 天气 \ 时间 | 白天(Daytime) | 黎明/黄昏(Dawn/Dusk) | 夜晚(Night) |
|---|---|---|---|
| 晴天(Clear) | 0.491 | 0.437 | 0.249 |
| 雾天(Foggy) | 0.392 | 0.452 | - |
| 阴天(Overcast) | 0.471 | 0.413 | - |
| 雨天(Rainy) | 0.404 | 0.413 | 0.244 |
| 雪天(Snowy) | 0.442 | - | 0.250 |
我们采用数据清洗(data-clean)算法作为可信性测试的示例,因为尽管合成数据集已经基于物体位置获得了自动标注,但有时可能存在遮挡与不完整(比如人被卡车挡住从而导致标注问题)。具体而言,我们使用 Cleanlab [90] 评估 Virtual KITTI 中标签的质量。该方法既可以使用在其他数据集(如 KITTI)上预训练的模型,也可以使用自训练模型进行交叉验证。通过这类方法,我们可以回溯并移除不恰当的标注,进一步提升合成数据集的可信性。
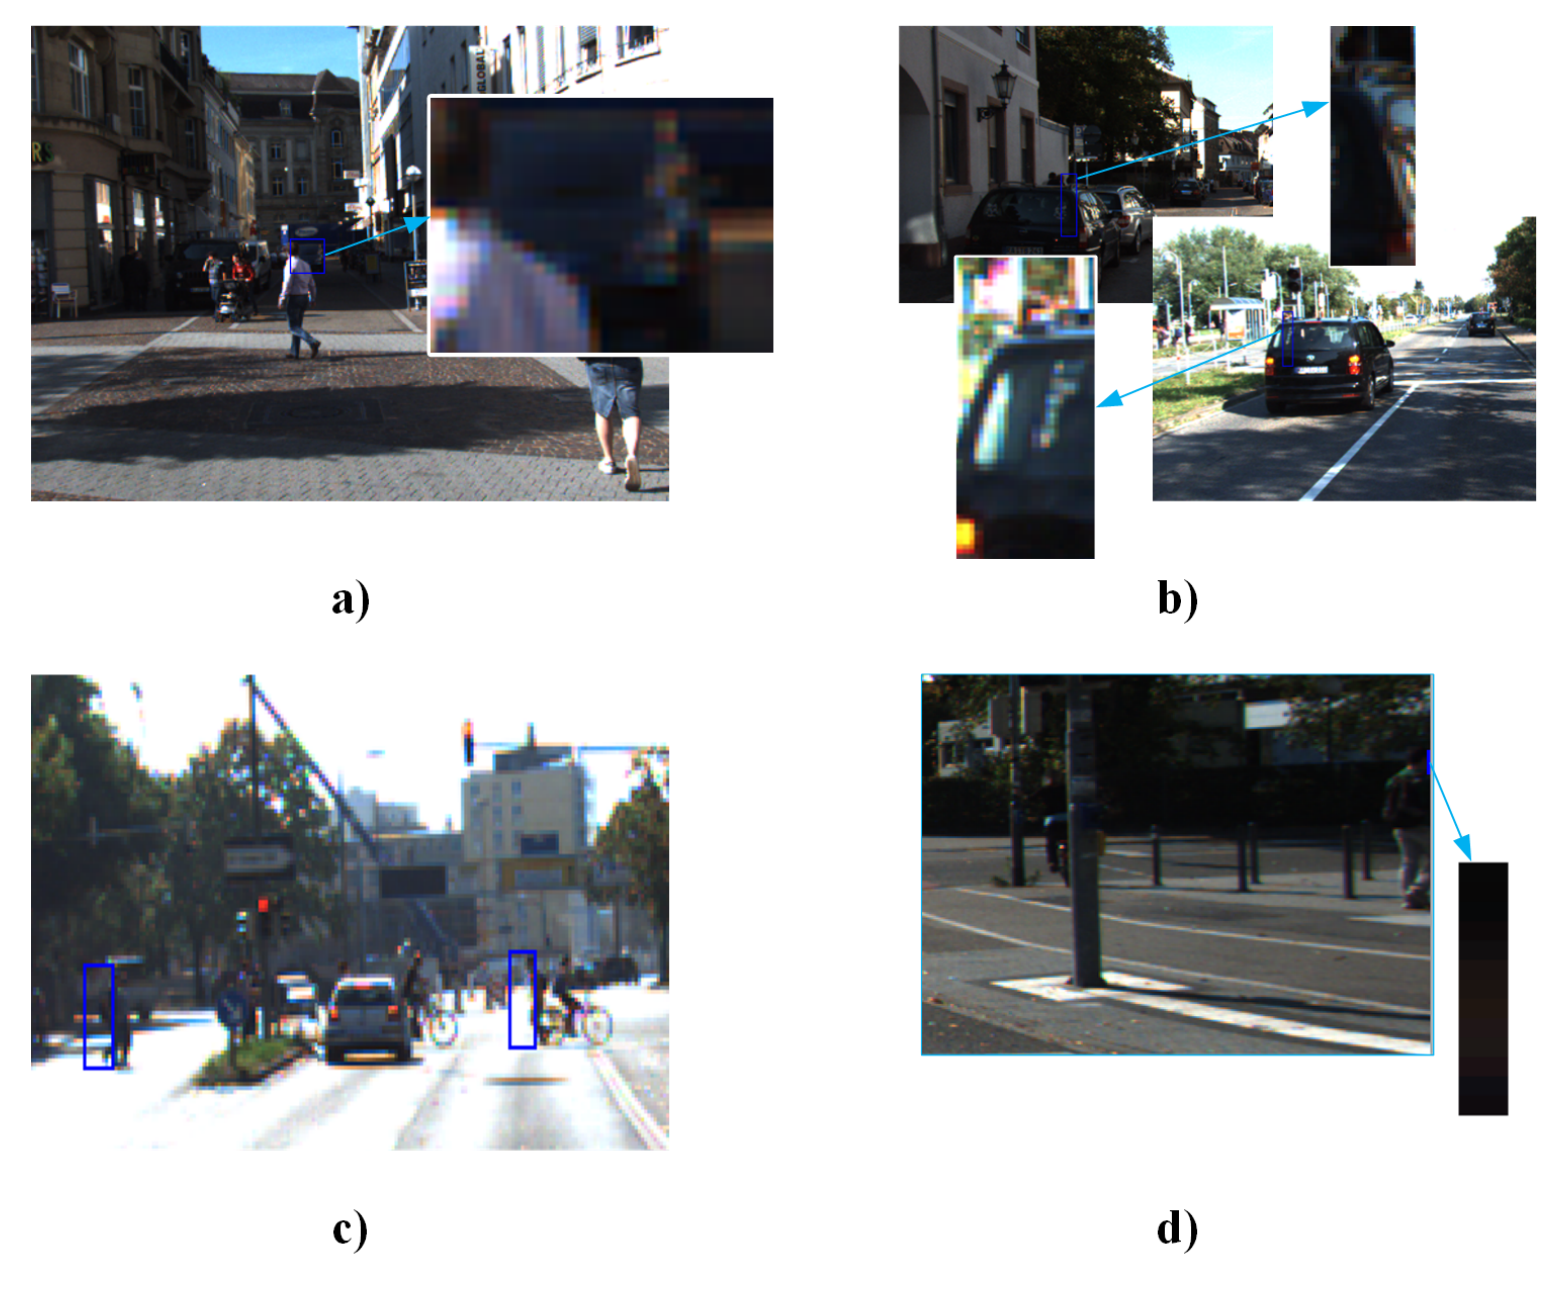
见表 V。我们使用 Virtual KITTI 与 KITTI 作为实验来源。我们先分别从 Virtual KITTI 与 KITTI 训练两个模型,然后用这两个模型评估两个测试子集的标签质量。由于 Cleanlab 是为图像分类任务设计的,我们先用原始标注把图像切分为物体图块,再用模型推断类别概率来进行评估。如表 V 所示,Virtual KITTI-v0020 中的标签是精心挑选的(DontCare 类)且干净的,这证明了合成数据集数据质量的优势。为进一步探究该方法的可用性,我们随机把 Virtual KITTI-v0020 中的 100 个标签(称为 Corrupted-v0020)改成错误标签,Cleanlab 用 KITTI 训练的模型在 459 个标签问题中报告了其中 84 个,用 Virtual KITTI 模型则报出 96 个、命中全部 96 个。对 KITTI 数据集,我们用 KITTI 训练的模型在其测试集上做清洗工作,在 3,769 张图像中报告了 709 个标签问题。在这些报告的问题中,一些是严重模糊且被严重遮挡的(可能被标为 DontCare),一些存在标注位置错误,一些被错误标注,还有许多是误报。见图 6。因此,这类可信性测试与人工核验可以提升合成数据集的可信性。
| 数据集 | 模型 | 总标签数 | 真实标签问题 | 报告标签问题 | 标签健康分 |
|---|---|---|---|---|---|
| Virtual KITTI-v0020 | KITTI | 31,775 | - | 0 | 1.00 |
| Virtual KITTI-v0020 | Virtual KITTI | 31,775 | - | 0 | 1.00 |
| Corrupted-v0020 | KITTI | 31,775 | 100 | 459 | 0.99 |
| Corrupted-v0020 | Virtual KITTI | 31,775 | 100 | 96 | 1.00 |
| KITTI-test | KITTI | 17,558 | - | 709 | 0.96 |
合成数据集在开发过程中展现出巨大前景,但并非没有局限。一个主要挑战是充分表征真实世界的复杂性。例如,合成数据可能难以捕捉天气条件变化或高度动态交通场景的细微差别。研究者应致力于提升合成数据集的真实性与多样性。这可以通过改进数据生成技术、更精细的仿真以及引入真实世界数据做校准来实现。另一方面,自动驾驶领域的大多数合成数据集聚焦于环境感知任务,缺少面向驾驶员行为分析与决策学习的数据集。应该设计更多合成数据集来解决这些问题。
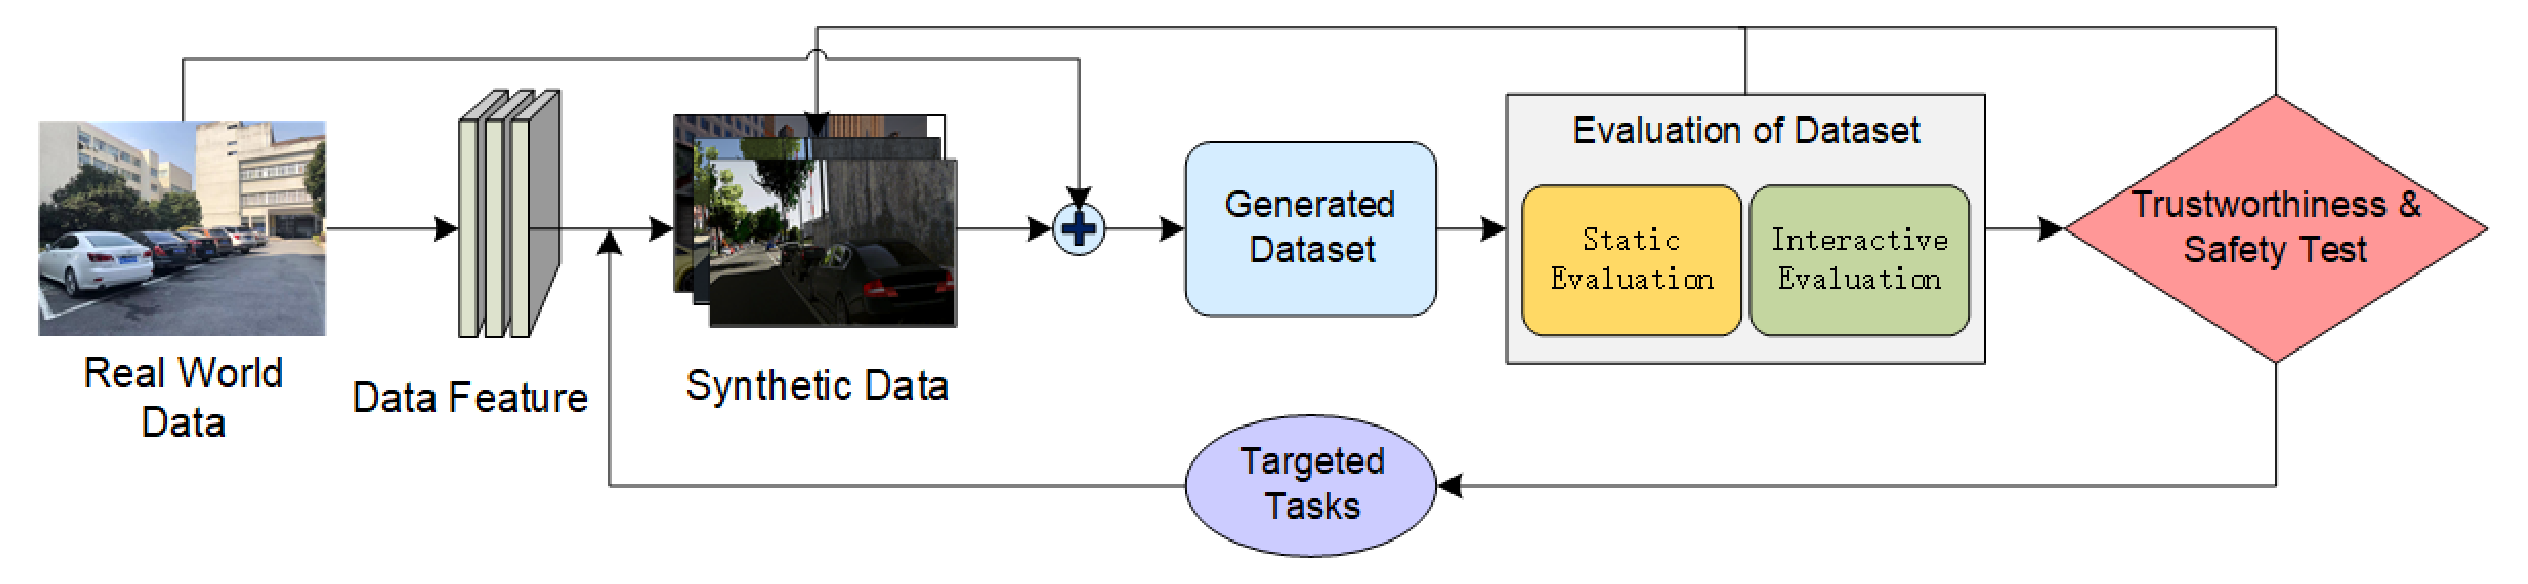
在不断进步的自动驾驶研究领域,高质量数据集的可用性至关重要。为全面满足这一需求并克服合成数据集的局限,我们提出了一套系统化的合成数据集生成流程。如图 7 所示,该流程旨在产出可信的合成数据集,使其能够被有效评估并持续改进,以满足自动驾驶研发的具体需求。这将为合成数据集指明方向。
我们这套系统化流程的创新在于引入了反馈回路。我们认为,数据集生成不是一次性工作,评估与再生成的工作应当贯穿整个开发过程。在生成步骤之后,合成数据集被用于综合评估,包括第六节提到的多维度评估、可信性与安全性测试,以评估其质量,进而用于在目标任务上训练与评估自动驾驶算法。此外,评估与模型使用的结果被反馈到数据集生成步骤,开启迭代改进过程。评估结果(例如自动驾驶车辆道路测试的实验数据)为数据集的调整与增强提供依据,解决评估阶段发现的任何缺陷或偏差。这种迭代方法确保合成数据集被持续完善,以更好地反映真实世界驾驶场景的复杂性,并促进感知算法的开发。
此外,未来的研究者还需要探索如何弥合合成数据集与真实世界数据集之间的差距,并评估所生成数据的有用性。正如我们在推广自动驾驶产品时强调可信性与安全性,数据开发应应用于自动驾驶车辆测试的全过程,以帮助迭代。如何扩展边角案例的覆盖、解决长尾问题,同样极具价值。
本文对自动驾驶车辆的合成数据集做了综述。它首先概述了这些数据集的生成流程,并将其分为单任务与多任务两类。然后我们提出了一种从两方面评估数据集的实用方法,并讨论了模型训练中呈现的有用性评估,弥合合成数据集与真实世界数据集之间的差距。随后探讨了评估这些合成数据集面临的挑战,包括弥合合成数据与真实世界数据差距的策略。最后,我们强调合成数据集对自动驾驶可信性与安全性的重要性,并介绍了若干有前景的合成数据生成方向,以此结束本研究。
[1] A. Geiger, P. Lenz, C. Stiller, and R. Urtasun, "Vision meets robotics: The kitti dataset," The International Journal of Robotics Research, vol. 32, no. 11, pp. 1231–1237, 2013.
[2] P. Sun, H. Kretzschmar, X. Dotiwalla, A. Chouard, V. Patnaik, P. Tsui, J. Guo, Y. Zhou, Y. Chai, B. Caine et al., "Scalability in perception for autonomous driving: Waymo open dataset," in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2020, pp. 2446–2454.
[3] F. Yu, H. Chen, X. Wang, W. Xian, Y. Chen, F. Liu, V. Madhavan, and T. Darrell, "Bdd100k: A diverse driving dataset for heterogeneous multitask learning," in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2020, pp. 2636–2645.
[4] R. He, S. Sun, X. Yu, C. Xue, W. Zhang, P. Torr, S. Bai, and X. QI, "Is synthetic data from generative models ready for image recognition?" in The Eleventh International Conference on Learning Representations, 2022.
[5] G. Paulin and M. Ivasic-Kos, "Review and analysis of synthetic dataset generation methods and techniques for application in computer vision," Artificial Intelligence Review, pp. 1–45, 2023.
[6] S. I. Nikolenko, Synthetic data for deep learning. Springer, 2021, vol. 174.
[7] D. A. Huffman, "Impossible objects as nonsense sentences," Machine intelligence, vol. 6, pp. 295–323, 1971.
[8] B. D. Lucas and T. Kanade, "An iterative image registration technique with an application to stereo vision," in IJCAI'81: 7th international joint conference on Artificial intelligence, vol. 2, 1981, pp. 674–679.
[9] F. A. Gers and E. Schmidhuber, "Lstm recurrent networks learn simple context-free and context-sensitive languages," IEEE transactions on neural networks, vol. 12, no. 6, pp. 1333–1340, 2001.
[10] P. Schneider and G. Schneider, "De novo design at the edge of chaos: Miniperspective," Journal of medicinal chemistry, vol. 59, no. 9, pp. 4077–4086, 2016.
[11] M. Fadaee, A. Bisazza, and C. Monz, "Data augmentation for low-resource neural machine translation," arXiv preprint arXiv:1705.00440, 2017.
[12] J.-P. Tarel, N. Hautiere, A. Cord, D. Gruyer, and H. Halmaoui, "Improved visibility of road scene images under heterogeneous fog," in 2010 IEEE intelligent vehicles symposium. IEEE, 2010, pp. 478–485.
[13] J.-P. Tarel, N. Hautiere, L. Caraffa, A. Cord, H. Halmaoui, and D. Gruyer, "Vision enhancement in homogeneous and heterogeneous fog," IEEE Intelligent Transportation Systems Magazine, vol. 4, no. 2, pp. 6–20, 2012.
[14] D. J. Butler, J. Wulff, G. B. Stanley, and M. J. Black, "A naturalistic open source movie for optical flow evaluation," in Computer Vision–ECCV 2012: 12th European Conference on Computer Vision, Florence, Italy, October 7-13, 2012, Proceedings, Part VI 12. Springer, 2012, pp. 611–625.
[15] "Creative commons attribution 3.0 license," https://creativecommons.org/licenses/by/3.0/legalcode.
[16] N. Mayer, E. Ilg, P. Hausser, P. Fischer, D. Cremers, A. Dosovitskiy, and T. Brox, "A large dataset to train convolutional networks for disparity, optical flow, and scene flow estimation," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2016, pp. 4040–4048.
[17] M. Savva, A. X. Chang, and P. Hanrahan, "Semantically-enriched 3d models for common-sense knowledge," in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition Workshops, 2015, pp. 24–31.
[18] S. R. Richter, V. Vineet, S. Roth, and V. Koltun, "Playing for data: Ground truth from computer games," in Computer Vision–ECCV 2016: 14th European Conference, Amsterdam, The Netherlands, October 11-14, 2016, Proceedings, Part II 14. Springer, 2016, pp. 102–118.
[19] A. Gaidon, Q. Wang, Y. Cabon, and E. Vig, "Virtual worlds as proxy for multi-object tracking analysis," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2016, pp. 4340–4349.
[20] P. Isola, J.-Y. Zhu, T. Zhou, and A. A. Efros, "Image-to-image translation with conditional adversarial networks," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2017, pp. 5967–5976.
[21] T.-C. Wang, M.-Y. Liu, J.-Y. Zhu, A. Tao, J. Kautz, and B. Catanzaro, "High-resolution image synthesis and semantic manipulation with conditional gans," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2018, pp. 8798–8807.
[22] Q. Chen and V. Koltun, "Photographic image synthesis with cascaded refinement networks," in Proceedings of the IEEE international conference on computer vision, 2017, pp. 1520–1529.
[23] X. Qi, Q. Chen, J. Jia, and V. Koltun, "Semi-parametric image synthesis," in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2018, pp. 8808–8816.
[24] T. Park, M.-Y. Liu, T.-C. Wang, and J.-Y. Zhu, "Semantic image synthesis with spatially-adaptive normalization," in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2019, pp. 2337–2346.
[25] H. Tang, D. Xu, N. Sebe, Y. Wang, J. J. Corso, and Y. Yan, "Multi-channel attention selection gan with cascaded semantic guidance for cross-view image translation," in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2019, pp. 2412–2421.
[26] L. Jiang, C. Zhang, M. Huang, C. Liu, J. Shi, and C. C. Loy, "Tsit: A simple and versatile framework for image-to-image translation," in Computer Vision–ECCV 2020: 16th European Conference, Glasgow, UK, August 23–28, 2020, Proceedings, Part III 16. Springer, 2020, pp. 206–222.
[27] A. Dundar, K. Sapra, G. Liu, A. Tao, and B. Catanzaro, "Panoptic-based image synthesis," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2020, pp. 8067–8076.
[28] H. Tang, S. Bai, and N. Sebe, "Dual attention gans for semantic image synthesis," in Proceedings of the 28th ACM International Conference on Multimedia, 2020, pp. 1994–2002.
[29] Z. Zhu, Z. Xu, A. You, and X. Bai, "Semantically multi-modal image synthesis," in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2020, pp. 5466–5475.
[30] C.-H. Lee, Z. Liu, L. Wu, and P. Luo, "Maskgan: Towards diverse and interactive facial image manipulation," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, pp. 5548–5557.
[31] P. Zhu, R. Abdal, Y. Qin, and P. Wonka, "Sean: Image synthesis with semantic region-adaptive normalization," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, pp. 5103–5112.
[32] V. Veeravasarapu, C. Rothkopf, and R. Visvanathan, "Adversarially tuned scene generation," in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2017, pp. 2587–2595.
[33] X. Li, H. Duan, B. Liu, X. Wang, and F.-Y. Wang, "A novel framework to generate synthetic video for foreground detection in highway surveillance scenarios," IEEE Transactions on Intelligent Transportation Systems, 2023.
[34] A. Dosovitskiy, G. Ros, F. Codevilla, A. Lopez, and V. Koltun, "Carla: An open urban driving simulator," in Proceedings of the 1st Annual Conference on Robot Learning. PMLR, 2017, pp. 1–16.
[35] Y. Tian, X. Li, H. Zhang, C. Zhao, B. Li, X. Wang, and F.-Y. Wang, "Vistagpt: Generative parallel transformers for vehicles with intelligent systems for transport automation," IEEE Transactions on Intelligent Vehicles, 2023.
[36] J. Kim, J. Ju, R. Feldt, and S. Yoo, "Reducing dnn labelling cost using surprise adequacy: An industrial case study for autonomous driving," in Proceedings of the 28th ACM Joint Meeting on European Software Engineering Conference and Symposium on the Foundations of Software Engineering, 2020, pp. 1466–1476.
[37] R. Song, X. Li, X. Zhao, M. Liu, J. Zhou, and F.-Y. Wang, "Identifying critical test scenarios for lane keeping assistance system using analytic hierarchy process and hierarchical clustering," IEEE Transactions on Intelligent Vehicles, 2023.
[38] L. Guo, C. Shan, T. Shi, X. Li, and F.-Y. Wang, "A vectorized representation model for trajectory prediction of intelligent vehicles in challenging scenarios," IEEE Transactions on Intelligent Vehicles, 2023.
[39] G. Ros, L. Sellart, J. Materzynska, D. Vazquez, and A. M. Lopez, "The synthia dataset: A large collection of synthetic images for semantic segmentation of urban scenes," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2016, pp. 3234–3243.
[40] F. S. Saleh, M. S. Aliakbarian, M. Salzmann, L. Petersson, and J. M. Alvarez, "Effective use of synthetic data for urban scene semantic segmentation," in Proceedings of the European Conference on Computer Vision (ECCV), 2018, pp. 84–100.
[41] C. Sakaridis, D. Dai, and L. Van Gool, "Semantic foggy scene understanding with synthetic data," International Journal of Computer Vision, vol. 126, pp. 973–992, 2018.
[42] E. Alberti, A. Tavera, C. Masone, and B. Caputo, "Idda: A large-scale multi-domain dataset for autonomous driving," IEEE Robotics and Automation Letters, vol. 5, no. 4, pp. 5526–5533, 2020.
[43] A. Kloukiniotis, A. Papandreou, C. Anagnostopoulos, A. Lalos, P. Kapsalas, D.-V. Nguyen, and K. Moustakas, "Carlascenes: A synthetic dataset for odometry in autonomous driving," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, pp. 4519–4527.
[44] S. C. Agrawal and A. S. Jalal, "A comprehensive review on analysis and implementation of recent image dehazing methods," Archives of Computational Methods in Engineering, vol. 29, no. 7, pp. 4799–4850, 2022.
[45] F. Guo, J. Yang, Z. Liu, and J. Tang, "Haze removal for single image: A comprehensive review," Neurocomputing, 2023.
[46] S. Shen, L. Kerofsky, and S. Yogamani, "Optical flow for autonomous driving: Applications, challenges and improvements," arXiv preprint arXiv:2301.04422, 2023.
[47] D. Kondermann, R. Nair, K. Honauer, K. Krispin, J. Andrulis, A. Brock, B. Gussefeld, M. Rahimimoghaddam, S. Hofmann, C. Brenner et al., "The hci benchmark suite: Stereo and flow ground truth with uncertainties for urban autonomous driving," in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition Workshops, 2016, pp. 19–28.
[48] J. Wulff, D. J. Butler, G. B. Stanley, and M. J. Black, "Lessons and insights from creating a synthetic optical flow benchmark," in Computer Vision–ECCV 2012. Workshops and Demonstrations: Florence, Italy, October 7-13, 2012, Proceedings, Part II 12. Springer, 2012, pp. 168–177.
[49] D. Sun, X. Yang, M.-Y. Liu, and J. Kautz, "Pwc-net: Cnns for optical flow using pyramid, warping, and cost volume," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2018, pp. 8934–8943.
[50] P. Liu, M. Lyu, I. King, and J. Xu, "Selflow: Self-supervised learning of optical flow," in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2019, pp. 4571–4580.
[51] A. Bar-Haim and L. Wolf, "Scopeflow: Dynamic scene scoping for optical flow," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2020, pp. 7998–8007.
[52] L. Hoyer, D. Dai, H. Wang, and L. Van Gool, "Mic: Masked image consistency for context-enhanced domain adaptation," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2023, pp. 11 721–11 732.
[53] L. Hoyer, D. Dai, and L. Van Gool, "Hrda: Context-aware high-resolution domain-adaptive semantic segmentation," in European Conference on Computer Vision. Springer, 2022, pp. 372–391.
[54] B. Xie, S. Li, M. Li, C. H. Liu, G. Huang, and G. Wang, "Sepico: Semantic-guided pixel contrast for domain adaptive semantic segmentation," IEEE Transactions on Pattern Analysis and Machine Intelligence, 2023.
[55] D. Hernandez-Juarez, L. Schneider, A. Espinosa, D. Vázquez, A. M. López, U. Franke, M. Pollefeys, and J. C. M. Lopez, "Slanted stixels: Representing san francisco's steepest streets," in British Machine Vision Conference 2017, BMVC 2017, vol. 87, 2017.
[56] J. Zolfaghari Bengar, A. Gonzalez-Garcia, G. Villalonga, B. Raducanu, H. Habibi Aghdam, M. Mozerov, A. M. Lopez, and J. Van de Weijer, "Temporal coherence for active learning in videos," in Proceedings of the IEEE/CVF International Conference on Computer Vision Workshops, 2019, pp. 0–0.
[57] M. Cordts, M. Omran, S. Ramos, T. Rehfeld, M. Enzweiler, R. Benenson, U. Franke, S. Roth, and B. Schiele, "The cityscapes dataset for semantic urban scene understanding," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2016, pp. 3213–3223.
[58] G. Mandal, P. De, and D. Bhattacharya, "A real-time fast defogging system to clear the vision of driver in foggy highway using minimum filter and gamma correction," Sādhanā, vol. 45, pp. 1–11, 2020.
[59] N. Gadipudi, I. Elamvazuthi, M. Sanmugam, L. I. Izhar, T. Prasetyo, R. Jegadeeshwaran, and S. S. A. Ali, "Synthetic to real gap estimation of autonomous driving datasets using feature embedding," in 2022 IEEE 5th International Symposium in Robotics and Manufacturing Automation (ROMA). IEEE, 2022, pp. 1–5.
[60] J. Engel, V. Koltun, and D. Cremers, "Direct sparse odometry," IEEE transactions on pattern analysis and machine intelligence, vol. 40, no. 3, pp. 611–625, 2017.
[61] T. Shan and B. Englot, "Lego-loam: Lightweight and ground-optimized lidar odometry and mapping on variable terrain," in 2018 IEEE/RSJ International Conference on Intelligent Robots and Systems (IROS). IEEE, 2018, pp. 4758–4765.
[62] N. Yang, R. Wang, S. Stuckler, and D. Cremers, "Deep virtual stereo odometry: Leveraging deep depth prediction for monocular direct sparse odometry," in Proceedings of the European conference on computer vision (ECCV), 2018, pp. 817–833.
[63] S. R. Richter, Z. Hayder, and V. Koltun, "Playing for benchmarks," in Proceedings of the IEEE International Conference on Computer Vision, 2017, pp. 2232–2241.
[64] B. Hurl, K. Czarnecki, and S. Waslander, "Precise synthetic image and lidar (presil) dataset for autonomous vehicle perception," in 2019 IEEE Intelligent Vehicles Symposium (IV). IEEE, 2019, pp. 2522–2529.
[65] X. Li, K. Wang, Y. Tian, L. Yan, F. Deng, and F.-Y. Wang, "The paralleleye dataset: A large collection of virtual images for traffic vision research," IEEE Transactions on Intelligent Transportation Systems, vol. 20, no. 6, pp. 2072–2084, 2018.
[66] Y. Cabon, N. Murray, and M. Humenberger, "Virtual kitti 2," arXiv preprint arXiv:2001.10773, 2020.
[67] T. Sun, M. Segu, J. Postels, Y. Wang, L. Van Gool, B. Schiele, F. Tombari, and F. Yu, "Shift: a synthetic driving dataset for continuous multi-task domain adaptation," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, pp. 21 339–21 350.
[68] Y. Li, D. Ma, Z. An, Z. Wang, Y. Zhong, S. Chen, and C. Feng, "V2x-sim: Multi-agent collaborative perception dataset and benchmark for autonomous driving," IEEE Robotics and Automation Letters, vol. 7, no. 4, pp. 10 914–10 921, 2022.
[69] X. Weng, Y. Man, D. Cheng, J. Park, M. O'Toole, K. Kitani, J. Wang, and D. Held, "All-in-one drive: A large-scale comprehensive perception dataset with high-density long-range point clouds," arXiv, 2020.
[70] R. Xu, H. Xiang, X. Xia, X. Han, J. Li, and J. Ma, "Opv2v: An open benchmark dataset and fusion pipeline for perception with vehicle-to-vehicle communication," in 2022 International Conference on Robotics and Automation (ICRA). IEEE, 2022, pp. 2583–2589.
[71] H. Zhang, G. Luo, Y. Tian, K. Wang, H. He, and F.-Y. Wang, "A virtual-real interaction approach to object instance segmentation in traffic scenes," IEEE Transactions on Intelligent Transportation Systems, vol. 22, no. 2, pp. 863–875, 2020.
[72] Y. Chen, W. Li, X. Chen, and L. V. Gool, "Learning semantic segmentation from synthetic data: A geometrically guided input-output adaptation approach," in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2019, pp. 1841–1850.
[73] P. Su, K. Wang, X. Zeng, S. Tang, D. Chen, D. Qiu, and X. Wang, "Adapting object detectors with conditional domain normalization," in Computer Vision–ECCV 2020: 16th European Conference, Glasgow, UK, August 23–28, 2020, Proceedings, Part XI 16. Springer, 2020, pp. 403–419.
[74] M. Wrenninge and J. Unger, "Synscapes: A photorealistic synthetic dataset for street scene parsing," arXiv preprint arXiv:1810.08705, 2018.
[75] M. Johnson-Roberson, C. Barto, R. Mehta, S. N. Sridhar, K. Rosaen, and R. Vasudevan, "Driving in the matrix: Can virtual worlds replace human-generated annotations for real world tasks?" arXiv preprint arXiv:1610.01983, 2016.
[76] X. Li, K. Wang, X. Gu, F. Deng, and F.-Y. Wang, "Paralleleye pipeline: An effective method to synthesize images for improving the visual intelligence of intelligent vehicles," IEEE Transactions on Systems, Man, and Cybernetics: Systems, 2023.
[77] X. Li, Y. Wang, L. Yan, K. Wang, F. Deng, and F.-Y. Wang, "Paralleleye-cs: A new dataset of synthetic images for testing the visual intelligence of intelligent vehicles," IEEE Transactions on Vehicular Technology, vol. 68, no. 10, pp. 9619–9631, 2019.
[78] S. Ancha, Y. Raaj, P. Hu, S. G. Narasimhan, and D. Held, "Active perception using light curtains for autonomous driving," in Computer Vision–ECCV 2020: 16th European Conference, Glasgow, UK, August 23–28, 2020, Proceedings, Part V 16. Springer, 2020, pp. 751–766.
[79] C. Qu, T. Nguyen, and C. Taylor, "Depth completion via deep basis fitting," in Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision, 2020, pp. 71–80.
[80] J. Lagos and E. Rahtu, "Pandepth: Joint panoptic segmentation and depth completion," arXiv preprint arXiv:2212.14180, 2022.
[81] M. Jaritz, T.-H. Vu, R. De Charette, É. Wirbel, and P. Pérez, "Crossmodal learning for domain adaptation in 3d semantic segmentation," IEEE Transactions on Pattern Analysis and Machine Intelligence, vol. 45, no. 2, pp. 1533–1544, 2022.
[82] Z. Lei, S. Ren, Y. Hu, W. Zhang, and S. Chen, "Latency-aware collaborative perception," in Computer Vision–ECCV 2022: 17th European Conference, Tel Aviv, Israel, October 23–27, 2022, Proceedings, Part XXXII. Springer, 2022, pp. 316–332.
[83] Y. Lu, Q. Li, B. Liu, M. Dianati, C. Feng, S. Chen, and Y. Wang, "Robust collaborative 3d object detection in presence of pose errors," in 2023 IEEE International Conference on Robotics and Automation (ICRA). IEEE, 2023, pp. 4812–4818.
[84] Y. Hu, S. Fang, Z. Lei, Y. Zhong, and S. Chen, "Where2comm: Communication-efficient collaborative perception via spatial confidence maps," Advances in neural information processing systems, vol. 35, pp. 4874–4886, 2022.
[85] H. Yu, Y. Luo, M. Shu, Y. Huo, Z. Yang, Y. Shi, Z. Guo, H. Li, X. Hu, J. Yuan et al., "Dair-v2x: A large-scale dataset for vehicle-infrastructure cooperative 3d object detection," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, pp. 21 361–21 370.
[86] R. Geirhos, J.-H. Jacobsen, C. Michaelis, R. Zemel, W. Brendel, M. Bethge, and F. A. Wichmann, "Shortcut learning in deep neural networks," Nature Machine Intelligence, vol. 2, no. 11, pp. 665–673, 2020.
[87] A. Jain, L. Del Pero, H. Grimmett, and P. Ondruska, "Autonomy 2.0: Why is self-driving always 5 years away?" arXiv preprint arXiv:2107.08142, 2021.
[88] O. Makansi, Ö. Cicek, Y. Marrakchi, and T. Brox, "On exposing the challenging long tail in future prediction of traffic actors," in Proceedings of the IEEE/CVF International Conference on Computer Vision, 2021, pp. 13 147–13 157.
[89] W. Liang, G. A. Tadesse, D. Ho, L. Fei-Fei, M. Zaharia, C. Zhang, and J. Zou, "Advances, challenges and opportunities in creating data for trustworthy ai," Nature Machine Intelligence, vol. 4, no. 8, pp. 669–677, 2022.
[90] C. Northcutt, L. Jiang, and I. Chuang, "Confident learning: Estimating uncertainty in dataset labels," Journal of Artificial Intelligence Research, vol. 70, pp. 1373–1411, 2021.
[91] C. G. Northcutt, A. Athalye, and J. Mueller, "Pervasive label errors in test sets destabilize machine learning benchmarks," arXiv preprint arXiv:2103.14749, 2021.
[92] D. A. Van Dyk and X.-L. Meng, "The art of data augmentation," Journal of Computational and Graphical Statistics, vol. 10, no. 1, pp. 1–50, 2001.
[93] A. Antoniou, A. Storkey, and H. Edwards, "Data augmentation generative adversarial networks," arXiv preprint arXiv:1711.04340, 2017.
[94] W. Liang and J. Zou, "Neural group testing to accelerate deep learning," in 2021 IEEE International Symposium on Information Theory (ISIT). IEEE, 2021, pp. 958–963.
[95] G. Ros, S. Stent, P. F. Alcantarilla, and T. Watanabe, "Training constrained deconvolutional networks for road scene semantic segmentation," arXiv preprint arXiv:1604.01545, 2016.
[96] M. Wang and W. Deng, "Deep visual domain adaptation: A survey," Neurocomputing, vol. 312, pp. 135–153, 2018.
[97] D. Li, Y. Yang, Y.-Z. Song, and T. M. Hospedales, "Deeper, broader and artier domain generalization," in Proceedings of the IEEE international conference on computer vision, 2017, pp. 5543–5551.
[98] M. Segu, A. Tonioni, and F. Tombari, "Batch normalization embeddings for deep domain generalization," Pattern Recognit., vol. 135, p. 109115, 2020.
[99] R. Volpi, D. Larlus, and G. Rogez, "Continual adaptation of visual representations via domain randomization and meta-learning," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2021, pp. 4441–4451.
[100] D. Wang, E. Shelhamer, S. Liu, B. A. Olshausen, and T. Darrell, "Tent: Fully test-time adaptation by entropy minimization," in International Conference on Learning Representations, 2021.
[101] C. Guo, G. Pleiss, Y. Sun, and K. Q. Weinberger, "On calibration of modern neural networks," in International conference on machine learning. PMLR, 2017, pp. 1321–1330.
[102] Y. Gal and Z. Ghahramani, "Dropout as a bayesian approximation: Representing model uncertainty in deep learning," in international conference on machine learning. PMLR, 2016, pp. 1050–1059.
[103] B. Lakshminarayanan, A. Pritzel, and C. Blundell, "Simple and scalable predictive uncertainty estimation using deep ensembles," Advances in neural information processing systems, vol. 30, 2017.
[104] A. Prakash, S. Debnath, J.-F. Lafleche, E. Cameracci, S. Birchfield, M. T. Law et al., "Self-supervised real-to-sim scene generation," in Proceedings of the IEEE/CVF International Conference on Computer Vision, 2021, pp. 16 044–16 054.
[105] V. Prabhu, D. Acuna, A. Liao, R. Mahmood, M. T. Law, J. Hoffman, S. Fidler, and J. Lucas, "Bridging the sim2real gap with care: Supervised detection adaptation with conditional alignment and reweighting," arXiv preprint arXiv:2302.04832, 2023.
[106] J. Tobin, R. Fong, A. Ray, J. Schneider, W. Zaremba, and P. Abbeel, "Domain randomization for transferring deep neural networks from simulation to the real world," in 2017 IEEE/RSJ international conference on intelligent robots and systems (IROS). IEEE, 2017, pp. 23–30.
[107] J. Tremblay, A. Prakash, D. Acuna, M. Brophy, V. Jampani, C. Anil, T. To, E. Cameracci, S. Boochoon, and S. Birchfield, "Training deep networks with synthetic data: Bridging the reality gap by domain randomization," in Proceedings of the IEEE conference on computer vision and pattern recognition workshops, 2018, pp. 969–977.
[108] A. Prakash, S. Boochoon, M. Brophy, D. Acuna, E. Cameracci, G. State, O. Shapira, and S. Birchfield, "Structured domain randomization: Bridging the reality gap by context-aware synthetic data," in 2019 International Conference on Robotics and Automation (ICRA). IEEE, 2019, pp. 7249–7255.
[109] X. Huang, M.-Y. Liu, S. Belongie, and J. Kautz, "Multimodal unsupervised image-to-image translation," in Proceedings of the European conference on computer vision (ECCV), 2018, pp. 172–189.
[110] J. Hoffman, E. Tzeng, T. Park, J.-Y. Zhu, P. Isola, K. Saenko, A. Efros, and T. Darrell, "Cycada: Cycle-consistent adversarial domain adaptation," in International conference on machine learning. Pmlr, 2018, pp. 1989–1998.
[111] Y.-C. Chen, Y.-Y. Lin, M.-H. Yang, and J.-B. Huang, "Crdoco: Pixel-level domain transfer with cross-domain consistency," in Proceedings of the IEEE/CVF conference on computer vision and pattern recognition, 2019, pp. 1791–1800.
[112] Y.-H. Tsai, W.-C. Hung, S. Schulter, K. Sohn, M.-H. Yang, and M. Chandraker, "Learning to adapt structured output space for semantic segmentation," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2018, pp. 7472–7481.
[113] K. Saito, Y. Ushiku, T. Harada, and S. Saenko, "Strong-weak distribution alignment for adaptive object detection," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, pp. 6956–6965.
[114] X. Zhu, J. Pang, C. Yang, J. Shi, and D. Lin, "Adapting object detectors via selective cross-domain alignment," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, pp. 687–696.
[115] H.-K. Hsu, C.-H. Yao, Y.-H. Tsai, W.-C. Hung, H.-Y. Tseng, M. Singh, and M.-H. Yang, "Progressive domain adaptation for object detection," in Proceedings of the IEEE/CVF winter conference on applications of computer vision, 2020, pp. 749–757.
[116] F. Yu, D. Wang, Y. Chen, N. Karianakis, T. Shen, P. Yu, D. Lymberopoulos, S. Lu, W. Shi, and X. Chen, "Sc-uda: Style and content gaps aware unsupervised domain adaptation for object detection," in Proceedings of the IEEE/CVF Winter Conference on Applications of Computer Vision, 2022, pp. 382–391.
[117] S. Tan, X. Peng, and K. Saenko, "Class-imbalanced domain adaptation: an empirical odyssey," in Computer Vision–ECCV 2020 Workshops: Glasgow, UK, August 23–28, 2020, Proceedings, Part I 16. Springer, 2020, pp. 585–602.
[118] Y. Li, L. Yuan, and N. Vasconcelos, "Bidirectional learning for domain adaptation of semantic segmentation," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, pp. 6936–6945.
[119] A. Kar, A. Prakash, M.-Y. Liu, E. Cameracci, J. Yuan, M. Rusiniak, D. Acuna, A. Torralba, and S. Fidler, "Meta-sim: Learning to generate synthetic datasets," in Proceedings of the IEEE/CVF International Conference on Computer Vision, 2019, pp. 4551–4560.
[120] J. Devaranjan, A. Kar, and S. Fidler, "Meta-sim2: Unsupervised learning of scene structure for synthetic data generation," in Computer Vision–ECCV 2020: 16th European Conference, Glasgow, UK, August 23–28, 2020, Proceedings, Part XVII 16. Springer, 2020, pp. 715–733.
[121] S. Tan, K. Wong, S. Wang, S. Manivasagam, M. Ren, and R. Urtasun, "Scenegen: Learning to generate realistic traffic scenes," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2021, pp. 892–901.
[122] B. Mildenhall, P. P. Srinivasan, M. Tancik, J. T. Barron, R. Ramamoorthi, and R. Ng, "Nerf: Representing scenes as neural radiance fields for view synthesis," Communications of the ACM, vol. 65, no. 1, pp. 99–106, 2021.
[123] K. Zhang, G. Riegler, N. Snavely, and V. Koltun, "Nerf++: Analyzing and improving neural radiance fields," arXiv preprint arXiv:2010.07492, 2020.
[124] T. Müller, A. Evans, C. Schied, and A. Keller, "Instant neural graphics primitives with a multiresolution hash encoding," ACM Transactions on Graphics (ToG), vol. 41, no. 4, pp. 1–15, 2022.
[125] M. Tancik, V. Casser, X. Yan, S. Pradhan, B. Mildenhall, P. P. Srinivasan, J. T. Barron, and H. Kretzschmar, "Block-nerf: Scalable large scene neural view synthesis," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, pp. 8248–8258.
[126] A. Chen, Z. Xu, F. Zhao, X. Zhang, F. Xiang, J. Yu, and H. Su, "Mvsnerf: Fast generalizable radiance field reconstruction from multi-view stereo," in Proceedings of the IEEE/CVF International Conference on Computer Vision, 2021, pp. 14 124–14 133.
[127] S. Song, F. Yu, A. Zeng, A. X. Chang, M. Savva, and T. Funkhouser, "Semantic scene completion from a single depth image," in Proceedings of the IEEE conference on computer vision and pattern recognition, 2017, pp. 1746–1754.
[128] J. Li, Y. Liu, D. Gong, Q. Shi, X. Yuan, C. Zhao, and I. Reid, "Rgbd based dimensional decomposition residual network for 3d semantic scene completion," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2019, pp. 7693–7702.
[129] J. Li, Y. Liu, X. Yuan, C. Zhao, R. Siegwart, I. Reid, and C. Cadena, "Depth based semantic scene completion with position importance aware loss," IEEE Robotics and Automation Letters, vol. 5, no. 1, pp. 219–226, 2019.
[130] J. Li, K. Han, P. Wang, Y. Liu, and X. Yuan, "Anisotropic convolutional networks for 3d semantic scene completion," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2020, pp. 3351–3359.
[131] R. Cheng, C. Agia, Y. Ren, X. Li, and L. Bingbing, "S3cnet: A sparse semantic scene completion network for lidar point clouds," in Conference on Robot Learning. PMLR, 2021, pp. 2148–2161.
[132] M. Firman, O. Mac Aodha, S. Julier, and G. J. Brostow, "Structured prediction of unobserved voxels from a single depth image," in Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 2016, pp. 5431–5440.
[133] M. Xu, P. Chen, H. Liu, and X. Han, "To-scene: A large-scale dataset for understanding 3d tabletop scenes," in Computer Vision–ECCV 2022: 17th European Conference, Tel Aviv, Israel, October 23–27, 2022, Proceedings, Part XXVII. Springer, 2022, pp. 340–356.
[134] A. X. Chang, T. Funkhouser, L. Guibas, P. Hanrahan, Q. Huang, Z. Li, S. Savarese, M. Savva, S. Song, H. Su et al., "Shapenet: An information-rich 3d model repository," arXiv preprint arXiv:1512.03012, 2015.
[135] B. Curless and M. Levoy, "A volumetric method for building complex models from range images," in Proceedings of the 23rd annual conference on Computer graphics and interactive techniques, 1996, pp. 303–312.
[136] M. Loper, N. Mahmood, J. Romero, G. Pons-Moll, and M. J. Black, "Smpl: A skinned multi-person linear model," ACM transactions on graphics (TOG), vol. 34, no. 6, pp. 1–16, 2015.
[137] S. Saito, Z. Huang, R. Natsume, S. Morishima, A. Kanazawa, and H. Li, "Pifu: Pixel-aligned implicit function for high-resolution clothed human digitization," in Proceedings of the IEEE/CVF international conference on computer vision, 2019, pp. 2304–2314.
[138] N. Science and T. C. U. S. C. on Artificial Intelligence, The national artificial intelligence research and development strategic plan: 2019 update. National Science and Technology Council (US), Select Committee on Artificial . . . , 2019.
[139] C. Xu, W. Ding, W. Lyu, Z. Liu, S. Wang, Y. He, H. Hu, D. Zhao, and B. Li, "Safebench: A benchmarking platform for safety evaluation of autonomous vehicles," Advances in Neural Information Processing Systems, vol. 35, pp. 25 667–25 682, 2022.
[140] A. Ghorbani and J. Zou, "Data shapley: Equitable valuation of data for machine learning," in International Conference on Machine Learning. PMLR, 2019, pp. 2242–2251.
[141] Y. Kwon, M. A. Rivas, and J. Zou, "Efficient computation and analysis of distributional shapley values," in International Conference on Artificial Intelligence and Statistics. PMLR, 2021, pp. 793–801.
[142] R. Jia, D. Dao, B. Wang, F. A. Hubis, N. Hynes, N. M. Gürel, B. Li, C. Zhang, D. Song, and C. J. Spanos, "Towards efficient data valuation based on the shapley value," in The 22nd International Conference on Artificial Intelligence and Statistics. PMLR, 2019, pp. 1167–1176.
[143] P. W. Koh and P. Liang, "Understanding black-box predictions via influence functions," in International conference on machine learning. PMLR, 2017, pp. 1885–1894.
[144] X. Li, P. Ye, J. Li, Z. Liu, L. Cao, and F.-Y. Wang, "From features engineering to scenarios engineering for trustworthy ai: I&i, c&c, and v&v," IEEE Intelligent Systems, vol. 37, no. 4, pp. 18–26, 2022.
[145] X. Li, Y. Tian, P. Ye, H. Duan, and F.-Y. Wang, "A novel scenarios engineering methodology for foundation models in metaverse," IEEE Transactions on Systems, Man, and Cybernetics: Systems, vol. 53, no. 4, pp. 2148–2159, 2022.
[146] California department of motor vehicle disengagement report. (2021). [Online]. Available: https://www.dmv.ca.gov/portal/vehicle-industry-services/autonomous-vehicles/disengagement-reports/
[147] D. Zhao, "Accelerated evaluation of automated vehicles." Ph.D. dissertation, 2016.
[148] M. O'Kelly, A. Sinha, H. Namkoong, R. Tedrake, and J. C. Duchi, "Scalable end-to-end autonomous vehicle testing via rare-event simulation," Advances in neural information processing systems, vol. 31, 2018.
[149] B. C. Wallace, K. Small, C. E. Brodley, and T. A. Trikalinos, "Class imbalance, redux," in 2011 IEEE 11th international conference on data mining. Ieee, 2011, pp. 754–763.
[150] M. Arief, Z. Huang, G. K. S. Kumar, Y. Bai, S. He, W. Ding, H. Lam, and D. Zhao, "Deep probabilistic accelerated evaluation: A robust certifiable rare-event simulation methodology for black-box safety-critical systems," in International Conference on Artificial Intelligence and Statistics. PMLR, 2021, pp. 595–603.
[151] A. K. Menon, S. Jayasumana, A. S. Rawat, H. Jain, A. Veit, and S. Kumar, "Long-tail learning via logit adjustment," arXiv preprint arXiv:2007.07314, 2020.
[152] B. Kim and J. Kim, "Adjusting decision boundary for class imbalanced learning," IEEE Access, vol. 8, pp. 81 674–81 685, 2020.
[153] J. Mao, M. Niu, C. Jiang, H. Liang, J. Chen, X. Liang, Y. Li, C. Ye, W. Zhang, Z. Li et al., "One million scenes for autonomous driving: Once dataset," arXiv preprint arXiv:2106.11037, 2021.
[154] B. Wilson, W. Qi, T. Agarwal, J. Lambert, J. Singh, S. Khandelwal, B. Pan, R. Kumar, A. Hartnett, J. K. Pontes et al., "Argoverse 2: Next generation datasets for self-driving perception and forecasting," arXiv preprint arXiv:2301.00493, 2023.
[155] W. Ding, B. Chen, B. Li, K. J. Eun, and D. Zhao, "Multimodal safety-critical scenarios generation for decision-making algorithms evaluation," IEEE Robotics and Automation Letters, vol. 6, no. 2, pp. 1551–1558, 2021.
[156] Q. Zhang, S. Hu, J. Sun, Q. A. Chen, and Z. M. Mao, "On adversarial robustness of trajectory prediction for autonomous vehicles," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2022, pp. 15 159–15 168.
[157] S. Feng, X. Yan, H. Sun, Y. Feng, and H. X. Liu, "Intelligent driving intelligence test for autonomous vehicles with naturalistic and adversarial environment," Nature communications, vol. 12, no. 1, p. 748, 2021.
[158] W. Ding, H. Lin, B. Li, K. J. Eun, and D. Zhao, "Semantically adversarial driving scenario generation with explicit knowledge integration," arXiv preprint arXiv:2106.04066, 2021.
[159] G. Bagschik, T. Menzel, and M. Maurer, "Ontology based scene creation for the development of automated vehicles," in 2018 IEEE Intelligent Vehicles Symposium (IV). IEEE, 2018, pp. 1813–1820.
[160] T. L. Saaty, L. G. Vargas et al., Decision making with the analytic network process. Springer, 2006, vol. 282.
[161] T. L. Saaty, L. G. Vargas, T. L. Saaty, and L. G. Vargas, The analytic network process. Springer, 2013.
[162] A. Hore and D. Ziou, "Image quality metrics: Psnr vs. ssim," in 2010 20th international conference on pattern recognition. IEEE, 2010, pp. 2366–2369.
[163] T. L. Saaty, What is the analytic hierarchy process? Springer, 1988.
[164] ——, "Decision making with the analytic hierarchy process," International journal of services sciences, vol. 1, no. 1, pp. 83–98, 2008.
[165] W. Adams and R. Saaty, "Super decisions software guide," Super Decisions, vol. 9, p. 43, 2003.
[166] K. Yu, T. Tao, H. Xie, Z. Lin, T. Liang, B. Wang, P. Chen, D. Hao, Y. Wang, and X. Liang, "Benchmarking the robustness of lidar-camera fusion for 3d object detection," in Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 2023, pp. 3187–3197.
本译稿服务的是我们自己的工程项目:舱内感知(DMS/OMS)算法的合成数据管线(Omniverse / Isaac Sim / Cosmos 系)。以下是译者面向这一项目的评估,不属于原文内容。