深度学习的最新进展与高质量真实世界驾驶数据集的可用性推动了端到端自动驾驶的发展。尽管如此,仅依赖真实世界数据会限制训练场景的多样性。合成场景生成已成为丰富训练数据多样性的一个有前景的方案;然而,它在端到端自动驾驶模型中的应用在很大程度上仍未被探索。这主要是因为合成场景中缺少指定的自车(ego vehicle)以及真实场景中通常提供的相机或 LiDAR 等传感器输入。为填补这一空白,我们提出 SynAD——首个利用合成数据增强真实世界端到端自动驾驶模型的框架。我们的方法在多智能体合成场景中指定驾驶信息最全面的智能体作为自车;进一步将路径级场景投影到地图上,并采用新开发的地图到BEV网络(Map-to-BEV Network)在不依赖传感器输入的情况下导出鸟瞰图特征;最后,我们设计了一种训练策略,将这些基于地图的合成数据与真实驾驶数据有效集成。实验结果表明,SynAD 有效集成了所有组件,并显著提升了安全性表现。通过打通合成场景生成与端到端自动驾驶,SynAD 为构建更全面、更鲁棒的自动驾驶模型铺平了道路。
随着深度学习与全面的真实世界驾驶数据集 [1] 带来显著进展,自动驾驶汽车正从研究实验室走向道路。近期研究利用这些数据集中的 LiDAR [16, 33] 或多相机图像 [11–13] 提取鸟瞰图(bird's-eye-view,BEV)特征 [3, 17, 22],服务于多种任务 [10, 18, 21, 35]。这些方法通过以端到端方式并行 [28] 或串行 [11, 12] 地纳入感知任务(跟踪与建图)、预测任务(运动预测与占用预测)以及规划任务,来提升端到端自动驾驶(E2E AD)模型的性能。为更好地刻画真实世界驾驶环境的复杂性,一些研究 [26, 36] 提出了引入 3D 占用(occupancy)理解的方法。
然而,仅依赖真实世界数据集存在一个根本性局限:数据采集与标注的高成本导致多样性不足,限制了可用于训练的场景范围。为缓解这一问题,一些研究 [8, 34] 在特定条件下生成路径,并利用 CARLA 仿真器 [6] 获取对应的相机数据用于额外训练。这些方法能够在极端情形下实现鲁棒驾驶,但仍存在局限——它们只能在虚拟环境中运行。与此同时,若干研究开发了不依赖仿真器、从真实世界数据集生成逼真驾驶场景的方法:这些工作采用基于逻辑 [38]、语言引导 [25, 37] 与基于检索 [5] 的方法,产出满足特定条件的高质量、多样化场景。
尽管这些方法具备很强的生成能力,合成场景尚未被有效集成到真实世界 E2E AD 模型训练中。一个关键局限是:当前的场景生成方法只产出路径级(path-level)输出,并忽略了自车的指定;它们也无法生成对应的传感器输入(如多相机图像与 LiDAR 数据),而这是建立真实场景中以自车为中心的视角所必需的。因此,这一缺失限制了它们融入真实世界 E2E AD 训练管线。
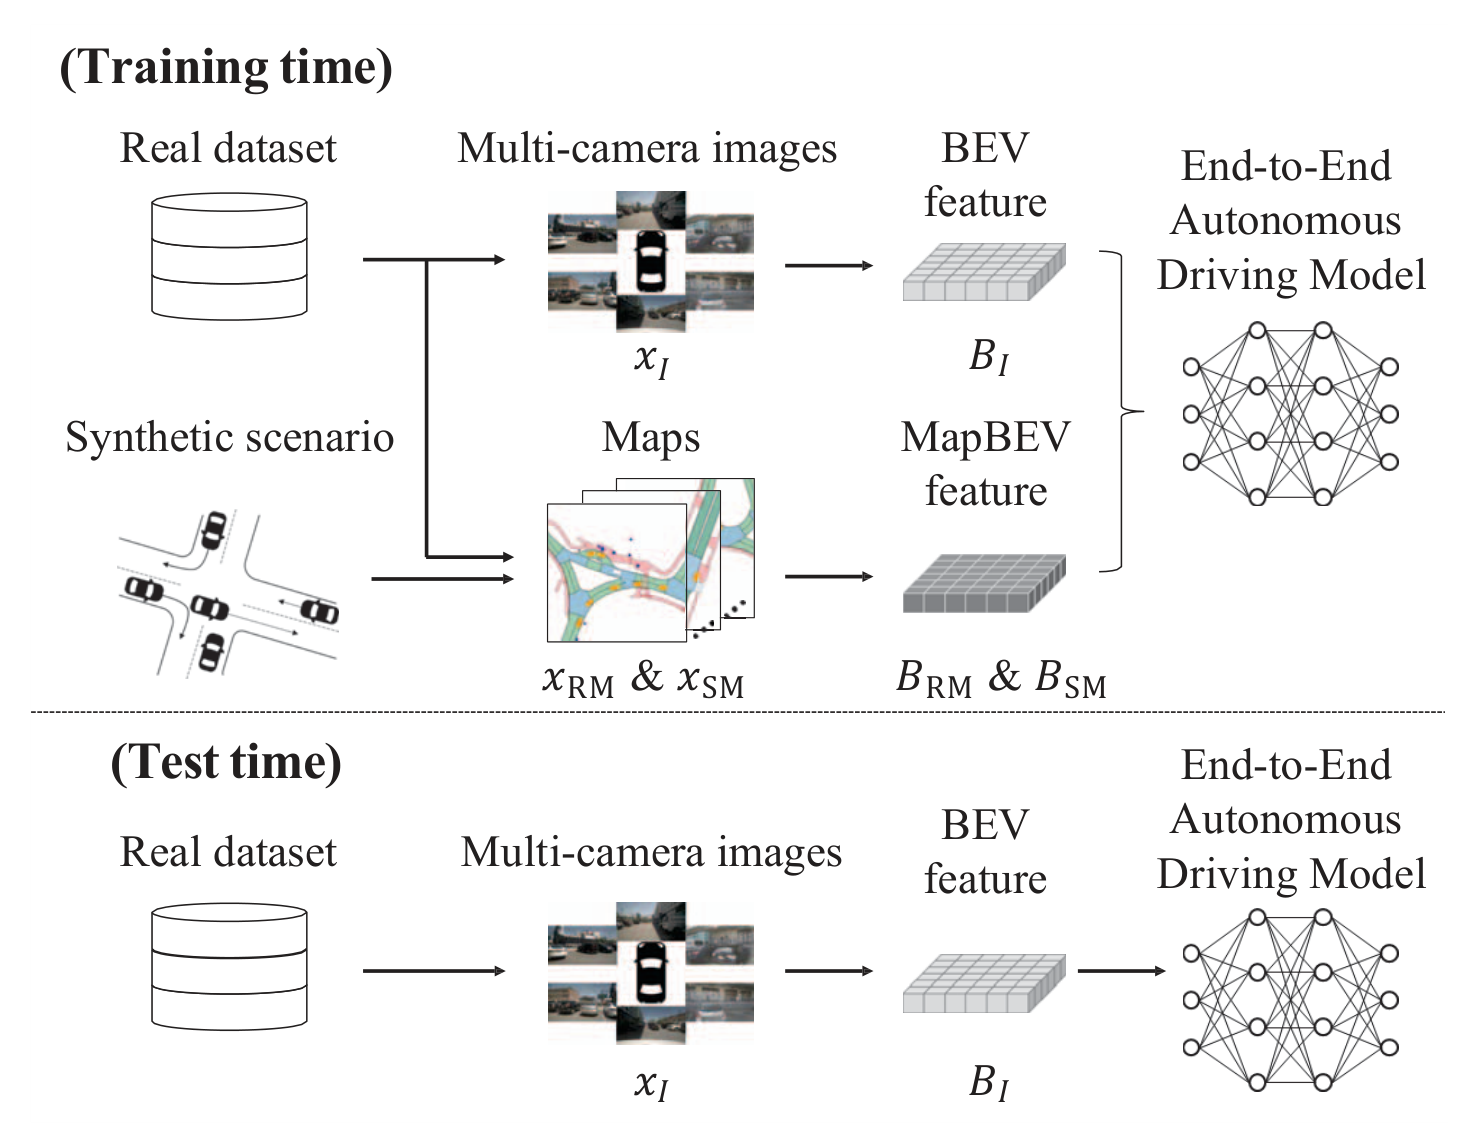
为应对这些挑战,我们提出 SynAD,一个通过集成合成数据来增强真实世界 E2E AD 模型的新框架。SynAD 包含三个关键组件:第一,我们提出一种专为 E2E AD 训练量身定制的以自车为中心的场景生成方法,在场景生成过程中设置有效的引导(guides),并指定驾驶信息最丰富的智能体作为自车;所选自车的路径被设为目标路径,作为 E2E AD 模型的额外训练数据。第二,我们提出地图到BEV网络(Map-to-BEV Network)把合成场景集成进 E2E AD 训练管线;该网络从包含合成场景车辆信息的地图中编码 BEV 特征,从而在不依赖传感器数据输入的情况下实现集成。第三,我们同样把真实场景投影到地图上,缩小基于地图的合成数据与真实驾驶数据之间的域差距,确保如图 1 所示的一致集成。此外,通过在最适合的阶段选择性地利用从每类地图中提取的特征,我们避免了集成地图数据带来的性能退化,并使模型在仅用图像输入的测试时仍取得高性能。大量消融实验验证了 SynAD 的每个组件都对合成场景在 E2E AD 训练中的应用有实效。主要贡献总结如下:
交通场景生成通过在仿真环境中实现安全且全面的验证,对测试和改进自动驾驶系统至关重要。近期研究 [4, 8, 24, 27, 30, 34] 聚焦于安全关键(safety-critical)场景——由于成本与安全约束,这类场景在真实驾驶中难以采集。KING [8] 使用运动学自行车模型(kinematic bicycle model)对安全关键目标求梯度,更新使自车更可能引发事故的路径;它还通过在生成的场景上微调,提升了 E2E AD 在基于仿真器的合成驾驶环境中的鲁棒性。在纯安全关键场景之外,可控场景生成研究 [14, 20, 23, 30, 37, 38] 也备受关注:这些工作引入扩散模型,允许用户指定轨迹属性(如到达目标点、遵守限速),同时保持物理可行性与自然行为。此外,一些研究 [19, 25, 29, 37] 利用大语言模型把用户查询转换为逼真交通场景。RealGen [5] 指出生成式方法的一个局限——往往难以产生新颖场景——并提出组合多个检索样本的行为来创造新场景。然而,把这些生成的场景用于改进真实世界 E2E AD 模型仍在很大程度上未被探索。
E2E AD,尤其是以视觉为中心(vision-centric)的路线,已成为近期研究热点。与把感知任务与规划分离的传统自动驾驶方法 [2, 7, 15, 32] 不同,以视觉为中心的 E2E 方法把这些组件集成进单一统一模型。这类方法在通过端到端优化改进各下游任务的同时,提供了可解释性与安全性收益。面向规划的模块化设计原则推动了近期多项进展:ST-P3 [11] 以端到端方式训练语义占用预测与规划;UniAD [12] 提出面向规划的统一框架,统一跟踪、在线建图、运动预测、占用预测与规划;Paradrive [28] 实现跨模块并行处理,把运行速度提升近三倍;VAD [13] 用全向量化数据替代稠密栅格化场景表示以提升效率;与此同时,OccNet [26] 与 OccWorld [36] 通过把场景分割为带语义标签的结构化单元来探索 3D 占用表示。尽管网络设计与框架实现各异,这些方法都依赖从多相机输入导出的 BEV 特征。
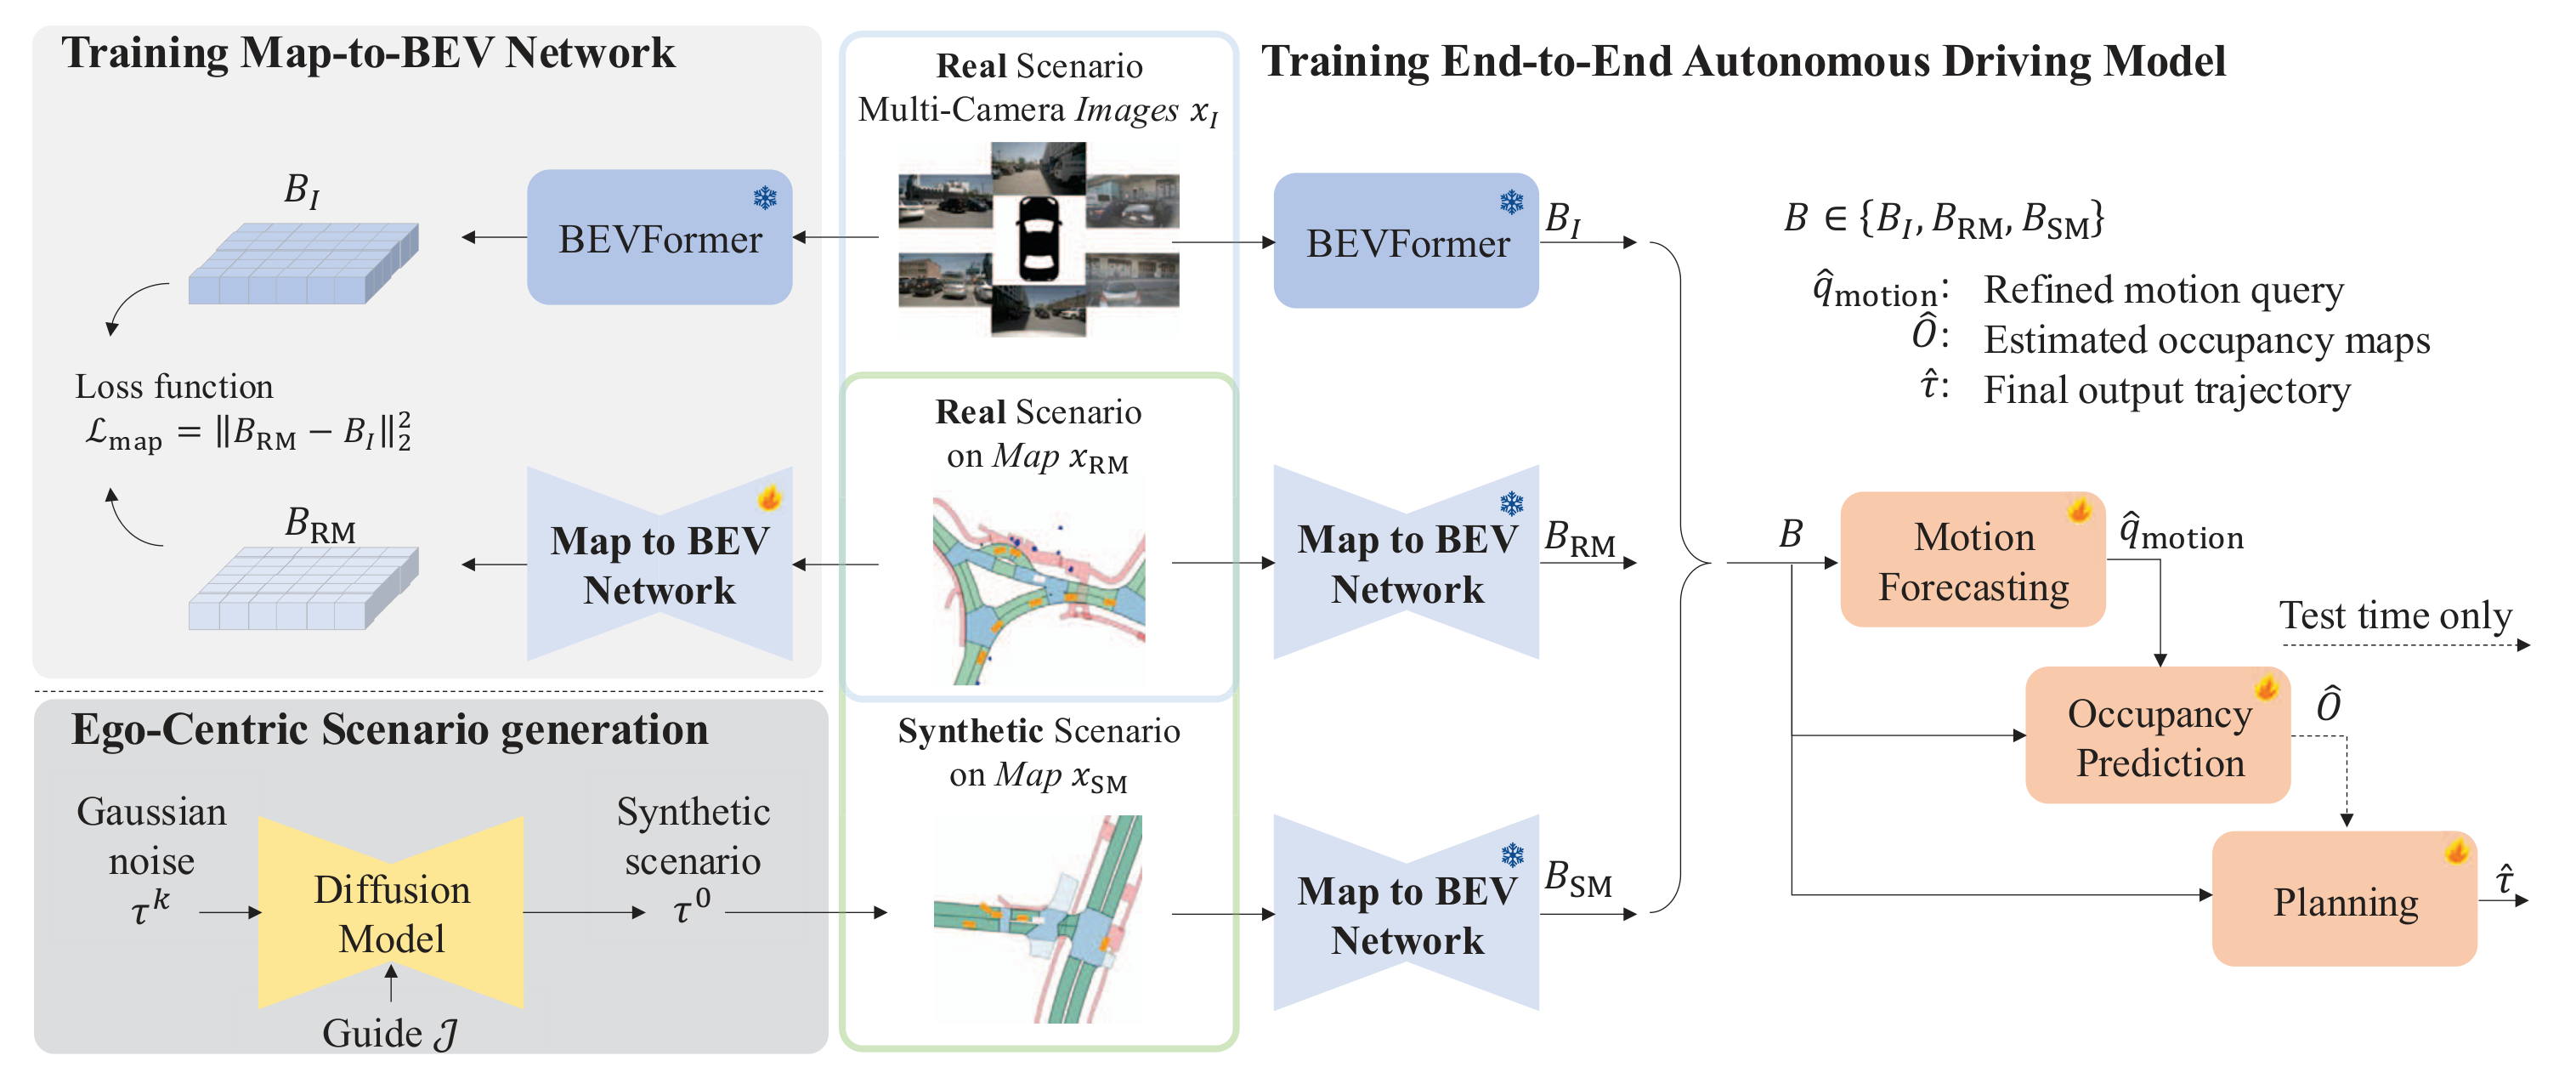
我们的方法旨在利用合成数据增强 E2E AD 模型。首先,生成满足特定条件的多智能体驾驶场景,并通过指定自车、以自车为中心裁剪地图,把它们转换为以自车为中心的场景;把这个合成的以自车为中心的地图表示记为 xSM,用于 E2E AD 训练。与此同时,用 xRM(把真实世界场景投影到对应地图表示而得)训练地图到BEV网络。该网络把从 xRM 提取的 BEV 特征与多相机图像 xI 对齐,使合成场景无需传感器输入即可使用。最后,我们提出把合成场景纳入 E2E AD 训练过程的训练策略。图 2 给出了方法总览。
真实感场景生成。 在自动驾驶系统中,车辆轨迹由每个时间步 t 的状态 s 表示。该状态向量包含四个元素:2D 坐标位置 (x, y)、速度 v 与航向角 θ,即 s = (x, y, v, θ)。为在以自车为中心的自动驾驶环境中生成满足预期条件的真实感场景,我们采用条件扩散模型生成轨迹 τ,其包含 M 个智能体在 T 个时间戳上的状态:
其中 sti 表示智能体 i 在时间 t 的状态,τ ∈ ℝT×M×4。扩散模型在前向过程中加入高斯噪声,再在逆向过程中将其重建。把 τk 定义为第 k 个扩散步的轨迹,前向过程定义为:
其中 βk 是控制每个扩散步加噪量的方差调度。注意 τ0 表示干净轨迹,τK 表示经 K 步扩散后被随机噪声污染的轨迹。
为把上下文信息融入逆向扩散过程,我们构造复合特征 f,聚合过去 h 个时间戳的图像特征。这些图像特征提取自只显示道路布局与环境背景、不含任何车辆描绘的地图。于是逆向扩散过程 pφ 可表示为:
其中 τK ∼ 𝒩(0, I) 从随机噪声出发,由 pφ 在 K 步内逐步去噪。
引导采样。 为在多样条件下生成真实感场景,我们在推理时采用引导采样(guided sampling)。定义引导项 𝒥 = Σi wiRi,即度量第 i 个目标规则满足度的函数 Ri 的加权和。本文采用三个具体目标:防止智能体间碰撞、防止与地图碰撞、遵守限速(详见补充材料 A.2)。然后按下式以该引导的梯度修改去噪过程:
通过修改逆向扩散过程,我们可以动态生成满足各目标的轨迹。
以自车为中心的场景。 为用扩散模型生成的多智能体场景训练自动驾驶模型,首先要在各智能体中确定自车。由于合成场景应包含全面的驾驶信息,我们建立自车选择规则:指定行驶距离最长的车辆为自车。据此,自车索引 e 由下式确定:
其中 d(·, ·) 表示状态间位置的距离。随后以自车为中心裁剪固定大小区域,构成时间戳 t 的输入地图 xtSM。
训练规划模块需要自车的未来轨迹与其他车辆的边界框,以保证无碰撞预测。由于生成的轨迹处于绝对坐标系,我们把它们变换到所选自车的相对坐标系,与真实数据对齐。该变换使自车行驶方向对齐 y 轴正方向,并把其中心设为原点。要把绝对坐标系中的任意位置 (x, y) 相对于自车状态 s 变换,定义变换函数为:
该旋转矩阵这一特定形式的推导见补充材料 A.3。要在时间 t 的以自车为中心坐标系中获得未来 Tp 个时间戳上的目标路径,我们对自车位置施加变换 T(·; ste),并把航向角相对自车在时间 t 的朝向作变换:
其中 [Tp] 表示 1 到 Tp 的整数集合。处理边界框信息时,先得到每辆车 i 在时间 t+t′ 的边界框坐标 bt+t′i,再对其他车辆与时间戳施加变换,得:
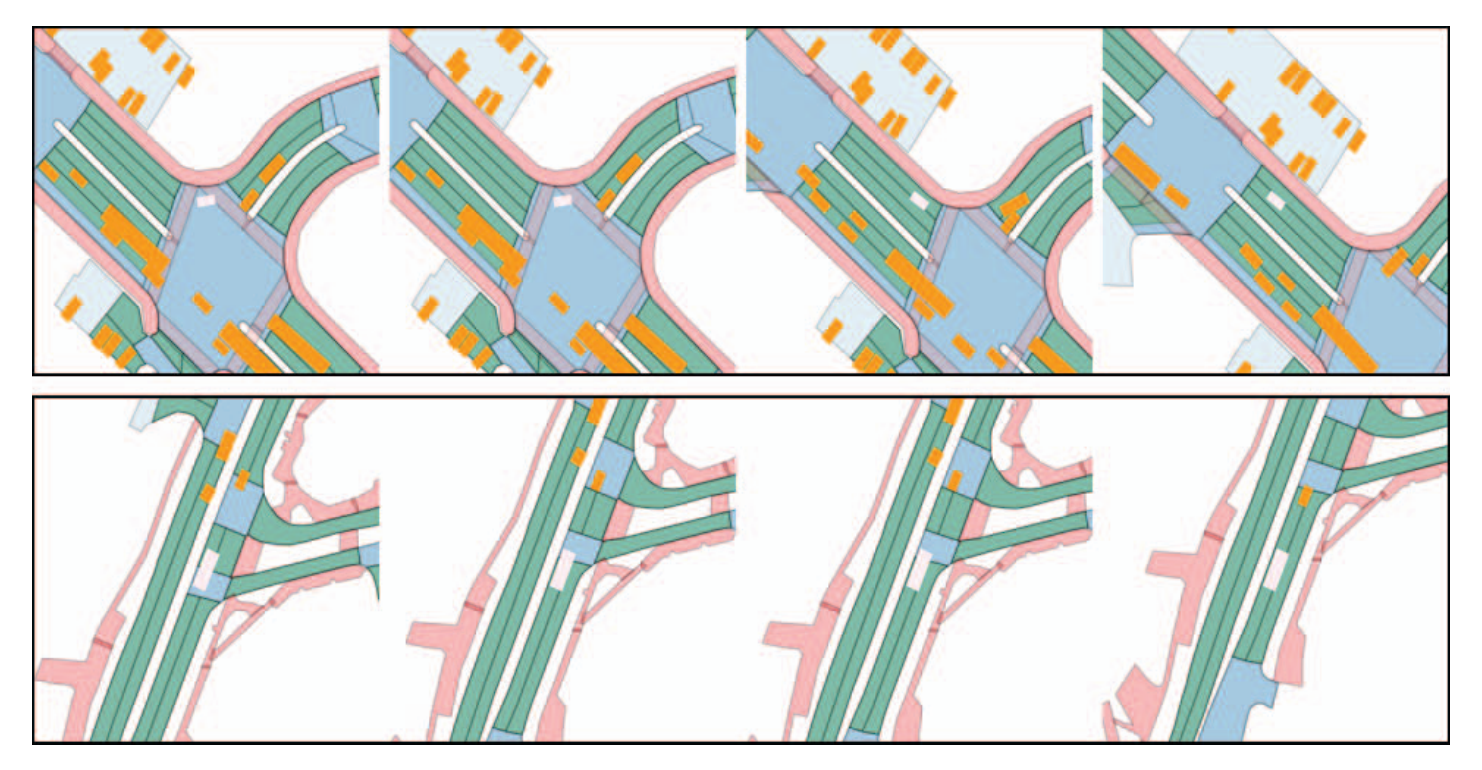
最终,每个场景为输入 xtSM(t ∈ [T − Tp])提供 (𝒯t, Θt, ℬt, we, he)。与真实驾驶数据集不同,如图 3 所示,合成数据中的自车在不同场景中尺寸可以不同,因此每个实例还包含自车的宽与高 (we, he)。
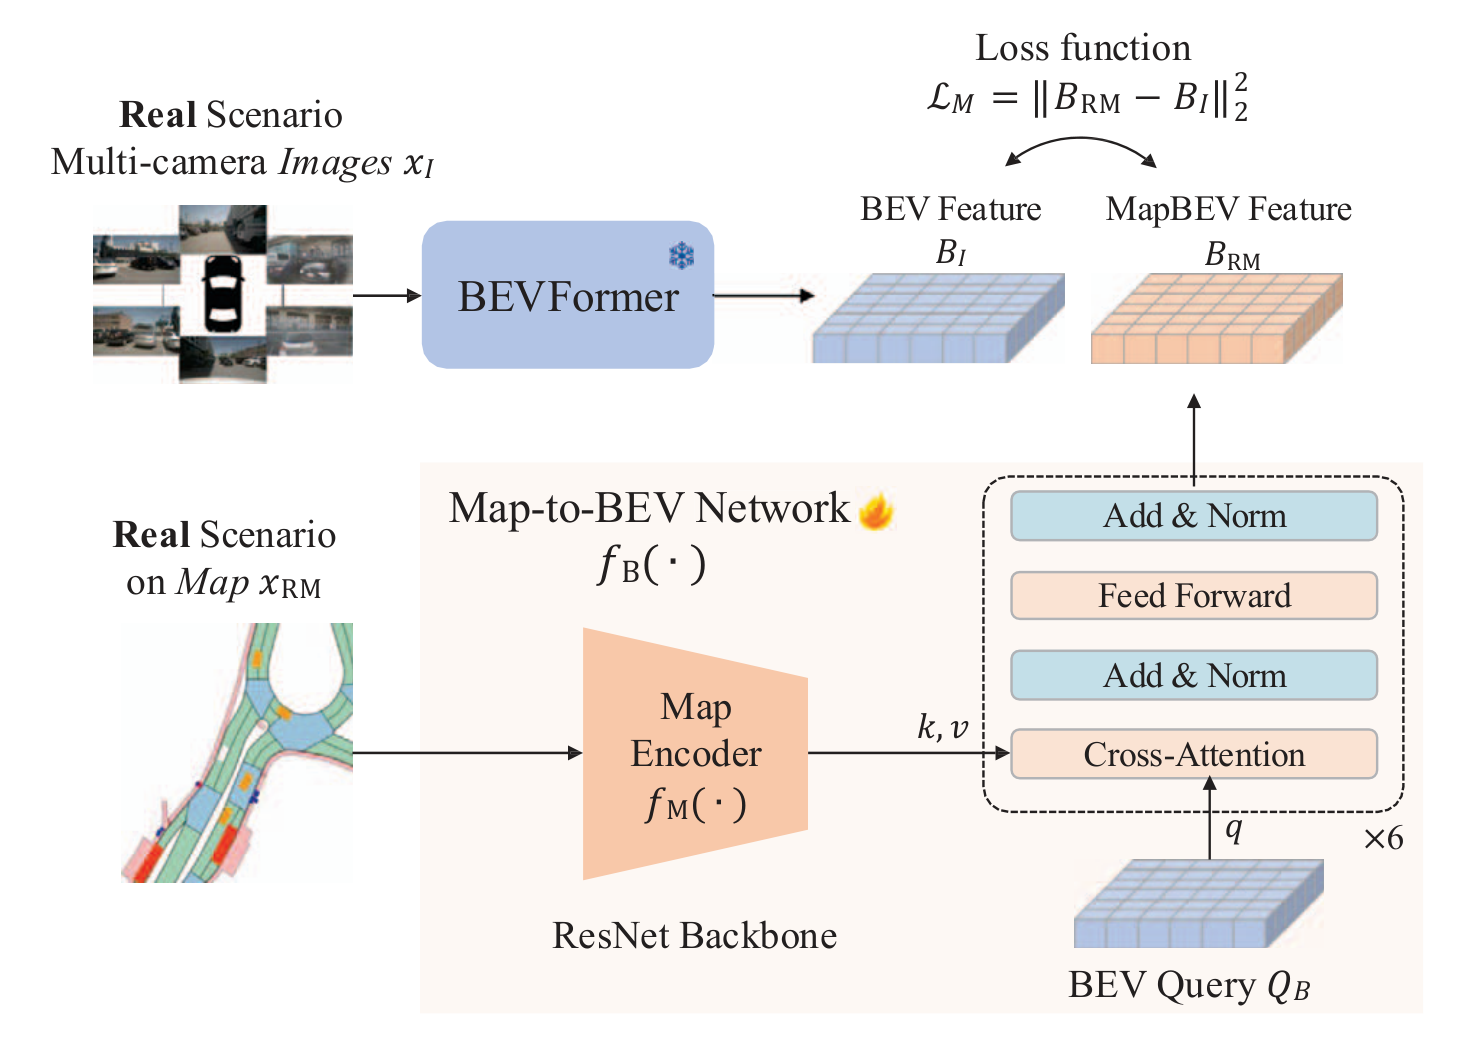
为解决合成场景中传感器输入(如多相机图像或 LiDAR)缺失的问题,我们提出地图到BEV网络 fB,直接从以自车为中心的地图输入生成 BEV 特征。与合成数据生成管线一致,我们从真实场景导出地图输入 xRM。地图编码器 fM 把 xRM 处理为空间特征,作为 Transformer 编码器的键(key)与值(value);可学习查询 QB 作为查询(query)输入,产出 mapBEV 特征。编码过程如下:
该设计使 Transformer 编码器能捕捉地图特征内的空间关系,产出精确的基于地图的 BEV 表示。与此同时,我们利用预训练的 BEVFormer [17] 从多相机图像 xI 提取 BEV 特征 BI,xI 与地图输入 xRM 相对应。为对齐从地图提取的 BEV 特征(BRM)与从多相机图像提取的 BEV 特征(BI),我们采用 L2 损失函数。训练地图到BEV网络的损失函数可表示为:
这一步使地图到BEV网络在不依赖传感器输入的情况下生成 BEV 特征。由此,我们可以从 xSM 编码 BEV 特征,实现用合成场景训练 E2E AD 模型。
训练时,我们同时使用生成数据 xSM、多相机图像数据 xI 与真实数据 xRM。图像数据 xI 送入 BEVFormer 产出 BEV 特征 BI;地图数据 xRM 与 xSM 经过地图到BEV网络分别得到 BRM 与 BSM。E2E AD 模型通常包含三个主要的基于 BEV 的模块:处理跟踪与建图的感知模块、负责运动预测与占用预测的预测模块,以及规划模块。由于我们的地图输入已包含大部分感知级信息,我们不把它纳入感知模块,而是聚焦于把地图数据集成进预测与规划模块。下面对各模块作简要介绍,更多细节见补充材料 B。
运动预测。 为在多时间戳上预测多智能体、含可能的 N 组路径点的轨迹,我们采用基于可变形交叉注意力(deformable cross-attention)[39] 的运动编码器(MotionEncoder)与运动解码器(MotionDecoder)。运动编码器产出运动查询嵌入 qmotion,表示一般运动模式、以智能体为中心的运动偏移以及与自车的关系。运动解码器用 BEV 特征精炼该嵌入,得到多条预测轨迹 x̂n 及其概率 pn。为处理多假设输出,我们通过最小化随时间的平均位移误差,找到最接近真值轨迹 xGT 的轨迹 x̂n*,并计算联合负对数似然损失:
配合最小最终位移误差(minFDE),总运动预测损失 ℒmotion 定义为:
其中 λJNLL 与 λminFDE 为对应的损失权重。
占用预测。 占用预测模块预测未来占用图。使用来自运动预测模块的嵌入 q̂motion,先导出时序查询 qtemp;随后时序查询经基于 Transformer 的 OctDecoder 精炼降采样的 BEV 特征 Bt−1state,产出更新后的 BEV 特征 Btstate。处理完所有时间戳后,把最终 BEV 特征与实例查询结合,产出占用图 Ôt。预测占用图 Ô = {Ô1, …, ÔT} 与真值占用图 OGT 比较并计算占用预测损失 ℒocc,其由 dice 损失 ℒdice 与二元交叉熵损失 ℒbce 组成:
其中 λdice 与 λbce 为对应的损失权重。
规划。 沿用先前工作 [11, 12],我们把高层指令嵌入与可学习参数拼接,经线性层构成初始规划查询 qplan。基于 Transformer 的规划解码器(PlanDecoder)以适配后的 BEV 特征 Ba 作为键与值输入精炼该查询:
随后 q̂plan 经 MLP 得到位移向量 Δτ̂ = MLP(q̂plan)。跨时间步累计求和这些位移即得最终预测轨迹 τ̂。规划损失定义为模仿损失与碰撞损失之和,均由 τ̂ 计算。模仿损失度量 τ̂ 与真值轨迹 τ 的 L2 距离。碰撞损失方面,我们取自车在时间戳 t 的边界框:
其中 δ 为安全裕度。随后用 b̂t(δ) 与每辆其他车辆的边界框 bti 在全部时间步上的 IoU 计算碰撞损失。对多个 δ 取值组合这些损失,得规划损失:
注意,在用生成场景训练时,(we, he) 可以变化;真值轨迹 τ 取自 𝒯(式 9),每个边界框 bti 是 ℬ(式 11)中的元素。最后,E2E AD 训练的损失函数通过引入缩放因子表示为:
地图数据集成。 我们把基于地图的 BEV 特征纳入运动预测与规划模块——在这些模块中,额外的上下文信息(如道路几何、交通结构)被证明是有益的。相比之下,占用预测需要高空间精度,2D 地图数据帮助有限 [36];因此我们对该模块排除地图输入,以防止性能退化。实验结果证实,这种选择性集成避免了整体性能的退化,并保持了仅图像输入下较强的测试时精度。
场景生成。 所有实验使用 nuScenes [1]——一个包含 1,000 个场景的真实世界驾驶数据集。每个 nuScenes 场景由 40 帧视频组成,以 2Hz 采集 20 秒视频。我们把未来预测时间戳 Tp 设为 6,即每个场景产出 34 个训练实例。主结果中,我们从零训练模型 5 个 epoch,同时加入 500 个合成场景——若只用原始 nuScenes 数据集训练,等效于 7.5 个 epoch。尽管增加了这些数据,我们的总训练成本仍低于其他 E2E AD 方法。消融实验除另有说明外使用 100 个合成场景训练。为保持足够的交互复杂度,我们排除任何只含单个驾驶智能体的实例。
训练细节。 训练地图到BEV网络时,冻结预训练 BEVFormer [17],只更新地图到BEV网络参数,共 20 个 epoch。E2E AD 模型则各模块从零训练,同时保持 BEVFormer 与地图到BEV网络冻结。测试时采用来自 UniAD [12] 的基于占用的优化。所有实验在 8 块 NVIDIA RTX 4090 GPU 上进行,每块 GPU batch size 为 1。更多细节见补充材料 C。
我们在 nuScenes 验证集上评估,场景生成采用 CTG++ [37] 指标,E2E AD 任务采用 VAD [13] 评估协议,确保与现有方法一致。报告规则详见补充材料 D。
场景生成。 表 1 用三个指标评估生成的路径:rule、real 与 rel real。rule 指标度量生成的轨迹对给定规则的遵守程度;real 用 Wasserstein 距离度量与真实数据的绝对相似性;rel real 评估车辆间场景级交互的真实感。我们的方法展现出对交通约束的稳健遵守,这从其显著的 rule 得分可见。尽管它的 real 得分略低——表明与精确真实轨迹的对应关系较松——但取得了更高的 rel real 得分,凸显了更精细的多智能体交互。这些结果表明,生成的轨迹偏离真实路径,同时仍捕捉到多样的驾驶行为,这对构建更鲁棒的 E2E AD 系统是有利的。
| 方法 | 无碰撞(no collision)↓ | 不出路面(no offroad)↓ | ||||
|---|---|---|---|---|---|---|
| rule | real | rel real | rule | real | rel real | |
| BITS [31] | 0.065 | 0.099 | 0.352 | 0.018 | 0.099 | 0.355 |
| BITS+opt [31] | 0.041 | 0.070 | 0.353 | 0.005 | 0.100 | 0.358 |
| CTG [38] | 0.052 | 0.044 | 0.346 | 0.002 | 0.042 | 0.346 |
| CTG++ [37] | 0.036 | 0.040 | 0.332 | 0.004 | 0.038 | 0.328 |
| SynAD(本文) | 0.033 | 0.045 | 0.330 | 0.002 | 0.040 | 0.324 |
规划。 表 2 从两个视角展示规划性能:以相对真值路径的 L2 距离误差度量的轨迹精度,以及以与其他车辆碰撞率表示的安全性。我们的 SynAD 模型由于生成行为分布更广,L2 距离误差略高,但在所有基线中取得最低碰撞率,表明其避碰能力更优。这一权衡源于场景生成阶段更强调多样、真实的交互,产出的轨迹更安全、但不一定与真值(GT)匹配。由于真实世界驾驶把避碰置于精确复现路径之上,我们的方法尤其适合实际部署。此外,SynAD 是唯一在训练中纳入车辆尺寸变化的方法,进一步增强了其对真实驾驶条件的适应性。
| 方法 | L2(m) ↓ | 碰撞率(%) ↓ | ||||||
|---|---|---|---|---|---|---|---|---|
| 1s 2s 3s Avg. | 1s 2s 3s Avg. | |||||||
| 1s | 2s | 3s | Avg. | 1s | 2s | 3s | Avg. | |
| ST-P3† [11] | 1.33 | 2.11 | 2.90 | 2.11 | 0.23 | 0.62 | 1.27 | 0.71 |
| UniAD [12] | 0.48 | 0.74 | 1.07 | 0.76 | 0.12 | 0.13 | 0.28 | 0.17 |
| VAD [13] | 0.41 | 0.70 | 1.05 | 0.72 | 0.07 | 0.17 | 0.41 | 0.22 |
| OCCNet† [26] | 1.29 | 2.31 | 2.99 | 2.14 | 0.21 | 0.59 | 1.37 | 0.72 |
| Paradrive [28] | 0.25 | 0.46 | 0.74 | 0.48 | 0.14 | 0.23 | 0.39 | 0.25 |
| OCCWorld [36] | 0.32 | 0.61 | 0.98 | 0.64 | 0.06 | 0.21 | 0.47 | 0.24 |
| SynAD(本文) | 0.52 | 0.78 | 1.10 | 0.80 | 0.04 | 0.10 | 0.20 | 0.11 |
预测。 运动预测与占用预测结果反映了 E2E AD 模型理解与预判周围物体及智能体行为的能力。表 3 显示 SynAD 在准确预测周围智能体运动方面表现出色,并对环境占用保持扎实理解。即使引入合成数据这一新输入类型,模型在仅图像输入的测试中依然表现稳健,验证了集成策略的有效性。
| 方法 | 运动预测 ↓ | 占用预测 ↑ | |||
|---|---|---|---|---|---|
| minADE | minFDE | MR | IoU-n | IoU-f | |
| UniAD [12] | 0.75 | 1.10 | 0.166 | 61.9 | 39.7 |
| VAD* [13] | 0.78 | 1.11 | 0.169 | – | – |
| Paradrive [28] | 0.73 | 1.08 | 0.162 | 60.0 | 36.4 |
| SynAD(本文) | 0.69 | 1.01 | 0.154 | 60.5 | 39.6 |
训练策略。 为在 E2E AD 框架中有效利用合成场景,我们用投影到地图上的真实场景 xRM 作为训练桥梁。表 4 给出该方法的结果。首先,把 xSM 纳入规划模块训练显著改善规划性能,再加 xRM 带来适度的额外增益。然而,把真实地图扩展到占用预测模块时,性能下降——表明仅 2D 地图表示不足以胜任该任务。这些结果表明,从地图数据提取的 BEV 特征足以支撑运动预测与规划,但不足以支撑占用预测;后者往往需要更丰富的空间信息,正如利用 3D 数据提升性能的 OCCNet [26] 与 OCCWorld [36] 所证明的。因此,我们的主训练策略只通过地图数据更新运动预测与规划模块。
| 更新模块 | 运动预测 ↓ | 占用预测 ↑ | 规划(avg.) ↓ | |||||||
|---|---|---|---|---|---|---|---|---|---|---|
| xRM | xSM | minADE | minFDE | MR | IoU-n | IoU-f | L2 | Col. | ||
| Mot. | Occ. | Plan | Plan | |||||||
| 0.76 | 1.11 | 0.162 | 60.1 | 38.9 | 1.15 | 0.25 | ||||
| ✓ | 0.75 | 1.13 | 0.166 | 59.3 | 38.3 | 0.82 | 0.19 | |||
| ✓ | ✓ | 0.77 | 1.15 | 0.168 | 60.2 | 39.0 | 0.79 | 0.18 | ||
| ✓ | ✓ | ✓ | 0.77 | 1.14 | 0.167 | 58.4 | 37.6 | 0.78 | 0.18 | |
| ✓ | ✓ | ✓ | 0.73 | 1.06 | 0.157 | 60.2 | 39.2 | 0.77 | 0.14 | |
合成场景的规模。 表 5 展示在两种训练协议下,合成场景数量变化对性能的影响:一种保持相同训练步数,另一种保持相同 epoch 数。不使用合成场景时,模型仅依赖多相机图像数据,构成基线。在同一步数协议下,引入适量合成场景能改善结果,但继续增加收益递减。在相同 epoch 协议下,引入更多合成场景持续提升性能,表明在足够训练迭代下模型受益于更广的覆盖。两种协议下,L2 距离都随场景增多而趋于上升,反映合成场景分布更广。尤其值得注意的是,在与基线相同训练步数下的更快收敛,凸显了使用合成场景的优势。
| # 合成场景 | 运动预测 ↓ | 占用预测 ↑ | 规划(avg.) ↓ | ||||
|---|---|---|---|---|---|---|---|
| minADE | minFDE | MR | IoU-n | IoU-f | L2 | Col. | |
| 基线 | |||||||
| 0 | 0.76 | 1.11 | 0.162 | 60.1 | 38.9 | 1.15 | 0.25 |
| 同一步数(公平比较) | |||||||
| 100 | 0.73 | 1.06 | 0.157 | 60.2 | 39.2 | 0.77 | 0.14 |
| 300 | 0.72 | 1.02 | 0.153 | 59.4 | 38.6 | 0.81 | 0.13 |
| 500 | 0.73 | 1.03 | 0.155 | 59.4 | 38.7 | 0.85 | 0.14 |
| 相同 epoch(更长时间训练) | |||||||
| 100 | 0.72 | 1.04 | 0.156 | 60.3 | 39.1 | 0.76 | 0.13 |
| 300 | 0.71 | 1.02 | 0.155 | 60.3 | 39.4 | 0.77 | 0.12 |
| 500 | 0.69 | 1.01 | 0.154 | 60.5 | 39.6 | 0.80 | 0.11 |
地图到BEV网络架构。 表 6 给出地图到BEV网络不同架构的消融结果。我们与 SwinUNETR [9] 比较——后者保持地图与 BEV 特征间的空间对应关系。一个观察是 SwinUNETR 需要高分辨率输入才能达到足够性能,导致更高计算成本。训练每个地图到BEV网络变体后,我们用验证集上的 L2 损失(即 Lvalmap)评估 BEV 特征质量;再比较受地图数据影响的 E2E AD 训练中运动预测与规划的性能。结果表明,我们的设计优于 SwinUNETR 且计算成本更低。
| 架构 | 输入分辨率 | Lvalmap ↓ (×10−2) | minADE | minFDE | MR | 规划 L2 | 规划 Col. |
|---|---|---|---|---|---|---|---|
| SwinUNETR | 800 | 9.55 | 0.75 | 1.11 | 0.158 | 1.08 | 0.26 |
| 本文 | 224 | 8.96 | 0.73 | 1.06 | 0.157 | 0.77 | 0.14 |
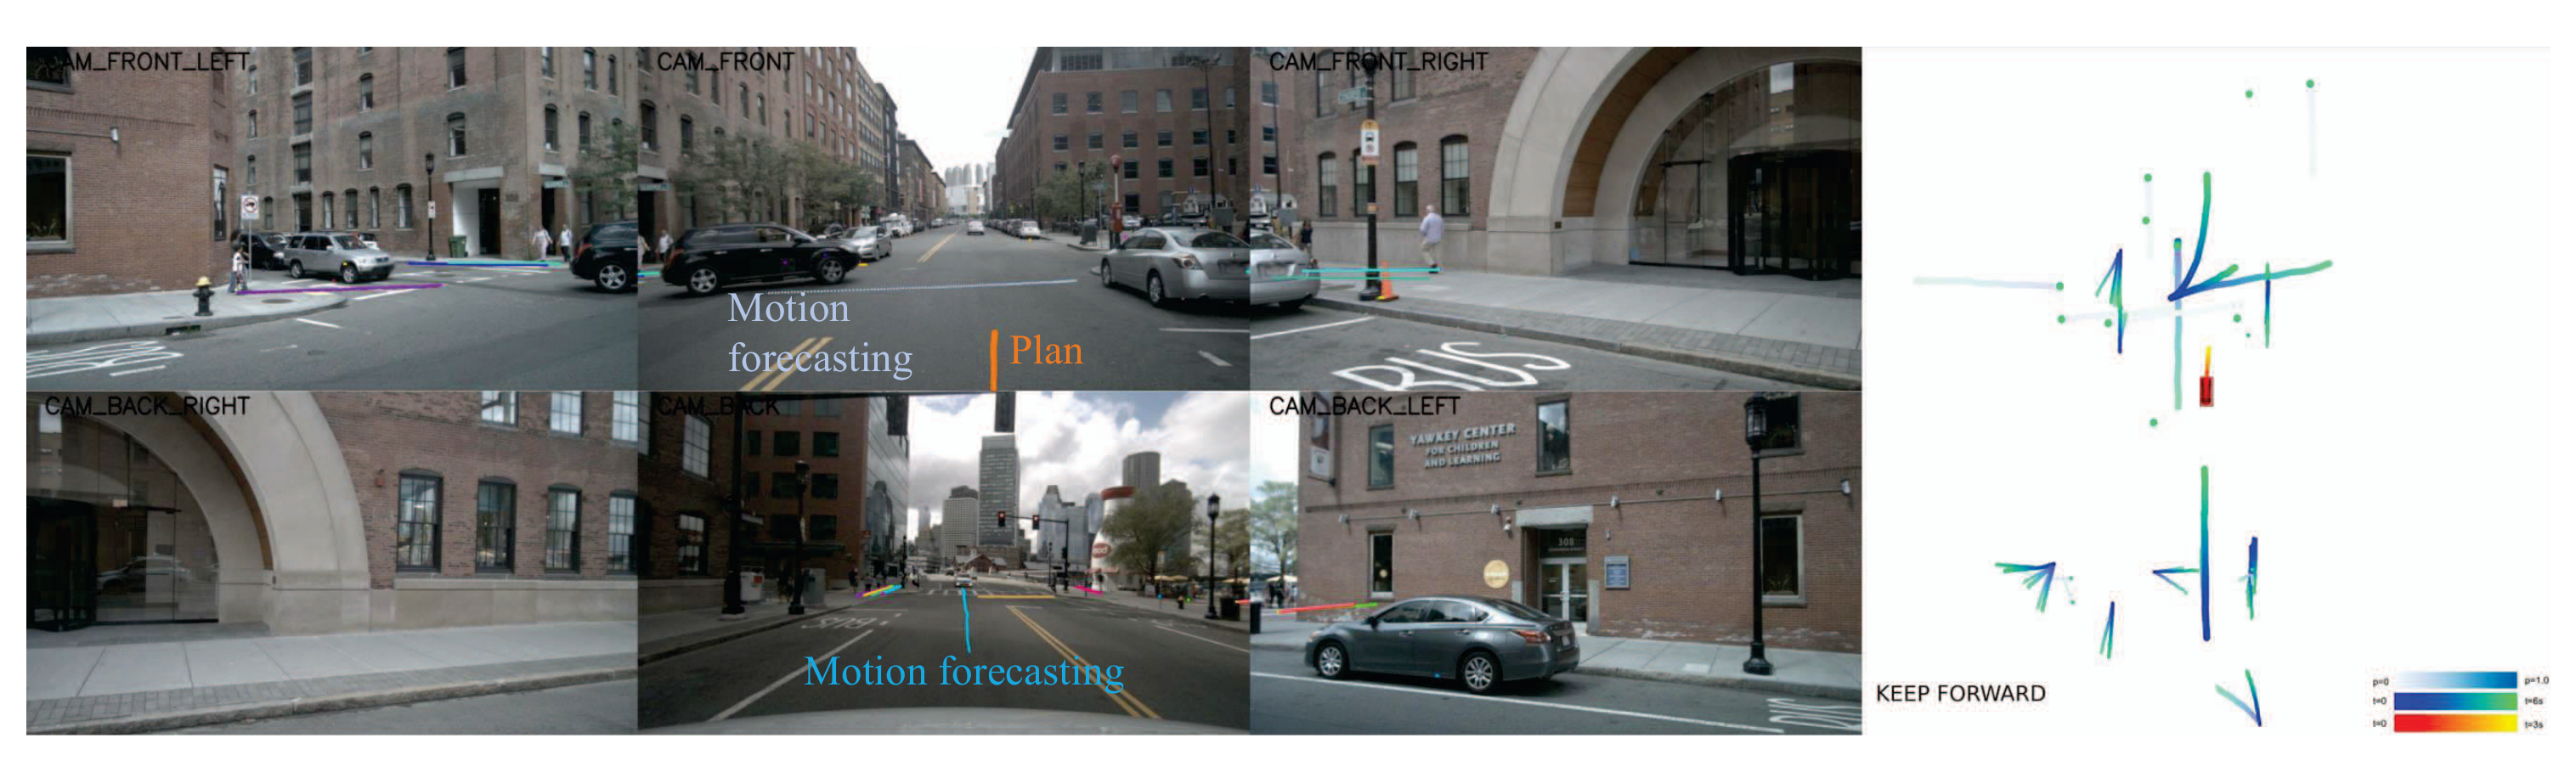
场景生成的引导项组合。 表 7 展示式 (6) 中不同引导项组合对规划性能的影响。agent 引导防止智能体间碰撞,map 引导防止与地图要素碰撞,speed 引导同时约束最小与最大速度。加入 map 与 speed 引导逐步降低碰撞率,表明这些额外约束增强了安全性。我们聚焦于特定的引导函数,而扩展该方法(如使用 LLM 或基于检索的引导)留作未来工作。
| 引导项 | L2(m) ↓ | 碰撞率(%) ↓ | ||||||||
|---|---|---|---|---|---|---|---|---|---|---|
| agent | map | speed | 1s | 2s | 3s | Avg. | 1s | 2s | 3s | Avg. |
| ✓ | 0.48 | 0.73 | 1.05 | 0.75 | 0.05 | 0.15 | 0.35 | 0.18 | ||
| ✓ | ✓ | 0.49 | 0.74 | 1.06 | 0.76 | 0.05 | 0.12 | 0.27 | 0.15 | |
| ✓ | ✓ | ✓ | 0.50 | 0.75 | 1.07 | 0.77 | 0.05 | 0.11 | 0.26 | 0.14 |
自车选择规则。 在合成场景生成中,我们实验了三种自车选择规则:random、dynamic 与 longest。每种规则都只从在生成时间戳上位移至少 1m 的车辆中选取,以保证训练有意义。random 规则选取满足该条件的任意车辆;dynamic 规则指定横向(x 轴)位移最大的车辆;longest 规则按式 (7) 选取行驶距离最长的自车。表 8 同时给出规划性能与自车在未来时间戳 Tp 上的平均行驶距离。按 longest 规则选取自车时,模型取得最低碰撞率;且 longest 规则在轨迹距离充足的情况下取得最低 L2 误差。基于这些结果,longest 规则被设为我们纳入 E2E AD 训练的合成场景的自车选择规则。
| 规则 | Dist. | L2(m) ↓ | 碰撞率(%) ↓ | ||||||
|---|---|---|---|---|---|---|---|---|---|
| 1s | 2s | 3s | Avg. | 1s | 2s | 3s | Avg. | ||
| Random | 3.67 | 0.51 | 0.77 | 1.09 | 0.79 | 0.06 | 0.11 | 0.31 | 0.16 |
| Dynamic | 3.68 | 0.50 | 0.77 | 1.11 | 0.79 | 0.04 | 0.10 | 0.31 | 0.15 |
| Longest | 3.70 | 0.50 | 0.75 | 1.07 | 0.77 | 0.05 | 0.11 | 0.26 | 0.14 |
我们提出 SynAD——一种把合成场景集成进真实世界 E2E AD 模型的新方法。SynAD 克服了此前把此类集成局限于仿真器等虚拟环境的限制。通过利用基于地图的 BEV 特征编码,我们在不依赖多相机图像或 LiDAR 数据等传感器输入的情况下实现合成场景的训练。我们还提出以自车为中心的场景生成方法与战略性集成方法。与此同时,集成合成场景对融入现有 E2E AD 管线有巨大潜力。我们把把该集成策略应用于其他 E2E AD 方法留作未来工作。
本工作由三星电子有限公司支持(IO231005-07280-01)。
[1] Holger Caesar, Varun Bankiti, Alex H Lang, Sourabh Vora, Venice Erin Liong, Qiang Xu, Anush Krishnan, Yu Pan, Giancarlo Baldan, and Oscar Beijbom. nuScenes: A multimodal dataset for autonomous driving. In CVPR, pages 11621–11631, 2020.
[2] Long Chen, Lukas Platinsky, Stefanie Speichert, Błażej Osiński, Oliver Scheel, Yawei Ye, Hugo Grimmett, Luca Del Pero, and Peter Ondruska. What data do we need for training an av motion planner? In ICRA, pages 1066–1072. IEEE, 2021.
[3] Shaoyu Chen, Tianheng Cheng, Xinggang Wang, Wenming Meng, Qian Zhang, and Wenyu Liu. Efficient and robust 2d-to-bev representation learning via geometry-guided kernel transformer. arXiv preprint arXiv:2206.04584, 2022.
[4] Wenhao Ding, Baiming Chen, Minjun Xu, and Ding Zhao. Learning to collide: An adaptive safety-critical scenarios generating method. In IROS, pages 2243–2250. IEEE, 2020.
[5] Wenhao Ding, Yulong Cao, Ding Zhao, Chaowei Xiao, and Marco Pavone. RealGen: Retrieval augmented generation for controllable traffic scenarios. arXiv preprint arXiv:2312.13303, 2023.
[6] Alexey Dosovitskiy, German Ros, Felipe Codevilla, Antonio Lopez, and Vladlen Koltun. CARLA: An open urban driving simulator. In Conference on Robot Learning, pages 1–16. PMLR, 2017.
[7] David González, Joshué Pérez, Vicente Milanés, and Fawzi Nashashibi. A review of motion planning techniques for automated vehicles. IEEE Transactions on Intelligent Transportation Systems, 17(4):1135–1145, 2015.
[8] Niklas Hanselmann, Katrin Renz, Kashyap Chitta, Apratim Bhattacharyya, and Andreas Geiger. KING: Generating safety-critical driving scenarios for robust imitation via kinematics gradients. In ECCV, pages 335–352. Springer, 2022.
[9] Ali Hatamizadeh, Vishwesh Nath, Yucheng Tang, Dong Yang, Holger R Roth, and Daguang Xu. Swin UNETR: Swin transformers for semantic segmentation of brain tumors in MRI images. In MICCAI Brainlesion Workshop, pages 272–284. Springer, 2021.
[10] Anthony Hu, Zak Murez, Nikhil Mohan, Sofía Dudas, Jeffrey Hawke, Vijay Badrinarayanan, Roberto Cipolla, and Alex Kendall. FIERY: Future instance prediction in bird's-eye view from surround monocular cameras. In ICCV, pages 15273–15282, 2021.
[11] Shengchao Hu, Li Chen, Penghao Wu, Hongyang Li, Junchi Yan, and Dacheng Tao. ST-P3: End-to-end vision-based autonomous driving via spatial-temporal feature learning. In ECCV, pages 533–549. Springer, 2022.
[12] Yihan Hu, Jiazhi Yang, Li Chen, Keyu Li, Chonghao Sima, Xizhou Zhu, Siqi Chai, Senyao Du, Tianwei Lin, Wenhai Wang, et al. Planning-oriented autonomous driving. In CVPR, pages 17853–17862, 2023.
[13] Bo Jiang, Shaoyu Chen, Qing Xu, Bencheng Liao, Jiajie Chen, Helong Zhou, Qian Zhang, Wenyu Liu, Chang Huang, and Xinggang Wang. VAD: Vectorized scene representation for efficient autonomous driving. In ICCV, pages 8340–8350, 2023.
[14] Chiyu Jiang, Andre Cornman, Cheolho Park, Benjamin Sapp, Yin Zhou, Dragomir Anguelov, et al. MotionDiffuser: Controllable multi-agent motion prediction using diffusion. In CVPR, pages 9644–9653, 2023.
[15] Alex Kendall, Jeffrey Hawke, David Janz, Przemyslaw Mazur, Daniele Reda, John-Mark Allen, Vinh-Dieu Lam, Alex Bewley, and Amar Shah. Learning to drive in a day. In ICRA, pages 8248–8254. IEEE, 2019.
[16] Tarasha Khurana, Peiyun Hu, Achal Dave, Jason Ziglar, David Held, and Deva Ramanan. Differentiable raycasting for self-supervised occupancy forecasting. In ECCV, pages 353–369. Springer, 2022.
[17] Zhiqi Li, Wenhai Wang, Hongyang Li, Enze Xie, Chonghao Sima, Tong Lu, Yu Qiao, and Jifeng Dai. BEVFormer: Learning bird's-eye-view representation from multi-camera images via spatiotemporal transformers. In ECCV, pages 1–18. Springer, 2022.
[18] Zhi Liu, Shaoyu Chen, Xiaojie Guo, Xinggang Wang, Tianheng Cheng, Hongmei Zhu, Qian Zhang, Wenyu Liu, and Yi Zhang. Vision-based uneven BEV representation learning with polar rasterization and surface estimation. In Conference on Robot Learning, pages 437–446. PMLR, 2023.
[19] Zhiyuan Liu, Leheng Li, Yuning Wang, Haotian Lin, Zhizhe Liu, Lei He, and Jianqiang Wang. Controllable traffic simulation through LLM-guided hierarchical chain-of-thought reasoning. arXiv preprint arXiv:2409.15135, 2024.
[20] Jack Lu, Kelvin Wong, Chris Zhang, Simon Suo, and Raquel Urtasun. SceneControl: Diffusion for controllable traffic scene generation. In ICRA, pages 16908–16914. IEEE, 2024.
[21] Tung Phan-Minh, Elena Corina Grigore, Freddy A Boulton, Oscar Beijbom, and Eric M Wolff. CoverNet: Multimodal behavior prediction using trajectory sets. In CVPR, pages 14074–14083, 2020.
[22] Jonah Philion and Sanja Fidler. Lift, Splat, Shoot: Encoding images from arbitrary camera rigs by implicitly unprojecting to 3d. In ECCV 2020, Part XIV 16, pages 194–210. Springer, 2020.
[23] Ethan Pronovost, Meghana Reddy Ganesina, Noureldin Hendy, Zeyu Wang, Andres Morales, Kai Wang, and Nick Roy. Scenario diffusion: Controllable driving scenario generation with diffusion. Advances in Neural Information Processing Systems, 36:68873–68894, 2023.
[24] Davis Rempe, Jonah Philion, Leonidas J Guibas, Sanja Fidler, and Or Litany. Generating useful accident-prone driving scenarios via a learned traffic prior. In CVPR, pages 17305–17315, 2022.
[25] Bo-Kai Ruan, Hao-Tang Tsui, Yung-Hui Li, and Hong-Han Shuai. Traffic scene generation from natural language description for autonomous vehicles with large language model. arXiv preprint arXiv:2409.09575, 2024.
[26] Wenwen Tong, Chonghao Sima, Tai Wang, Li Chen, Silei Wu, Hanming Deng, Yi Gu, Lewei Lu, Ping Luo, Dahua Lin, et al. Scene as occupancy. In ICCV, pages 8406–8415, 2023.
[27] Jingkang Wang, Ava Pun, James Tu, Sivabalan Manivasagam, Abbas Sadat, Sergio Casas, Mengye Ren, and Raquel Urtasun. AdvSim: Generating safety-critical scenarios for self-driving vehicles. In CVPR, pages 9909–9918, 2021.
[28] Xinshuo Weng, Boris Ivanovic, Yan Wang, Yue Wang, and Marco Pavone. Para-drive: Parallelized architecture for real-time autonomous driving. In CVPR, pages 15449–15458, 2024.
[29] Junkai Xia, Chenxin Xu, Qingyao Xu, Chen Xie, Yanfeng Wang, and Siheng Chen. Language-driven interactive traffic trajectory generation. arXiv preprint arXiv:2405.15388, 2024.
[30] Chejian Xu, Ding Zhao, Alberto Sangiovanni-Vincentelli, and Bo Li. DiffScene: Diffusion-based safety-critical scenario generation for autonomous vehicles. In The Second Workshop on New Frontiers in Adversarial Machine Learning, 2023.
[31] Danfei Xu, Yuxiao Chen, Boris Ivanovic, and Marco Pavone. BITS: Bi-level imitation for traffic simulation. In ICRA, pages 2929–2936. IEEE, 2023.
[32] Wenda Xu, Qian Wang, and John M Dolan. Autonomous vehicle motion planning via recurrent spline optimization. In ICRA, pages 7730–7736. IEEE, 2021.
[33] Wenyuan Zeng, Wenjie Luo, Simon Suo, Abbas Sadat, Bin Yang, Sergio Casas, and Raquel Urtasun. End-to-end interpretable neural motion planner. In CVPR, pages 8660–8669, 2019.
[34] Jiawei Zhang, Chejian Xu, and Bo Li. ChatScene: Knowledge-enabled safety-critical scenario generation for autonomous vehicles. In CVPR, pages 15459–15469, 2024.
[35] Yunpeng Zhang, Zheng Zhu, Wenzhao Zheng, Junjie Huang, Guan Huang, Jie Zhou, and Jiwen Lu. BEVerse: Unified perception and prediction in birds-eye-view for vision-centric autonomous driving. arXiv preprint arXiv:2205.09743, 2022.
[36] Wenzhao Zheng, Weiliang Chen, Yuanhui Huang, Borui Zhang, Yueqi Duan, and Jiwen Lu. OccWorld: Learning a 3d occupancy world model for autonomous driving. In ECCV, pages 55–72. Springer, 2025.
[37] Ziyuan Zhong, Davis Rempe, Yuxiao Chen, Boris Ivanovic, Yulong Cao, Danfei Xu, Marco Pavone, and Baishakhi Ray. Language-guided traffic simulation via scene-level diffusion. In Conference on Robot Learning, pages 144–177. PMLR, 2023.
[38] Ziyuan Zhong, Davis Rempe, Danfei Xu, Yuxiao Chen, Sushant Veer, Tong Che, Baishakhi Ray, and Marco Pavone. Guided conditional diffusion for controllable traffic simulation. In ICRA, pages 3560–3566. IEEE, 2023.
[39] Xizhou Zhu, Weijie Su, Lewei Lu, Bin Li, Xiaogang Wang, and Jifeng Dai. Deformable DETR: Deformable transformers for end-to-end object detection. arXiv preprint arXiv:2010.04159, 2020.
本解读面向我们的工程项目——座舱监控(DMS/OMS)感知算法与数据闭环平台——评估这篇论文的可借鉴性,不重复原文结论。
先划边界:SynAD 是训练期方法,目标模型是环视相机 BEV 外部视图的 E2E 自动驾驶(跟踪/建图/运动预测/占用/规划),与我们的舱内单目/双目 DMS 检测、姿态估计、疲劳/分神分类在任务与数据形态上完全不同。它不能给我们:(a)任何可直接用于舱内感知的模型或权重;(b)Map-to-BEV 网络本身——它的对齐目标(BEVFormer 特征、nuScenes 地图投影)在我们场景中不存在对应物;(c)闭环或真车验证——全部评估是 nuScenes 验证集上的开环 L2/碰撞率,对"部署安全"的证明力有限;(d)场景生成模型本身,论文只负责消费扩散模型生成的路径级场景,生成器细节(如去噪网络结构、K 值)大多在补充材料中,且未给出仿真渲染环节。
我们没有 SynAD 的核心困难——"合成场景没有传感器数据"——因为我们的合成管线(Isaac Sim / Cosmos 渲染)本来就能直接输出相机图像,可以在像素域做增强,不需要"地图当替身"的迂回。我们还有:量产车回流的真实舱内数据(可做真实 ODD 覆盖评估,而 SynAD 只有 nuScenes 单一数据域);DMS 场景的安全关键样本(闭眼、遮挡、失能)可以主动构造并有生理真值约束;以及标注闭环,可以对"合成数据是否引入分布偏移"做逐属性回归。反过来说,SynAD 的场景是路径级扩散生成、结构化且可解释,比我们纯渲染式合成更贴近"交互动力学"层面——这是它比我们强的一点。
本文的缺口恰好是 R2SGen(真实→仿真场景生成) 一文的产物:SynAD 假设"路径级合成场景已存在",只解决"怎么喂进 E2E 模型";R2SGen 解决"真实数据如何生成可复用的仿真场景"。两者拼起来是完整链路——真实数据 → 场景生成(R2SGen)→ 结构化注入训练(SynAD)。对我们的数据闭环平台,启示是:合成数据的价值评估应该按"生成质量 + 注入策略"两段分别验收,而不是把整个合成管线当黑盒看终指标。