驾驶员瞌睡是一个严重威胁,频繁导致极度危险的交通事故。光照条件、面部特征遮挡、眼镜与误报等各种挑战使瞌睡检测复杂化,使精度、跨环境的鲁棒性与计算效率成为一个重大难题。本研究提出一种非侵入式驾驶员瞌睡检测系统,利用图像处理技术与先进的模糊逻辑方法。研究还对 Viola-Jones 算法进行了改进,以快速、准确地识别驾驶员面部、眼睛与嘴部。研究开展了涉及不同人员与场景的大量实验,以评估系统在检测眼部与嘴部状态方面的性能。结果非常有前景:眼睛检测准确率达 91.8%,嘴部检测达到 94.6%,超过已有方法。在包括昼夜场景以及戴眼镜与不戴眼镜受试者在内的多种条件下的实时测试,证明了系统的鲁棒性,驾驶员瞌睡检测的测试准确率达 97.5%。
根据 Peura 的研究,驾驶员瞌睡在全球交通事故中占有重要成因 [1]。这些事故每年造成超过 10 万起车辆碰撞与约 1,500 人死亡,导致每年近 125 亿美元的经济损失 [2]。约 35–45% 的道路交通事故由驾驶员疲劳导致 [3]。在疲劳恶化之前发现其最初征兆是可能的。因此,研究工作的重点强烈集中于预防此类由驾驶员疲劳引起的事故。在道路安全领域,驾驶员瞌睡的检测是预防潜在灾难性事故的关键因素。由长时间驾驶、睡眠不足与单调路况引起的驾驶员疲劳,会显著削弱驾驶员的警觉性与反应能力。因此,开发准确、及时的瞌睡检测技术,已成为降低疲劳驾驶风险的一项关键工作 [4]。
根据印度道路交通与公路部数据,2016 至 2021 年印度道路交通事故趋势为:2017 年事故有所下降,但 2018 年回升;2019 年显著下降,主要归因于安全措施的不断演进;2020 年疫情导致事故减少 18.46%;然而 2021 年死亡人数增长 16.9%,可能与解封后交通流量恢复有关。受伤人数遵循类似模式,至 2020 年持续下降,但 2021 年上升 10.39%。这些趋势凸显了道路安全的多面性,以及持续保持警惕并采取预防行动的必要性。
开发与改进驾驶员瞌睡检测技术的动机,深深植根于提升道路安全的迫切需求 [5]。疲劳驾驶是一个普遍而持久的问题,每年造成大量事故、伤亡与死亡。这一令人警醒的人员伤亡与事故带来的经济成本,凸显了应对该问题的关键重要性 [6]。瞌睡检测系统的目标是在疲劳驾驶员受损的警觉性酿成灾难之前进行干预,从而预防事故、挽救生命、减少伤亡 [7]。此外,这些系统也符合法律与伦理责任,支持自动驾驶汽车的兴起,并利用 AI 与传感器技术的进步,促成更安全的道路和公众对疲劳驾驶危害的更多认知 [8]。
减轻驾驶员疲劳事故的努力,集中于开发能够分析驾驶员状态并基于面部特征发出适当预警的监控系统。许多研究者集中于通过分析驾驶员瞳孔相关参数来识别疲劳驾驶 [9]。在这些研究中,先采集驾驶员的视频,用特定技术识别驾驶员面部,后续分析则通过评估眨眼频率来判断驾驶员的疲劳状态 [10]。一些研究者还将关注点扩展到与驾驶员嘴部相关的特征 [11]。但需要指出,这些系统在有效检测驾驶员瞌睡时可能遇到困难。光照变化与驾驶员引起的振动等因素,给驾驶员状态识别带来显著障碍 [12]。尽管如此,事实证明利用多种视觉特征与线索能更高效地准确检测驾驶员疲劳 [13]。
与此同时,基于计算机视觉与图像处理的方法成为一条有前景的路线。利用相机分析面部表情、眼动与注视方向,具有非侵入性的优势 [14]。这些方法利用机器学习算法解读预示瞌睡的视觉线索,例如眼睑下垂或长时间闭眼。然而,这些技术对外部因素敏感,如光照变化、多样的面部表情以及眼镜的存在,这些都会影响其精度与可靠性 [15]。机器学习尤其是深度学习进一步推动了该领域,使从数据中提取复杂特征与模式成为可能。卷积神经网络(CNN)等模型 [16] 在图像分析中展现出卓越性能,能够识别可能预示瞌睡的细微线索。决策树 [17]、逻辑回归 [18] 与支持向量机(SVM)[19] 也被用于基于提取特征进行瞌睡分类,推动了从基于规则到数据驱动方法的转变。
模糊逻辑擅长建模与处理不确定性,为应对驾驶员瞌睡的复杂性与主观性提供了理想平台。该框架通过模糊集与语言变量,容纳人类疲劳模式固有的可变性与模糊性,促成更细致、更自适应的瞌睡检测过程。此外,引入模糊逻辑框架带来了适应性与不精确性管理能力,认识到人类疲劳并非服从二值类别,而是在一定的确定度与模糊性范围内运作。总而言之,驾驶员瞌睡检测的发展轨迹已经从最初的单指标方法,演进为综合的多模态方法。
Riaz 等人(2018)提出了情感赋能认知驾驶辅助模型(EECDAM)以应对驾驶员分心,利用模糊逻辑与基于认知主体的计算评估影响分心的外部因素。通过生成基于恐惧的情绪反应并在超过阈值时向驾驶员报警,该模型强调认知与情绪干预,为分心管理提供了一条独特路线。相比之下,Azim 等人(2014)专注于瞌睡检测,开发了基于视频分析的全自动系统。他们的方法采用 Viola-Jones 人脸检测与空间模糊 C 均值聚类提取诸如闭眼时长与哈欠等面部特征,并用模糊专家系统(FES)分类,在不同光照与人群条件下取得了 100% 的准确率。这些进展补充了早期关于模糊逻辑疲劳检测的工作——Devi 与 Bajaj(2010)以及 Celecia 等人(2020)的便携式系统——展现了从一般模糊方法向更专门化、自适应系统的演进。与 Bakheet 与 Al-Hamadi(2021)以及 Feng 等人(2024)聚焦瞌睡相比,EECDAM 将范围扩展到与分心相关的道路安全,强调认知与情绪干预策略。
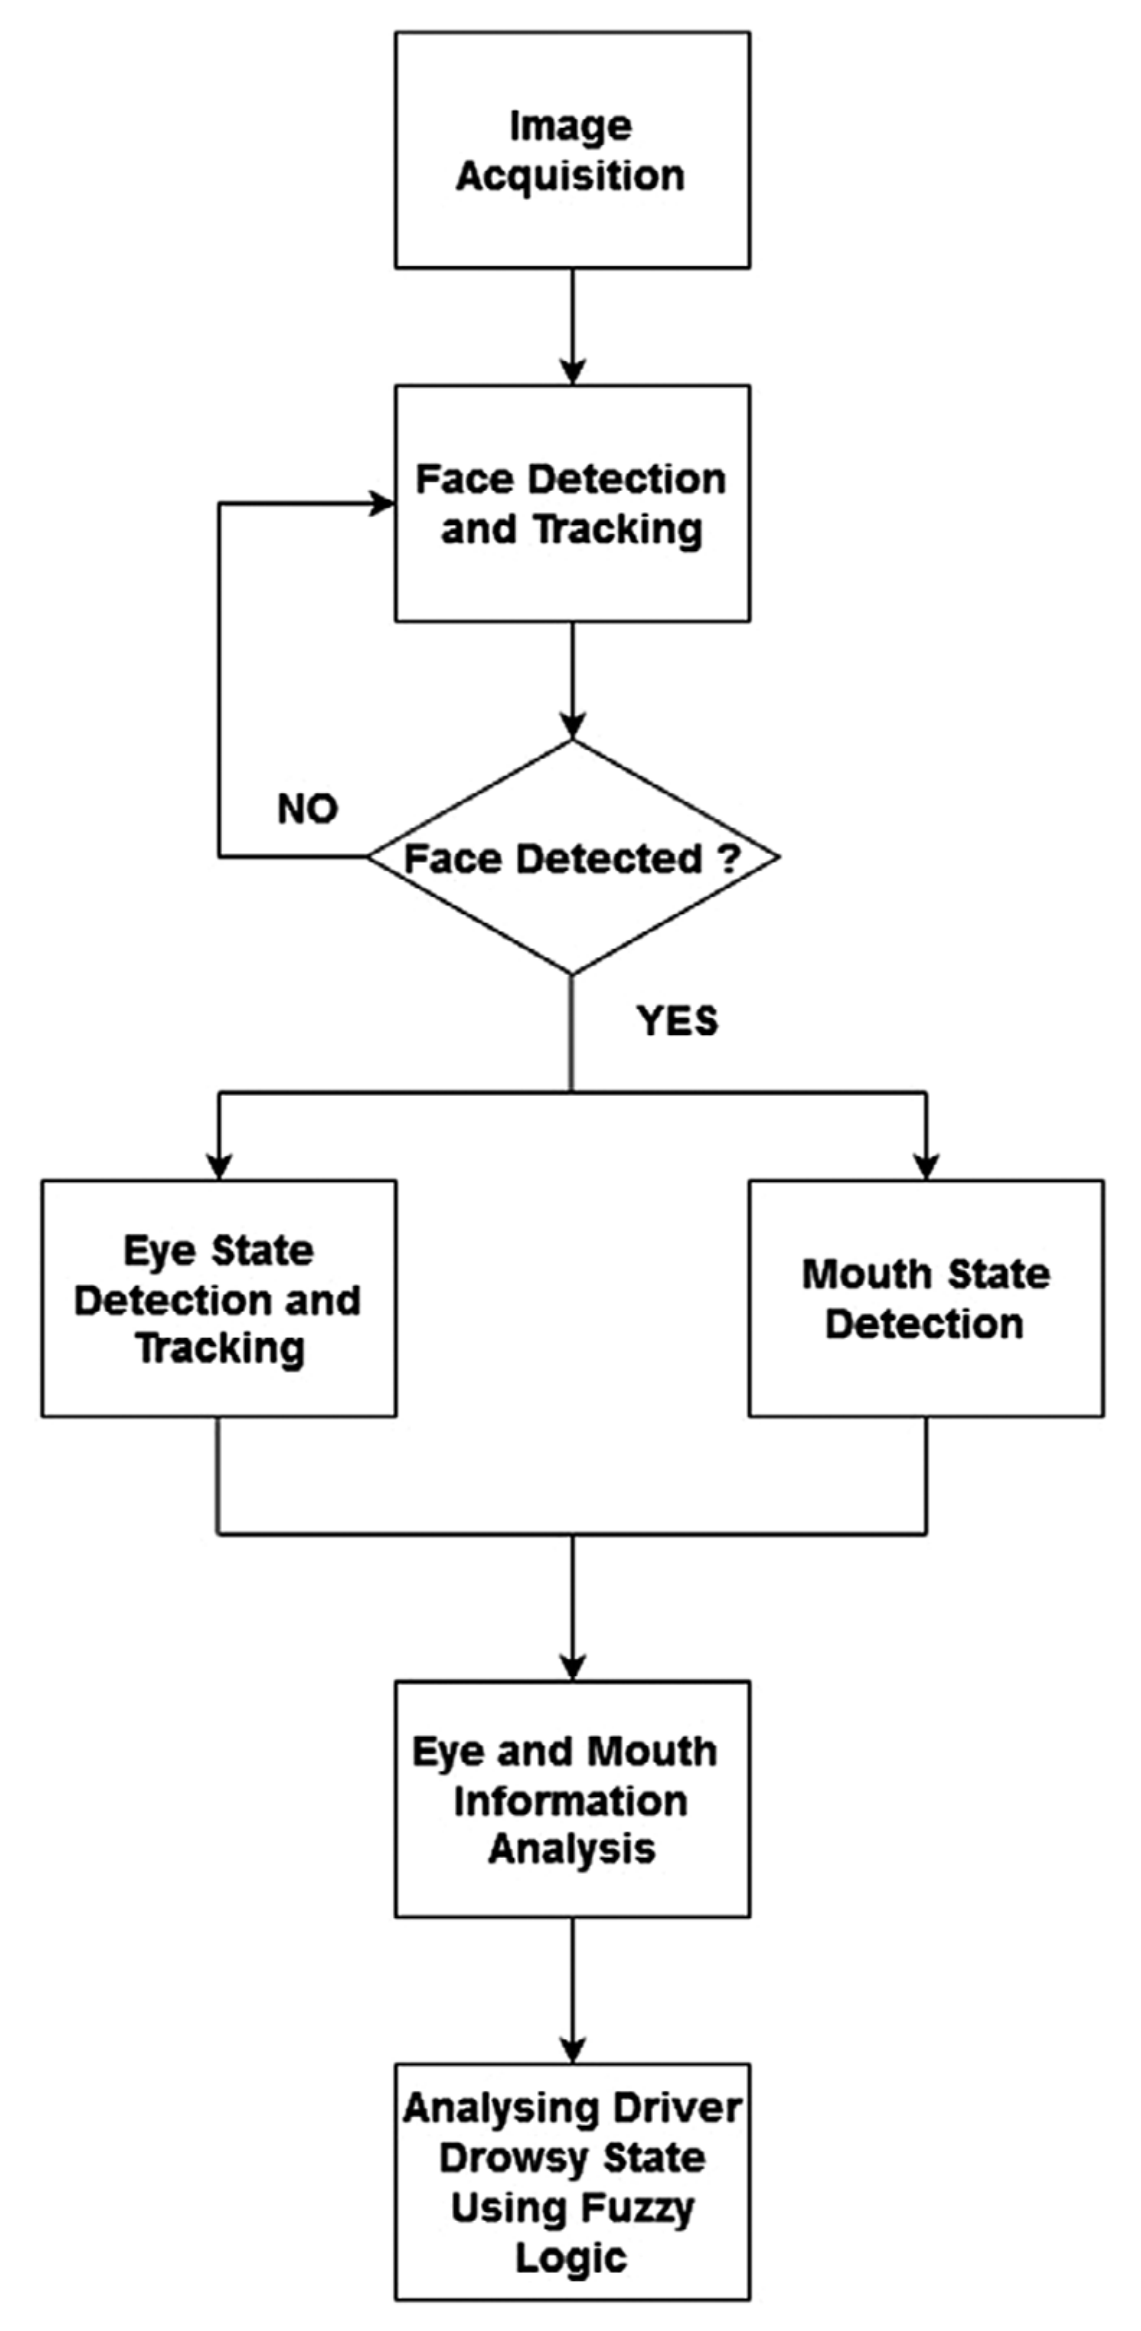
本研究所提出的方法——多疲劳特征选择与模糊逻辑框架——体现了这一演进的下一阶段。所提出的驾驶员瞌睡检测系统通过整合多种疲劳相关特征来提高准确性,包括 PERCLOS(单位时间内眼睑对瞳孔的闭合百分比)、眼睛纵横比(EAR)、嘴部纵横比(MAR)、最长连续闭眼时长以及哈欠次数。这种多方面特征选择刻画了导致瞌睡的因素之间的复杂相互作用。通过改进 Viola-Jones 算法,系统提升了检测关键面部标志点(尤其是对疲劳监测至关重要的驾驶员嘴唇与面部)的速度与准确性。通过引入模糊推理系统(FIS),系统以更高的精度评估不确定数据(如部分闭眼与轻微哈欠),处理疲劳检测中固有的模糊性。这种模糊逻辑方法可以实现更准确的状况评估。此外,系统设计为即使在具有挑战性的光照条件下也能可靠运行,确保在多种驾驶环境中的鲁棒检测。图 1 展示了所提出的驾驶员瞌睡检测系统的框图。所提出的基于多疲劳特征选择的驾驶员瞌睡检测系统的主要贡献如下:
(i) 对 Viola-Jones 算法引入显著改进,使其优化用于快速、准确地检测关键面部标志点,如驾驶员的眼睛、嘴部与面部。
(ii) 整合多种疲劳特征,如 PERCLOS、EAR、MAR、最长连续闭眼时长与哈欠次数,使系统能够覆盖广泛的疲劳相关征兆,从而提升整体检测准确性。
(iii) 开发一个 FIS,以更高精度处理固有的不确定与模糊数据(如部分闭眼与轻微哈欠),从而在光照变化、驾驶员个体差异等具有挑战性的场景下依然提升准确性与鲁棒性。
本文结构如下:第 2 节深入评述相关先行研究;第 3 节描述系统技术;第 4 节给出实验结果与分析;第 5 节总结全文并讨论未来方向。
疲劳检测已被广泛研究,研究者采用各种计算机视觉与图像处理算法来应对这一关键问题。这些方法通常可以按其关注的特征(如闭眼、头部朝向、面部标志点)与所采用的算法(如模板匹配、机器学习分类器、模糊逻辑)进行分类。本节概述该领域的重要方法,突出其优势、弱点与相互关系。
若干研究将闭眼时长与眨眼作为疲劳的主要指标。Min 等人 [20] 提出一种基于闭眼的疲劳检测算法,使用相关函数与在线眼部模板对眼睛状态分类。该方法的优势在于简单性与性能。然而,该算法依赖眼睑运动跟踪,在眼睛被部分遮挡或光照差的场景中可能出问题。Akrout 等人 [21] 通过在不同光照条件下采用 SVM 进行眼部验证对此加以改进。他们的方法通过应对光照挑战提升了眼睛检测的精度,弥补了此前工作的一大局限。尽管如此,该系统在极端光照条件(如夜间可见度差)下仍然吃力,揭示了此类环境对更鲁棒方法的需求。Mou 等人 [22] 提出各向同性自监督学习(IsoSSL)结合基于注意力的多模态融合,以克服小数据集的局限。该方法整合眼部、嘴部与头部运动数据,在具有挑战性的数据集上优于基线模型,但仍受数据质量与可变性的影响。
为将检测能力扩展到闭眼之外,若干研究纳入了头部朝向与注视估计。Kunasegaran 等人 [23] 提出将瞳孔检测与头部朝向分析相结合评估驾驶员疲劳的系统。该方法成功监测了注视与眨眼事件,提供了更全面的疲劳检测。然而,其对准确检测面部椭圆的依赖限制了性能,尤其在面部可见度可能受损的复杂驾驶场景中。Khan 等人 [24] 提出一种更具包容性的方法,同时追踪视觉焦点与倦怠迹象。该方法可以对头部旋转分类、恢复三维(3D)注视信息并检测微睡眠。然而,其依赖颜色统计区分嘴唇与眼睛,使该方法容易出错,尤其在驾驶员面部被遮挡或受快速光照变化影响的情形下 [25, 26]。Yang 等人 [27] 以一种基于视频的瞌睡检测方法推进了该领域,该方法优化关键面部特征(如标志点与局部面部区域)的利用。其使用空间滤波与双分支多头注意力模块,改善特征提取与类别判别,性能优于传统方法。
若干研究者通过整合多种视觉与行为特征扩展了疲劳检测的范围。Fernandez 等人 [28, 29] 开发了同时监测眼睑运动、面部朝向与注视的系统。虽然该系统对驾驶员警觉性提供了更全面的评估,但需要两套独立的图像采集设备,引入了复杂性与处理延迟。该系统还严重依赖仿真数据,使其在各种驾驶环境下的性能存在疑虑。Kolus 等人 [30] 更进一步,组合了 PERCLOS、眨眼频率、头部位置与注视等多个参数,将这些参数输入模糊逻辑分类器评估驾驶员疲劳。模糊逻辑方法使系统能有效处理不精确与不确定的数据,在夜间场景高度准确,达到接近 100% 的准确率。然而,该方法在明亮白天驾驶与驾驶员戴眼镜时面临显著局限,影响其鲁棒性。此外,多参数的纳入增加了计算负荷,降低了系统的处理能力。Yang 等人 [31] 提出一种基于高纯度特征分离(HPFS)的鲁棒驾驶员情绪识别方法,以应对个体差异与光照变化。该方法有效分离与表情相关的特征,展现出显著改进。
模糊逻辑因能够处理不确定与模糊数据,在驾驶员疲劳检测中受到重视 [32]。Tan 等人 [33] 采用模糊逻辑融合闭眼时长与转向行为进行瞌睡检测。该方法的优势在于融合多数据源的能力,对驾驶员疲劳给出更细致的评估。类似地,基于脑电(EEG)的系统利用模糊逻辑处理脑信号并评估认知疲劳。虽然这些系统在检测瞌睡方面表现出高准确率,但对 EEG 数据的依赖限制了其在各种驾驶场景中的非侵入式应用。若干研究者强调特征选择对提升基于模糊逻辑系统性能的重要性 [34]。例如,Wang 等人 [35] 将疲劳检测方法分为基于性能与基于状态的两类。他们对 PERCLOS、闭眼时长与头部位置的强调,提供了对疲劳特征的系统分析,但处理速度仍是挑战。Bruno 等人 [36] 同样利用模糊逻辑融合视觉参数,取得高准确率,但代价是计算复杂度增加。
虽然上述每一种方法都对驾驶员疲劳检测领域有显著推进,但它们并非没有局限 [37, 38]。基于闭眼的方法常受光照条件、遮挡与眼镜影响;头部朝向技术需要准确的面部跟踪,而快速头部运动或低图像质量会破坏跟踪 [39]。多特征与基于模糊逻辑的系统提供了更鲁棒的疲劳检测,但常在计算效率上捉襟见肘,使其在实时应用中的可行性降低 [40]。持续的挑战是开发一个既整合多种疲劳指标,又保持准确性、跨环境鲁棒性与实时效率的系统 [41, 48]。我们的工作通过在 Viola-Jones 算法基础上增强 EAR、MAR、PERCLOS 等疲劳特征来应对这些挑战。借助模糊逻辑进行决策,我们的系统为实时驾驶员疲劳检测提供了更全面的解决方案。
本研究提出一种非侵入式瞌睡检测方法。它由三个主要部分组成:人脸检测与特征提取、疲劳特征选择、以及模糊逻辑验证。
眨眼时长与嘴部状态信息这两个主要参数是关键因素。通过构建模糊控制器来推断驾驶员的瞌睡程度。它利用驾驶员眨眼时长与嘴部状态信息等视觉指标,确定驾驶员的瞌睡等级。瞌睡检测的总体流程在伪代码中描述。所提出的系统展示了如何用计算机视觉与模糊逻辑全面识别驾驶员瞌睡:它采用多阶段方法评估与跟踪驾驶员状态,包括图像处理、特征提取与模糊推理。
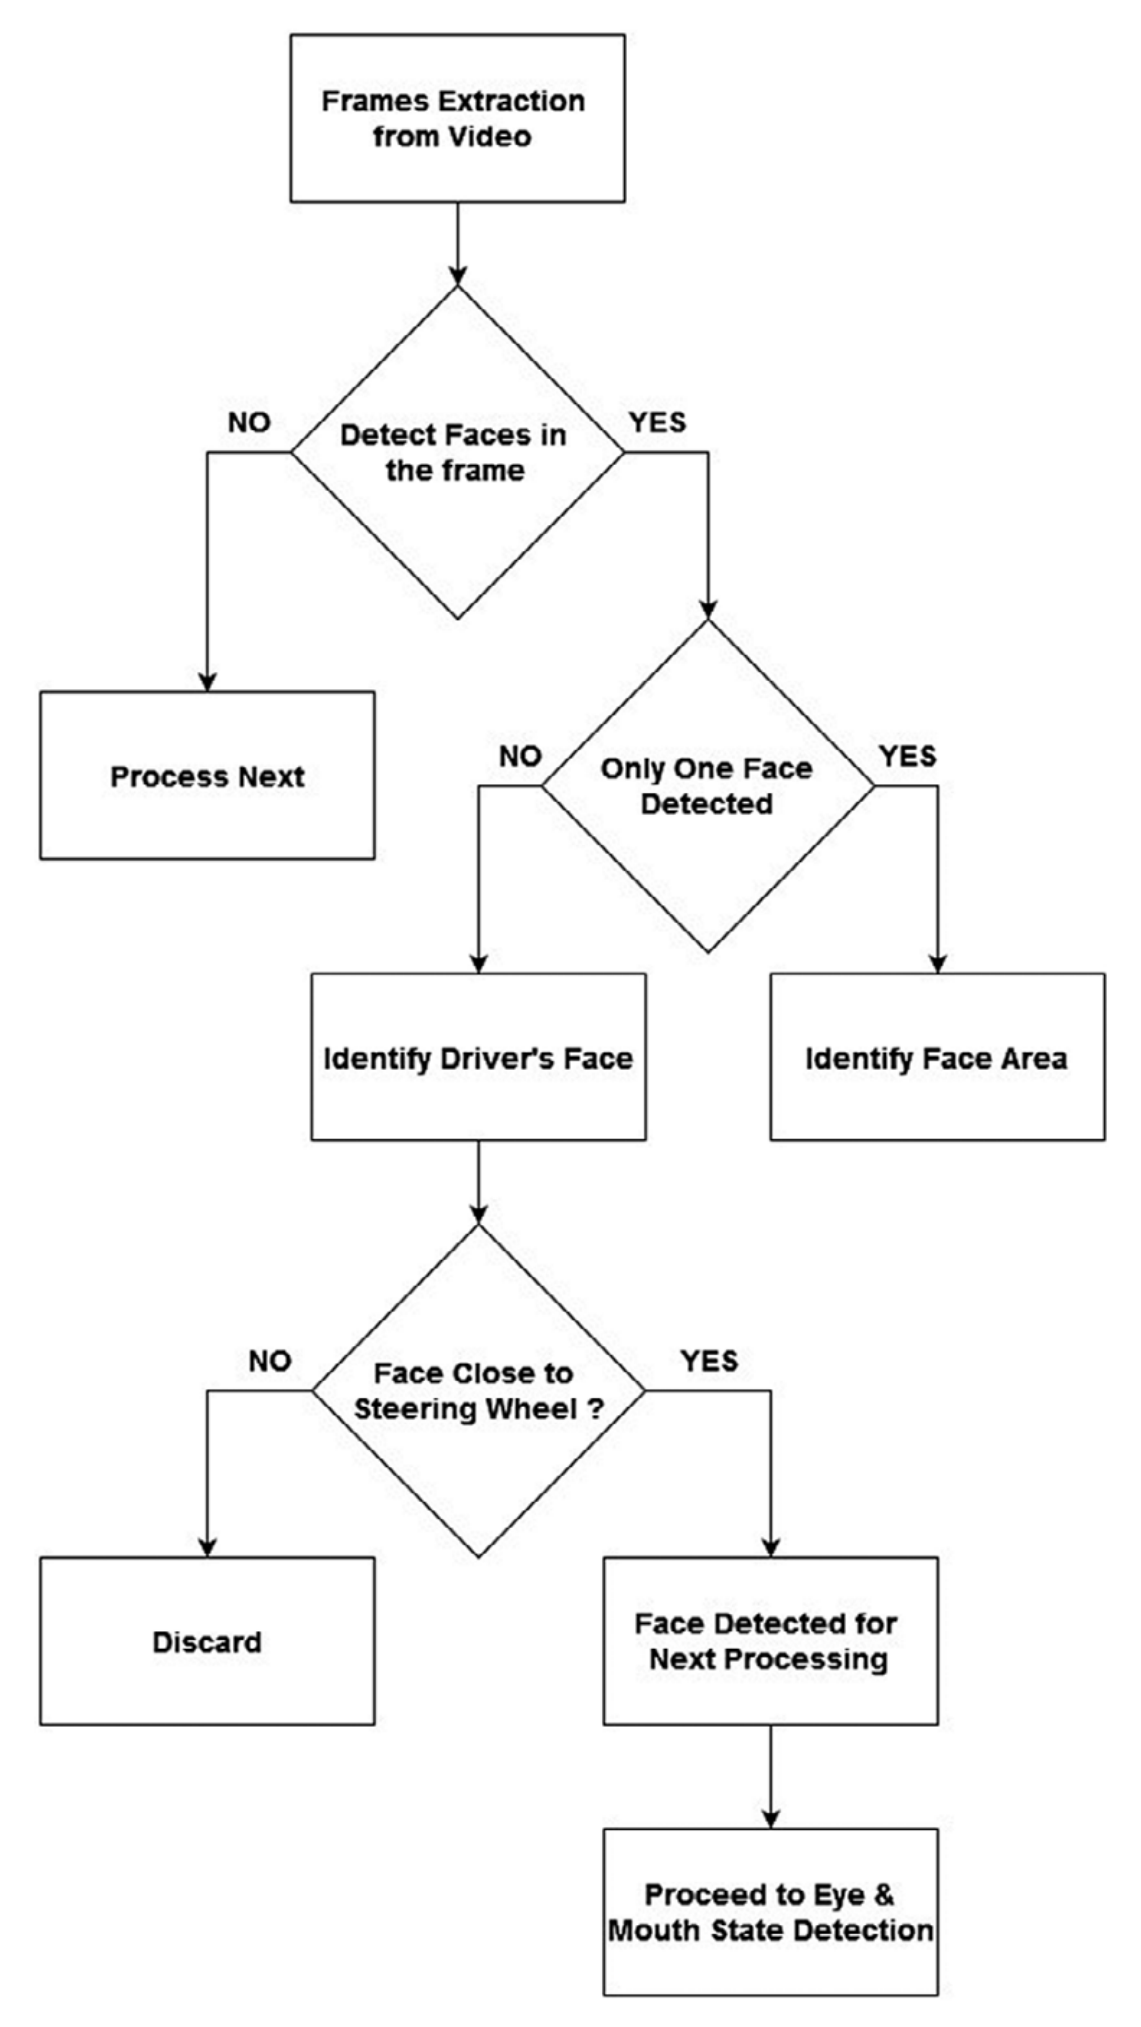
人脸检测是一种旨在增强数字图像中人脸可辨识特征的计算技术,服务于多种应用。该技术处理输入图像,确定人脸结构的空间排布与尺寸,同时排除非面部物体。现有人脸检测算法与方法众多,差异主要在于检测速度、精度与预期用途。这些算法普遍擅长检测正对镜头且光照充分的人脸图像,生成紧密对应的一组图像坐标以定位人脸。所提出的应用假设:输入图像是在车内相机视野中检测代表驾驶员的单一人脸。
人脸检测过程包含归一化,期间定位瞳孔与嘴部以供检测。这一做法缩小感兴趣区域,确保眼部与嘴部检测机制在成功检测到人脸的前提下运行。因此,若未检测到目标人脸,眼部与嘴部检测过程保持不激活。
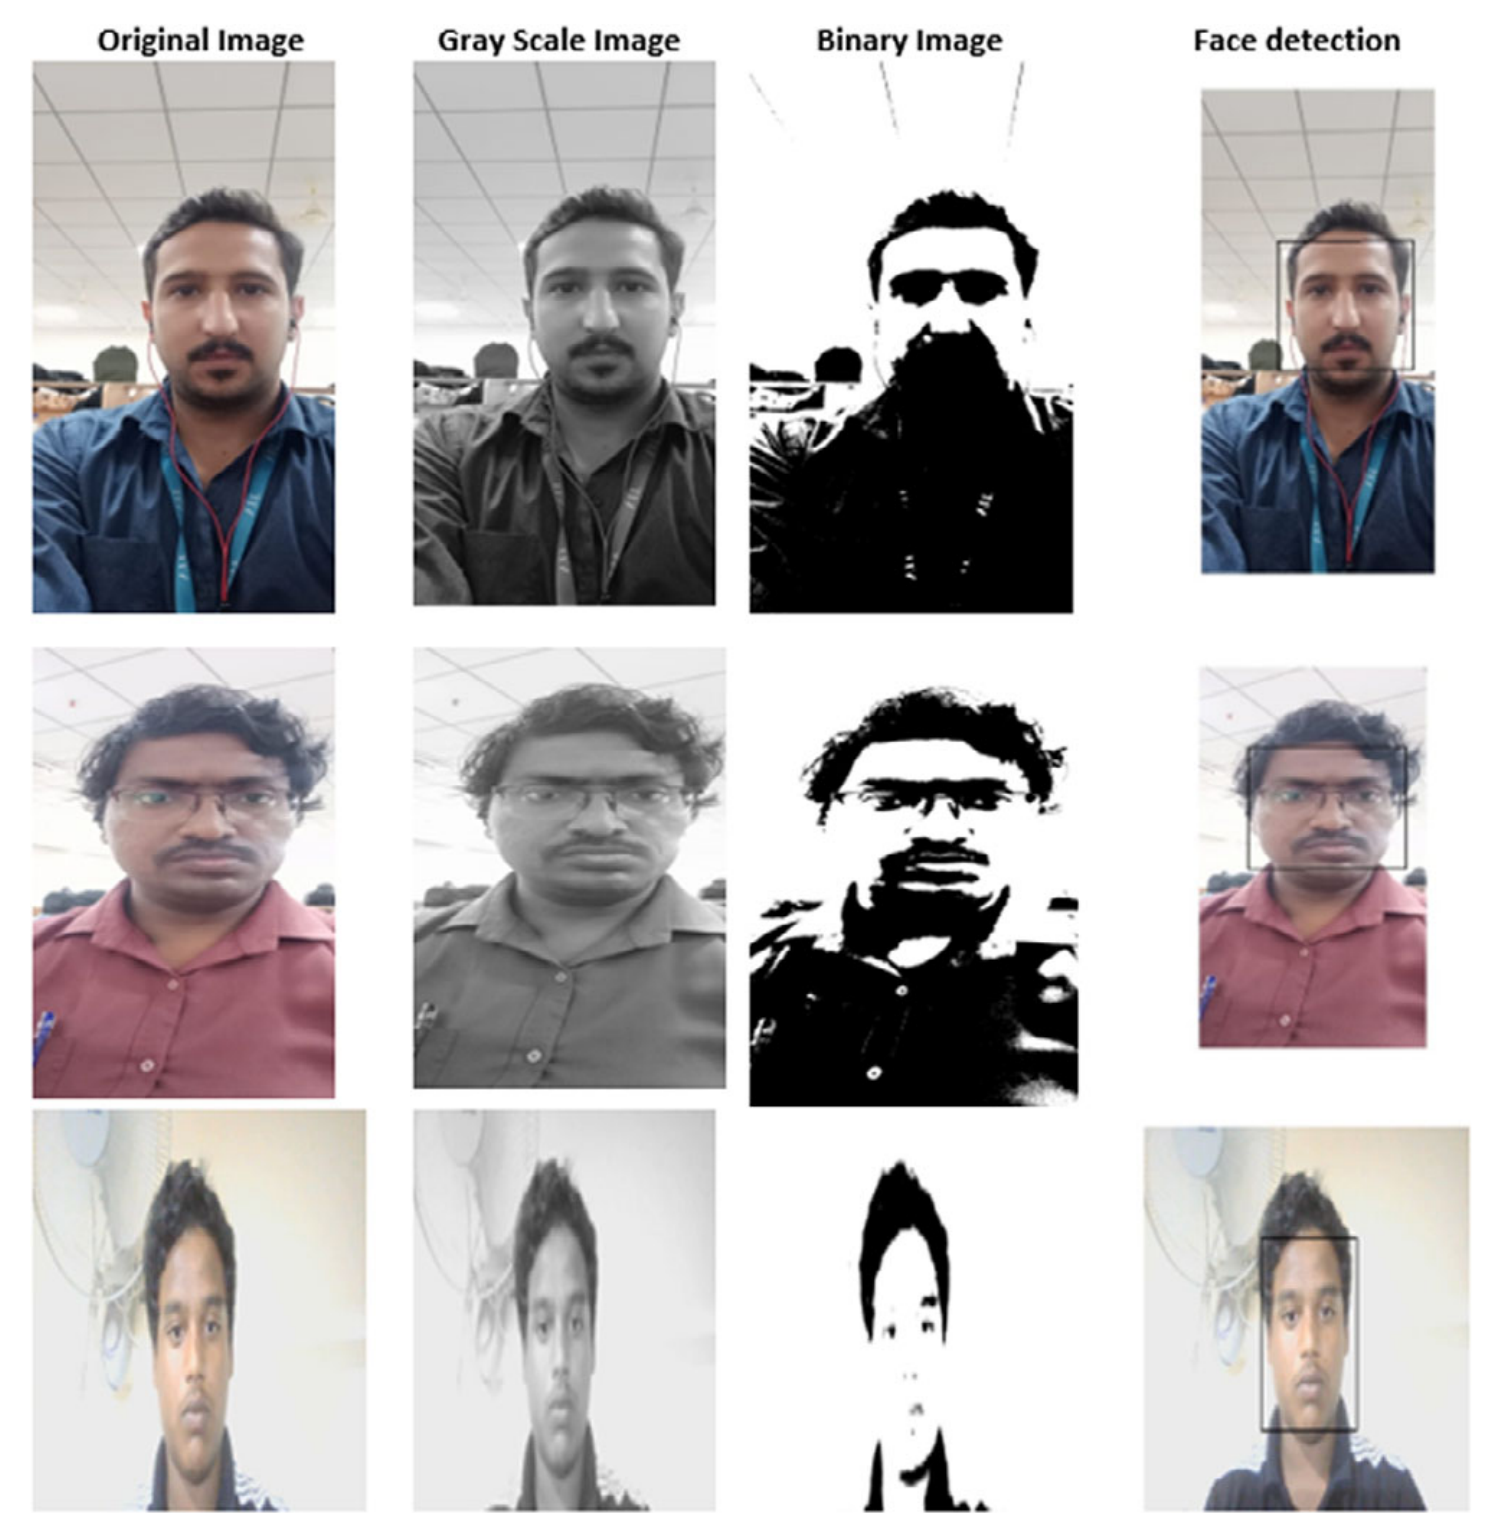
Viola-Jones 算法包含四个不同步骤,用于识别图像中的面部物体。本研究将其应用扩展到检测描述车辆驾驶员的视频帧中的特定面部特征。这种动态方法不同于传统的静态图像输入场景,如图 2 所示。实现这一改进技术——提取驾驶员图像并随后转换为二值表示——得到图 3 所示结果。该伪代码执行面向瞌睡评估的多特征融合建模,考虑 EAR、MAR 与疲劳指标,概述了使用关键点特征进行瞌睡检测的算法步骤。
第一步是应用 Haar 特征方法,包括对目标人脸的初始扫描。它包含表示成对矩形的标量值,矩形可以水平或垂直取向。扫描在给定像素分辨率的输入图像内进行,可容纳总数高达 160,000 个的矩形特征。值得注意的是,这一过程尤其适用于眼睛与嘴部位置等感兴趣区域。由此得到的特征随后作为后续计算的输入。I 表示图像,p 表示模式,N × N 表示尺寸,I(i, j) 为坐标 (i, j) 处的像素强度,p(i, j) 为二值模式函数,指示该像素属于 Haar 类特征中的白色区域还是黑色区域。
第二步是计算积分图像,这是判断图像是否包含目标人脸的关键技术。该计算借助累积分布函数完成,显著降低计算负荷。这一方法可以高效评估图像中是否存在所需的面部特征。II(i, j) 是像素 (i, j) 处的积分图像值,存储左上区域所有像素值之和;I(s, t) 是位置 (s, t) 处的原始像素强度。
译注:原文式 (3) 的排版疑似缺失负号,且未给出第四项;按积分图像的标准矩形求和公式,完整形式应为 II(N₂,N₄) − II(N₁−1,N₄) − II(N₂,N₃−1) + II(N₁−1,N₃−1)。译文保留原文写法,读者复现时请按标准公式实现。
N₁、N₂、N₃、N₄ 是积分图像中一个矩形区域的边界。II(x, y) 是不同位置处的积分图像值,用于高效计算区域和。
接下来,AdaBoost 算法提取有用特征,并将其与权重结合,判断子窗口包含人脸 (1) 还是不包含 (−1),其中 (X, Y) 是以概率 p 取到的训练样本,权重 wi(1),1 ≤ i ≤ n,ht = 决策桩。随着经验损失随 T 增大趋于零,假阳性率 P(fT(X) ≠ 1‖ Y = −1) 与假阴性率 P(fT(X) ≠ 1‖ Y = 1) 亦趋于零。wi 是分配给训练样本 i 的权重;yi 是样本 i 的真实类别标签;ht(xi) 是第 t 次迭代的决策桩函数;∝t(αt) 是分配给弱分类器 ht 的权重;P(fT(X) ≠ Y) 是误分类概率。
最后一步使用级联方法提升特征集的计算效率。该方法将特征分布到不同阶段与子窗口中,每 10 个特征分配给一个阶段及其对应的子窗口。每个子窗口通过级联机制基于其关联特征进行评估。分类器在评估过程中检验每个子窗口的属性:若子窗口被标记为正,则存在人脸;若标记为负,则不存在人脸,此类子窗口立即被拒绝。这一技术通过尽早、高效地排除与人脸无关的子窗口,使人脸检测最大化。式 (5) 给出级联决策规则,这是推导经验损失、引导决策的关键组件。
fTPP,sP(X) 是第 P 阶段阈值为 TP 时分类器的决策函数。X 是输入特征向量。利用卡尔曼滤波器,可以通过运动物体的历史值在下一时间帧准确估计其位置,因其承担人脸跟踪任务。借助递归自适应滤波器,它可以在给定一系列不确定测量的情况下预测动态系统的状态。此外,卡尔曼滤波器降低了位置误差,并预测物体的动态变化率。其中 x 表示目标位置,x₀ 是初始位置,v₀ 是初始速度,a 表示目标加速度,Δ 是时间间隔(本例中为 3 秒);下式用于跟踪与预测人脸位置:
人脸跟踪方法中还根据人脸的位置、速度与位置误差使用粒子滤波。但该技术在背景光过强或受试者头部移动过快时不起作用。
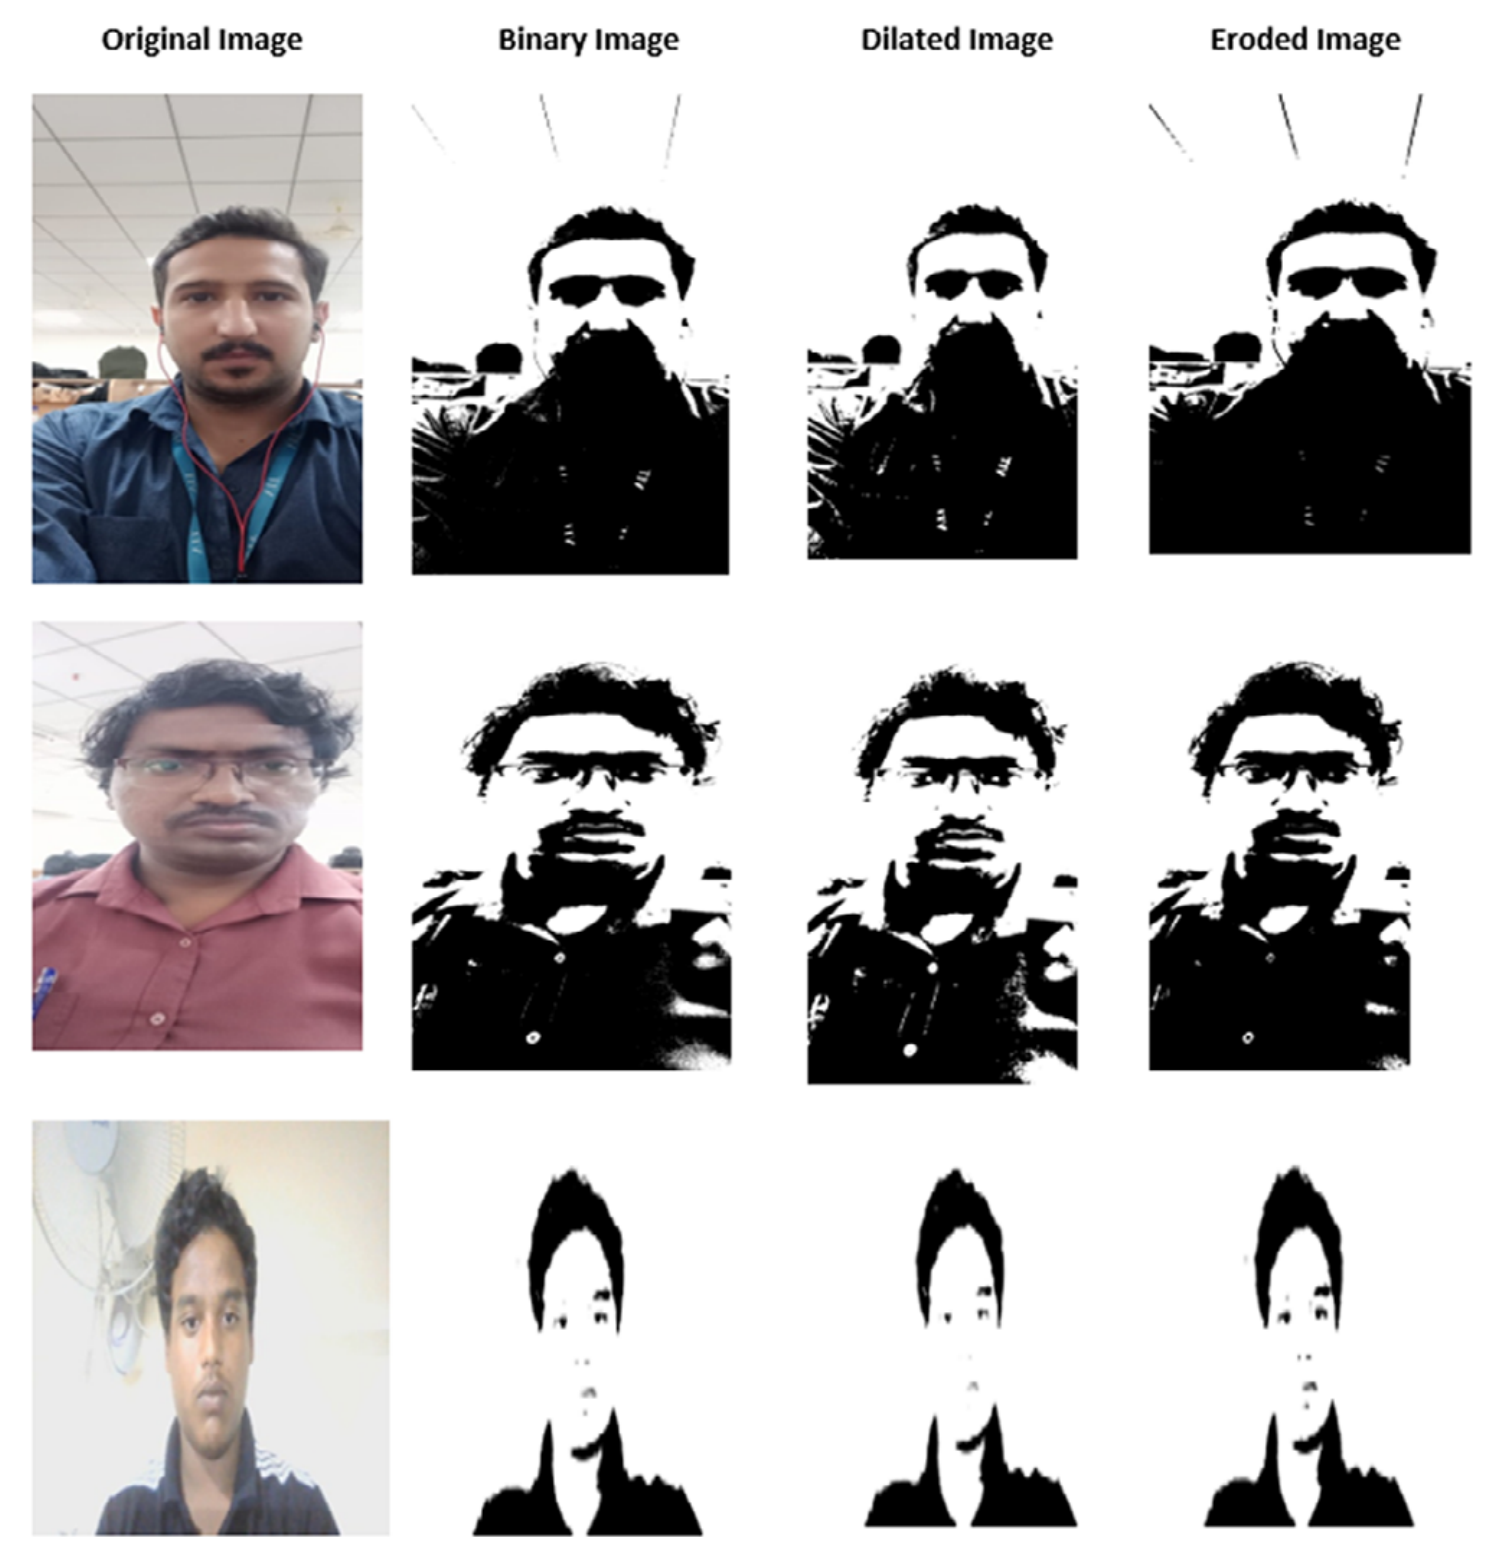
驾驶员的虹膜可能是其疲劳的有用指标。跟踪眼睑与眼部运动有助于确定虹膜尺寸,进而评估眼睛状态。识别驾驶员面部后,系统使用自适应阈值裁剪图像,然后通过分割面部上部找到眼睛。形态学运算通过基于空间关系修改像素值来增强图像处理。系统使用指定的扁平结构元素辅助准确的形态学操作,帮助消除伪像素。后续步骤包括眼部区域处理,包括阈值处理与旋转检测,并结合卡尔曼滤波。然而,光照导致虹膜亮度低、头部或相机移动时会出现挑战。考虑到眼睛尺寸各异,系统从假定的清醒状态开始,计算一个阈值并与视频帧中的当前眼部比例比较。突然移动或分辨率变化会给虹膜位置准确预测带来障碍。图 4 与图 5 展示了从输入图像进行的处理与眼睛检测。
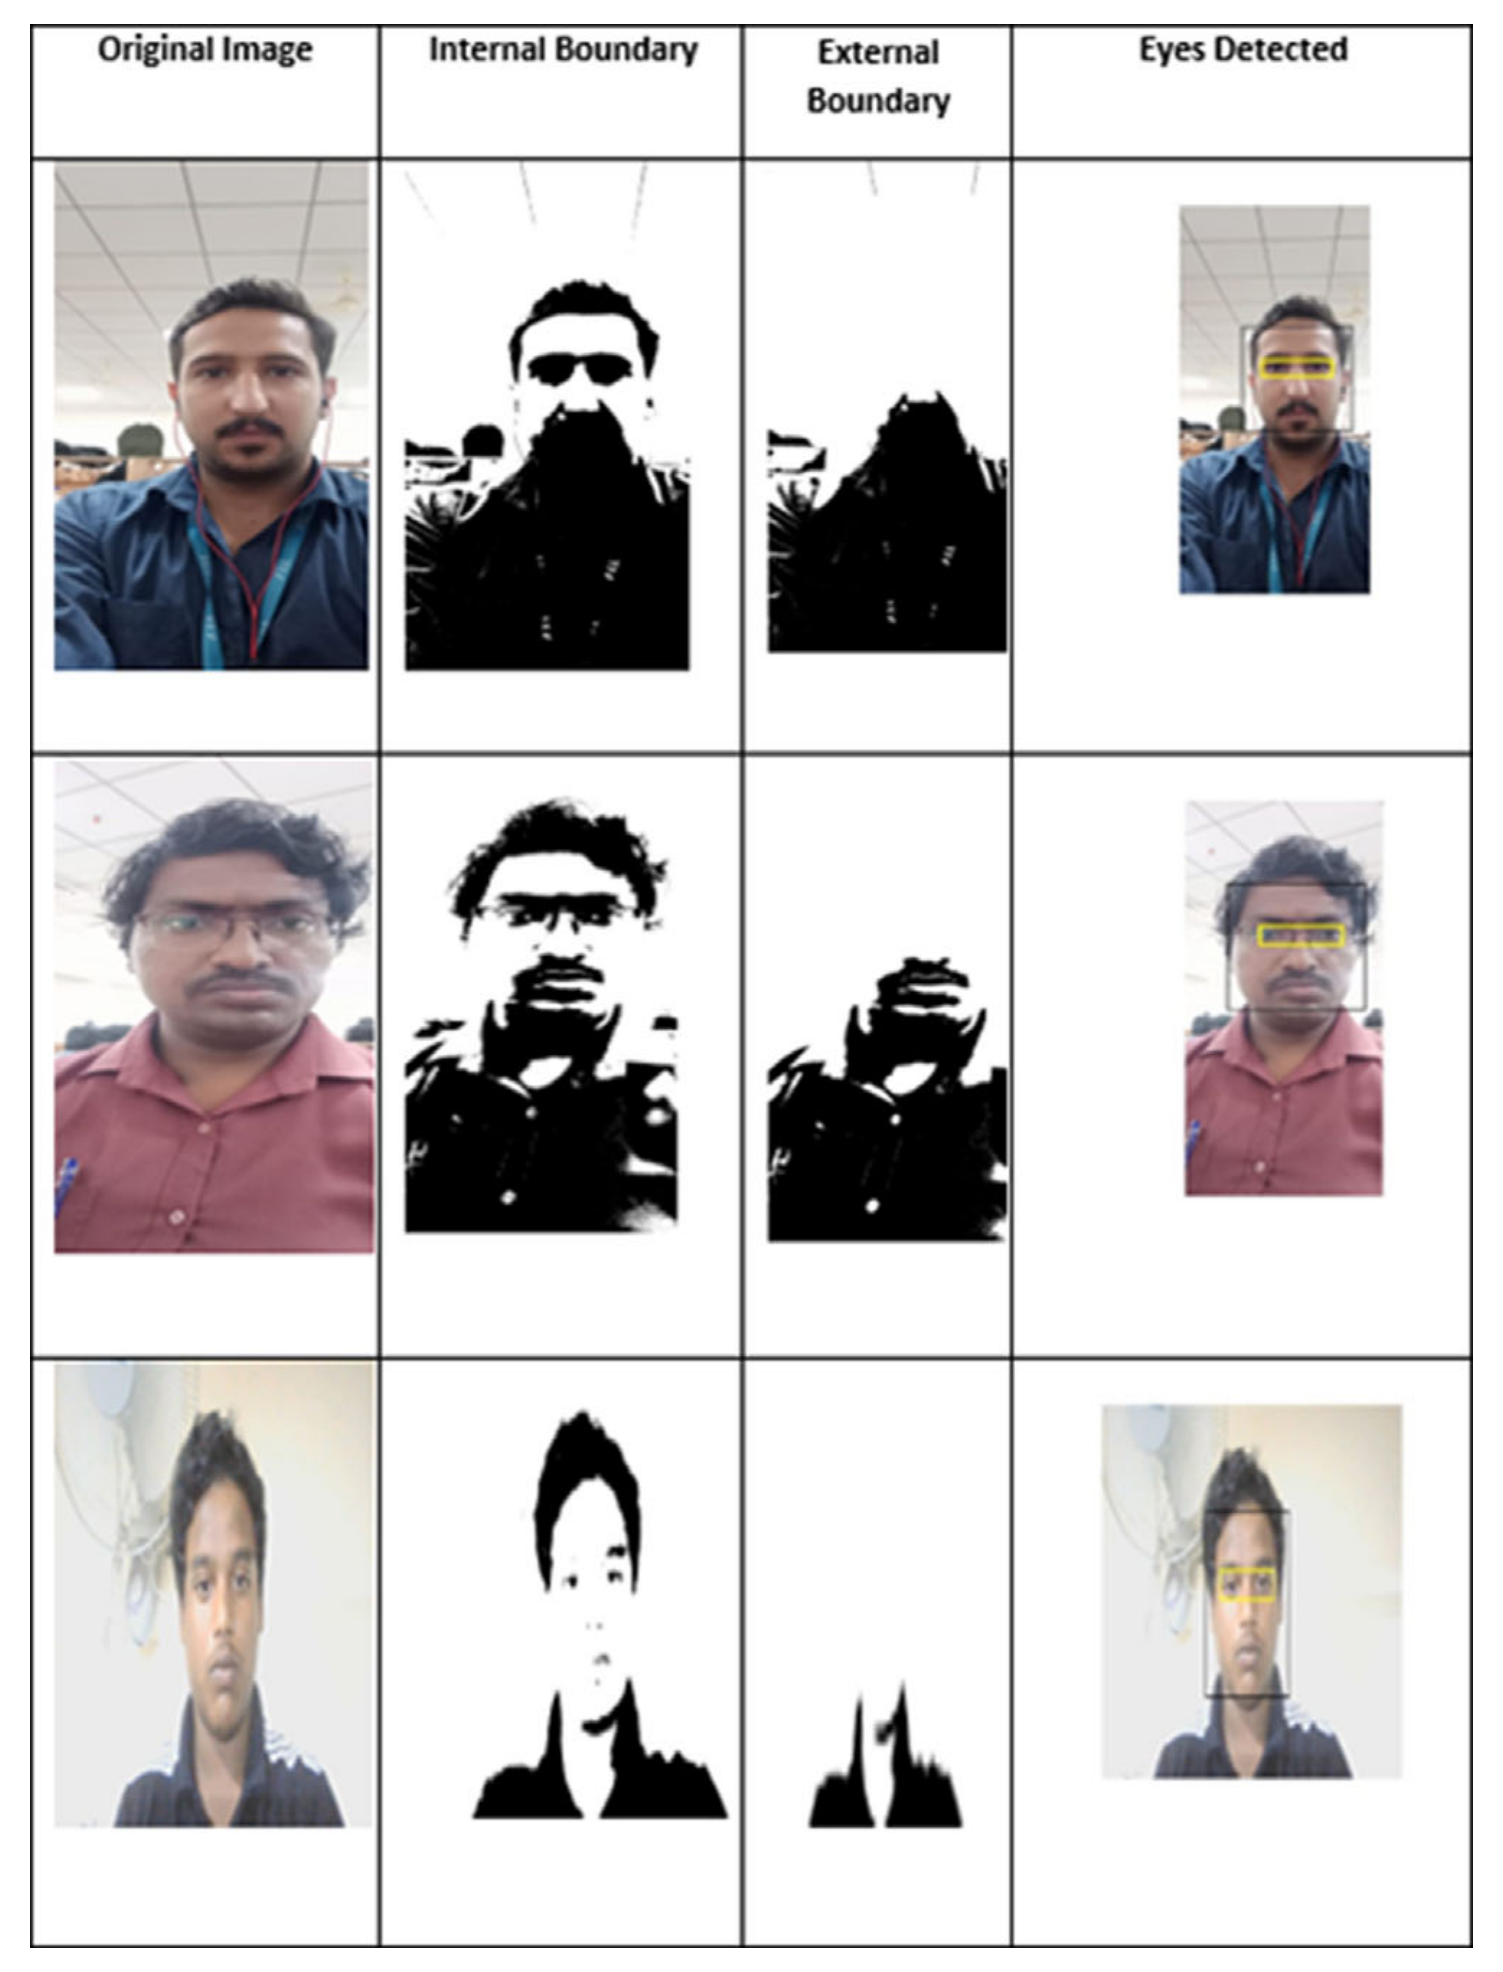
系统通过面部与眼部运动判断驾驶员状态的一个明显症状是哈欠,它通常是疲惫与瞌睡的标志。预处理从裁剪嘴部区域帧开始,以评估驾驶员状态。鉴于嘴部位于面部下方,嘴部检测器直接提取该区域。后续验证依靠眼距确保嘴部分段检测的准确性,通过综合考虑嘴部与眼睛边界实现。系统采用连通物体计算进行嘴部检测:在张嘴场景中将上唇与下唇识别为分离物体,闭嘴时识别为单一物体。检测失败则记为零值。随后采集的数据经过模糊逻辑技术处理,以确定疲劳等级。
在检测并跟踪嘴部、眼睛等面部属性后,系统分析其状态。该分析确立两个输入参数:黑色像素区域的总数,以及黑色像素相对白色像素的比例。这些参数作为可量化的指标,评估嘴部与眼睛的状况。
要确定二值图像中白色像素的数量,对二值图像的像素值求和即可。黑色像素数量则可用二值图像像素总数减去白色像素数量得到。黑色像素与白色像素之比由黑像素数除以白像素数得出。系统采用基于规则的方法判定眼部与嘴部状态。系统从眼部状态开始,将检测框与指定阈值比较,计算准确的眼部尺寸比例。随后评估左眼像素比例是否超过预定阈值,据此将眼睛状态分类为「睁开」或「未睁开」。
面部关键点识别旨在获取眉毛、眼睛、嘴唇与鼻子位置的关键信息。EAR 与 MAR 是此类系统中常用于准确检测瞌睡的关键面部特征。
EAR 是衡量眼睛状态的常用指标。它给出眼睛纵横比的量化度量:睁眼时该值相对恒定,闭眼时快速变化。本研究选取眼睛周围的关键特征点计算 EAR,如图 6(a) 所示。
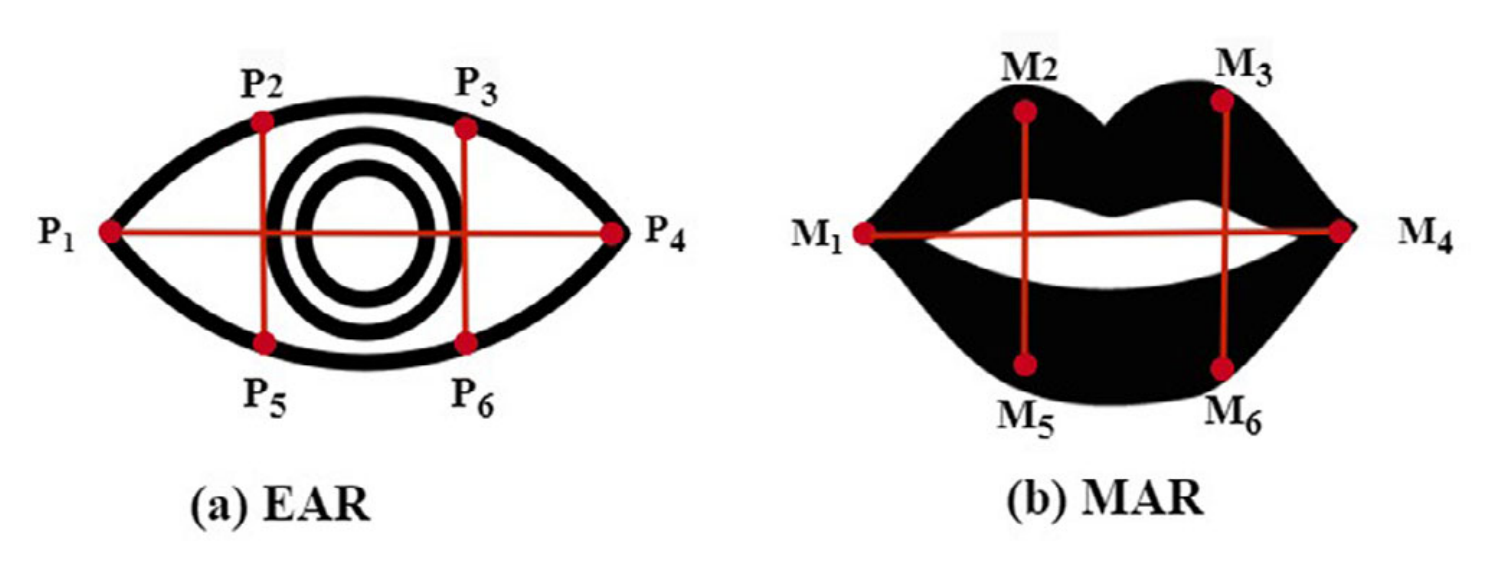
为应对所选标志点可能的不准确性,研究采用了一种增强方法,将关键点坐标与图像处理技术相结合。首先获取特征点 P2、P3、P5 与 P6 的坐标;用这些点构成一个外接矩形,再将矩形高度向上、向下各扩展 50% 加以调整;随后在该调整后的矩形内截取图像,确保尺寸合适,并保持眼部与非眼部特征之间显著的差异,便于检测眼部特征变化。
采集的图像经过若干预处理步骤以提升准确性,包括转为灰度、滤波与去噪。方法包括校正眼睛倾角并进行水平对齐,以确保准确对齐。眼睛倾角由特征点与直线确定,进而实现图像内眼睛的水平对齐。M 是求和所得的最大值;H 是眼睛高度,且 H = M/255。特征位置 P1 与 P4 之间的线性距离即为眼宽(W)。随后用眼高(H)除以眼宽(W)计算 EAR,即 EAR = H/W。研究组装了一个由 800 张图像组成的测试数据集来评估该增强方法的效果,每批照片包含 400 张睁眼与 400 张闭眼图像,并对图像统一缩放至 400 × 300 像素。
本研究基于三个关键指标开发疲劳评估模型:最长连续闭眼时长、哈欠频率与 PERCLOS。这些指标基于由 EAR 与 MAR 判定的眼部与嘴部状态分析推导。所选指标的取值可借助 EAR 与 MAR 度量计算得到。这些指标是训练相应模型以准确评估疲劳等级的有价值特征。最长连续闭眼时长指眼睑持续闭合的时间段,指示瞌睡或疲劳;哈欠次数直接度量哈欠行为,常出现在疲劳状态;PERCLOS 是量化给定时间段内眼睛闭合时间百分比的指标,提供与疲劳相关的眼睛闭合的综合性度量。使用 EAR 与 MAR 可以确定并计算这些疲劳指标,促进鲁棒疲劳评估模型的开发。
闭眼时长随疲劳严重程度增加而增加。为量化该时长,采用的计算方法结合了 EAR 与预定阈值 0.21。通过识别眼睛闭合的连续帧(记为 FT),可确定连续闭眼时长。该计算方法配合对逐帧 EAR 值的连续监测,能够精确测量持续闭眼时长,为驾驶员疲劳等级提供有价值的洞察。
式中 Nstart 表示视频中眼睛开始闭合的帧号,Nend 表示眼睛由闭转开的帧号,T₀ 为每帧图像的时间间隔。
PERCLOS(单位时间内眼睑对瞳孔的闭合百分比)是量化眼睑覆盖瞳孔区域时间百分比的指标。它专门捕捉缓慢的眼睑闭合(常称「垂睑 droops」),而非快速眨眼。在车内瞌睡检测系统中,PERCLOS 已作为可靠的警觉性指标获得广泛认可。在其研究中,PERCLOS 被定义为:在一分钟时间区间内,眼睛闭合至少 80% 的时间百分比。该指标提供了眼睑闭合程度的有价值信息,被认为是评估瞌睡的有效度量。PERCLOS 的计算公式如下:
PERCLOS 值由若干时间区间决定:t₁ 与 t₂ 分别表示眼睛从最大闭合到 80% 闭合、以及从 80% 闭合到 20% 闭合的过渡时长;t₃ 表示眼睛从 20% 闭合过渡到 20% 睁开所需的时间;t₄ 表示眼睛在 20% 与 80% 闭合之间保持睁开状态的时长。在实际驾驶场景中,相机采集设备捕获的视频流被转换为帧图像以供进一步分析。PERCLOS 技术被更精确地定义为:单位时间内闭眼帧数与总帧数之比。
此处 Fp 为 PERCLOS 值。分子是该时段内闭眼的帧数,N 是单位时间内的视频帧数。
个体疲劳时常见哈欠行为增多。量化嘴部开合评估的常用指标包括 MAR 与张嘴频率(FOM)。这些指标可评估嘴部的运动幅度。
MAR 通过计算上下唇之间的垂直距离与嘴部水平宽度之比确定。MAR 值越高表示嘴张得越大,通常与哈欠和疲劳相关。同样,FOM 度量给定时间段内嘴张开的频率。FOM 升高表示张嘴频率增加,反映与疲劳相关的行为,包括打哈欠。嘴部特征点 M1–M6 如图 6(b) 所示,很可能用于跟踪与分析嘴部内的不同标志点或区域。面部标志点检测技术通常用于准确识别与监测这些特征点,便于精确测量嘴部运动。MAR 定义为:
特征点 M1–M6 对应嘴部区域附近所选标志点的精确坐标,用于基于关键点的方法计算 MAR。与评估 EAR 类似,研究为 MAR 设定了阈值。研究发现,当 MAR 达到 0.4 时,最大准确率约为 99.5%。因此选择 0.4 作为区分张嘴与闭嘴的阈值。利用该阈值,研究者可以基于计算的 MAR 准确评估与分类嘴部状态。该方法实现了对与疲劳和哈欠相关的嘴部运动的精确监测与分析。
在单次哈欠期间,嘴部会保持较大张开的幅度持续一段时间。可用阈值 0.4 判定嘴部是张开还是闭合。张嘴是一种常见面部表情,包括说话、哈欠与大笑。正常情况下哈欠通常持续约 6 秒。相比之下,说话或大笑只引起短暂的张嘴。张嘴的持续时间可作为识别哈欠事件的指标。哈欠时长的具体定义如下:
该方法中 Mstart 表示嘴部开始闭合的视频帧号,Mend 表示嘴部由持续闭合与张开状态转换的帧号,T₀ 为每帧时间间隔。借助这一方法,可以统计哈欠次数。
模糊逻辑通过界定隶属度函数有效处理模糊性,从而对模糊集中各成员的真实程度进行归类。在模糊规则的 IF-THEN 范式中,隶属度函数被用来以图形方式描绘模糊集。瞌睡是一种难以精确客观量化的模糊生理状态。因此,构建模糊模型为评估驾驶员行为并确定其疲劳程度提供了便捷途径。在此框架内,模糊推理系统包含三个关键阶段:
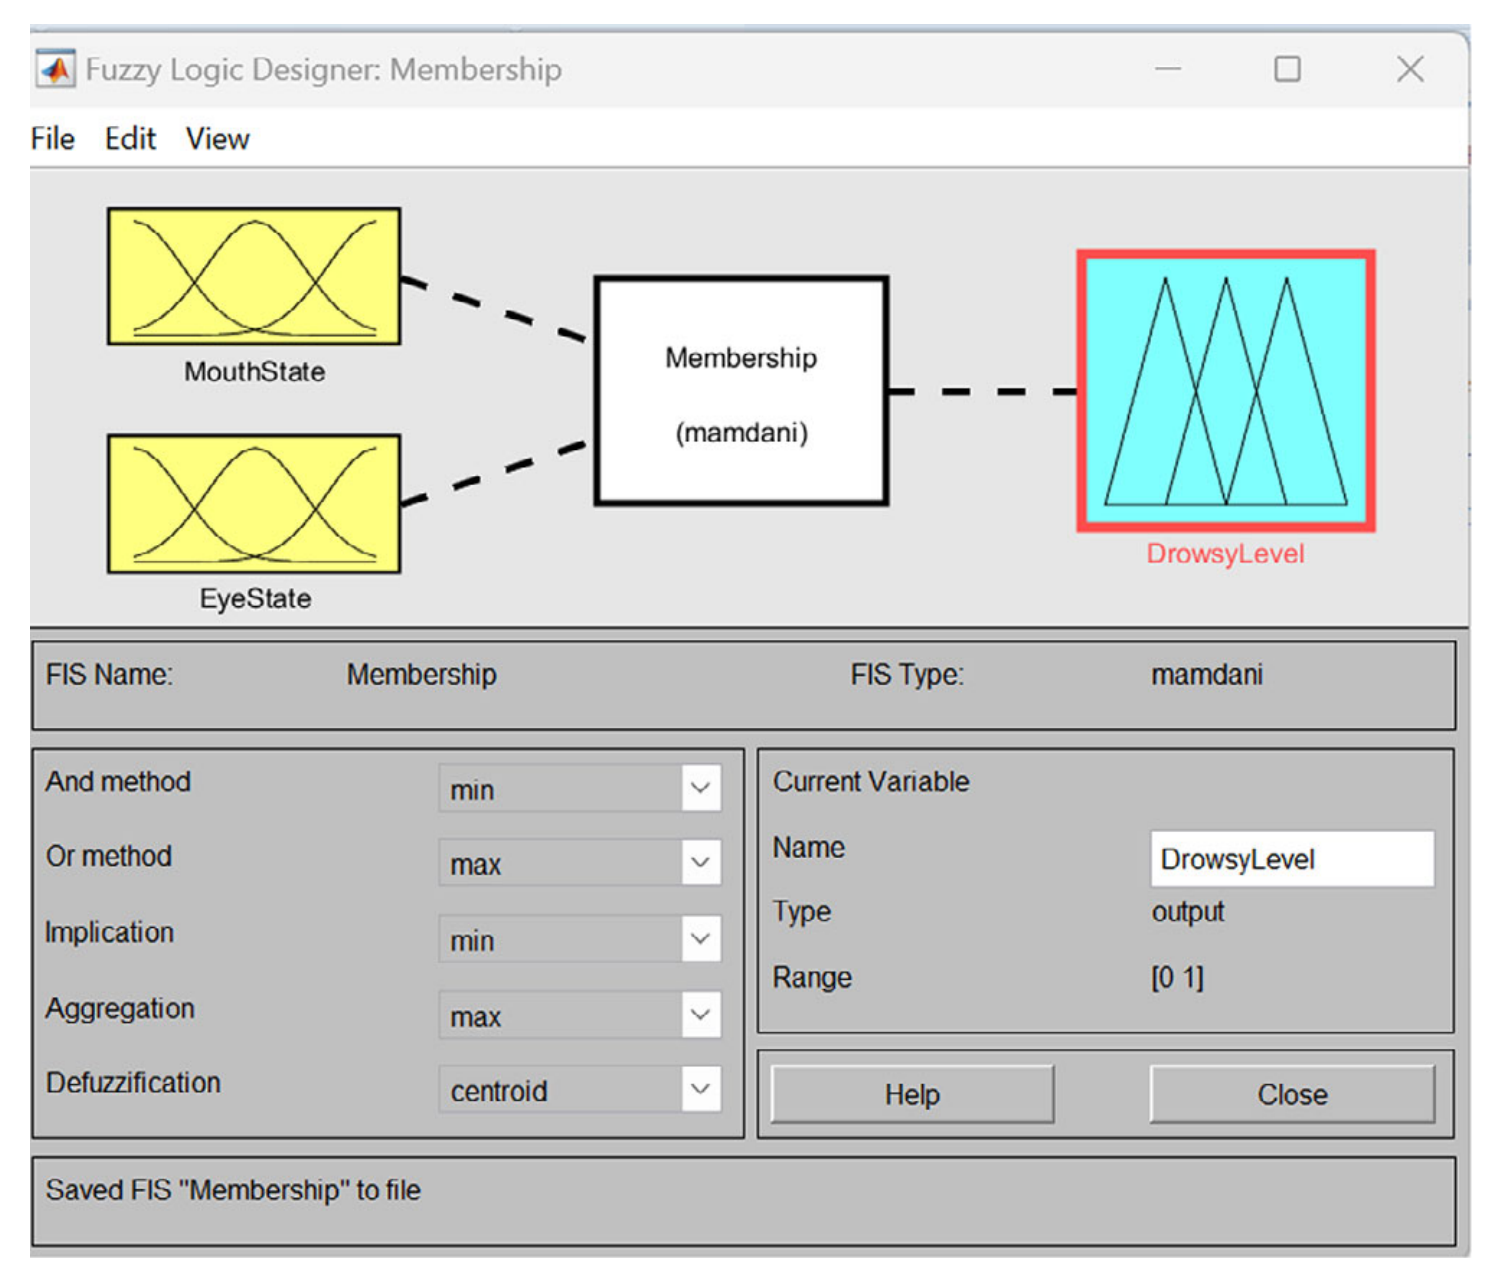
Step 1 模糊化(fuzzification):模糊化发生在模糊推理系统的测试阶段。在此阶段,眼睛状态与嘴部状态等清晰输入变量被转换为模糊值,然后用隶属度函数进行评估,以判断驾驶员的瞌睡等级。这一过程对分析数据与确定疲劳程度至关重要。研究建立了两个定义良好的清晰输入变量——眼睛状态与嘴部状态——以及一个表示瞌睡等级的输出变量,如图 7 所示。
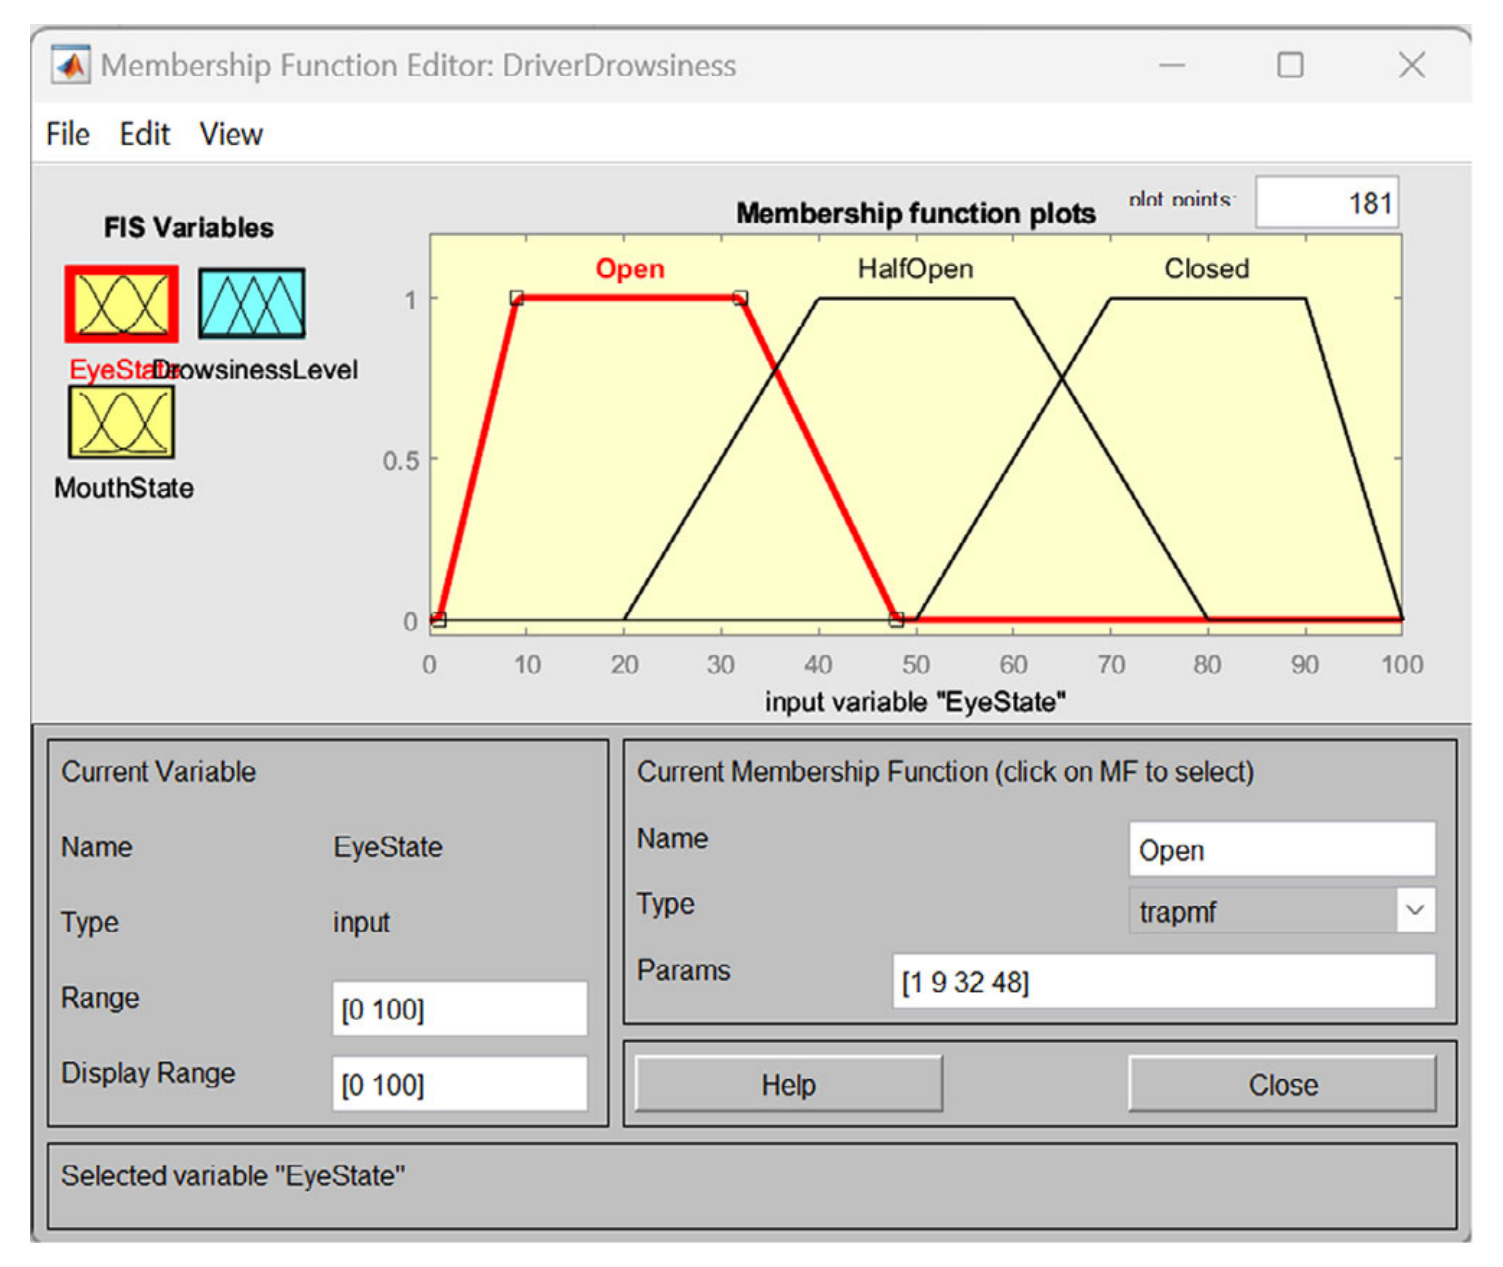
如表 1 所示,闭眼比例作为主要输入变量,在初始阶段描述眼部状况。以下记号含义为:S = Small(小),L1 = Low(低),M = Medium(中),L = Large(大),H = High(高)。
| 闭眼比例 | 100–75% | 74–34% | 33–0% |
|---|---|---|---|
| 黑色像素面积 | S | M | L1 |
| 瞌睡等级 | L | M | H |
类似地,可以按百分比描述嘴部状态的输入变量,分为张开(open)、半开(half open)与闭合(closed)三种状态。新的瞌睡分类体系包括低(Low)、中(Medium)与高(Excessive)三类。输入由眼睛的开—半开与开—闭值以及嘴唇的开—半开与开—闭值组成。研究选择梯形隶属度函数(Trapezoidal Membership Function),因为其在计算简洁性与不确定性的有效建模之间取得了高效平衡,这对驾驶员瞌睡检测至关重要。其线性结构便于快速处理,适合光照变化或驾驶员戴眼镜等动态条件。此外,梯形函数比二值或三角函数更准确地刻画从警觉到瞌睡的渐变过渡,允许在一个数值区间内具有部分隶属度。这种灵活性增强了系统对不同驾驶员与环境的适应性,提升了瞌睡检测模型的整体准确性。表 2 展示了输入与输出的语言变量及其相关术语。表中记号:IP = input(输入),OP = output(输出),O = open(睁开),HO = half open(半开),C = close(闭合)。此外,模糊逻辑将这些变量固有的模糊性封装起来,通过一组输入隶属度函数将其取值表现在 0 到 1 的范围内。模糊集中各元素被赋予的真实程度随后进行归类,如图 8 所示。
| 变量 | 类型 | 模糊集 | 隶属度函数 |
|---|---|---|---|
| Eye_state(眼睛状态) | IP | O, HO, C | Trapezoidal(梯形) |
| Mouth_state(嘴部状态) | IP | O, HO, C | Trapezoidal(梯形) |
| Drowsy_level(瞌睡等级) | OP | L, M, H | Trapezoidal(梯形) |
Step 2 推理系统(inference system):初始阶段利用模糊推理系统的规则编辑器组件创建并评估「if-then」规则。这发生在分析视频帧序列时,系统检查眼睛与嘴部的张开或闭合程度。随后,系统利用 Eye state 与 Mouth state 两个变量的知识库规则驱动(FIS)。这种结合使系统能将驾驶员状态分为三类:低、中或高瞌睡。该方法依赖基于眼睛开闭比例与阈值提出的模糊规则。表 3 说明了知识库如何以「IF-THEN」逻辑表达规则集合。
| 规则编号 | 规则 |
|---|---|
| Rule 1 | If (eyestate is open) and (mouthstate is open) then (drowsiness level is low) |
| Rule 2 | If (eyestate is closed) and (mouthstate is closed) then (drowsiness level is high) |
| Rule 3 | If (eyestate is halfopen) and (mouthstate is halfopen) then (drowsiness level is medium) |
| Rule 4 | If (eyestate is open) and (mouthstate is halfopen) then (drowsiness level is low) |
| Rule 5 | If (eyestate is closed) and (mouthstate is open) then (drowsiness level is high) |
| Rule 6 | If (eyestate is closed) and (mouthstate is halfopen) then (drowsiness level is high) |
| Rule 7 | If (eyestate is halfopen) and (mouthstate is open) then (drowsiness level is high) |
| Rule 8 | If (eyestate is open) and (mouthstate is closed) then (drowsiness level is medium) |
| Rule 9 | If (eyestate is open) and (mouthstate is halfopen), then (drowsiness level is low) |
| Rule 10 | If (eyestate is halfopen) and (mouthstate is closed) then (drowsiness level is medium) |
| Rule 11 | If (eyestate is halfopen) and (mouthstate is open), then (drowsiness level is medium) |
| Rule 12 | If (eyestate is halfopen) and (mouthstate is halfopen), then (drowsiness level is high) |
| Rule 13 | If (eyestate is closed) and (mouthstate is halfopen) then (drowsiness level is medium) |
| Rule 14 | If (eyestate is open) and (mouthstate is closed) then (drowsiness level is medium) |
| Rule 15 | If (eyestate is halfopen) and (mouthstate is halfopen), then (drowsiness level is high) |
| Rule 16 | If (eyestate is closed) and (mouthstate is halfopen) then (drowsiness level is high) |
| Rule 17 | If (eyestate is closed) and (mouthstate is open) then (drowsiness level is high) |
| Rule 18 | If (eyestate is halfopen) and (mouthstate is open), then (drowsiness level is medium) |
译注:表 3 原文如此。同一前件出现多条输出矛盾的规则:Rule 3 与 Rule 12(均为 halfopen+halfopen)分别输出 medium 与 high;Rule 7 与 Rule 11/18(均为 halfopen+open)分别输出 high 与 medium;Rule 6 与 Rule 13(均为 closed+halfopen)分别输出 high 与 medium。两输入三状态组合共 9 种,规则表却有 18 条且含冲突项,复现时需自行消解冲突,不能照抄。
Step 3 去模糊化(de-fuzzification):该步骤使用输出隶属度函数将模糊输入转换为清晰值,从而确定瞌睡等级。完整的模糊推理过程可通过 MATLAB 的规则观察窗(rule viewer)整体可视化。该观察窗还渲染隶属度函数图,它们共同影响最终输出。图 9 所示的规则观察窗是一个矩阵,含 18 行规则与三列输入输出变量。前两列(黄色底纹)可观察两个输入变量的隶属度函数;第三列可观察输出隶属度函数。整个模糊推理系统如图 10 所示,呈现为三维曲面观察窗(surface viewer)。
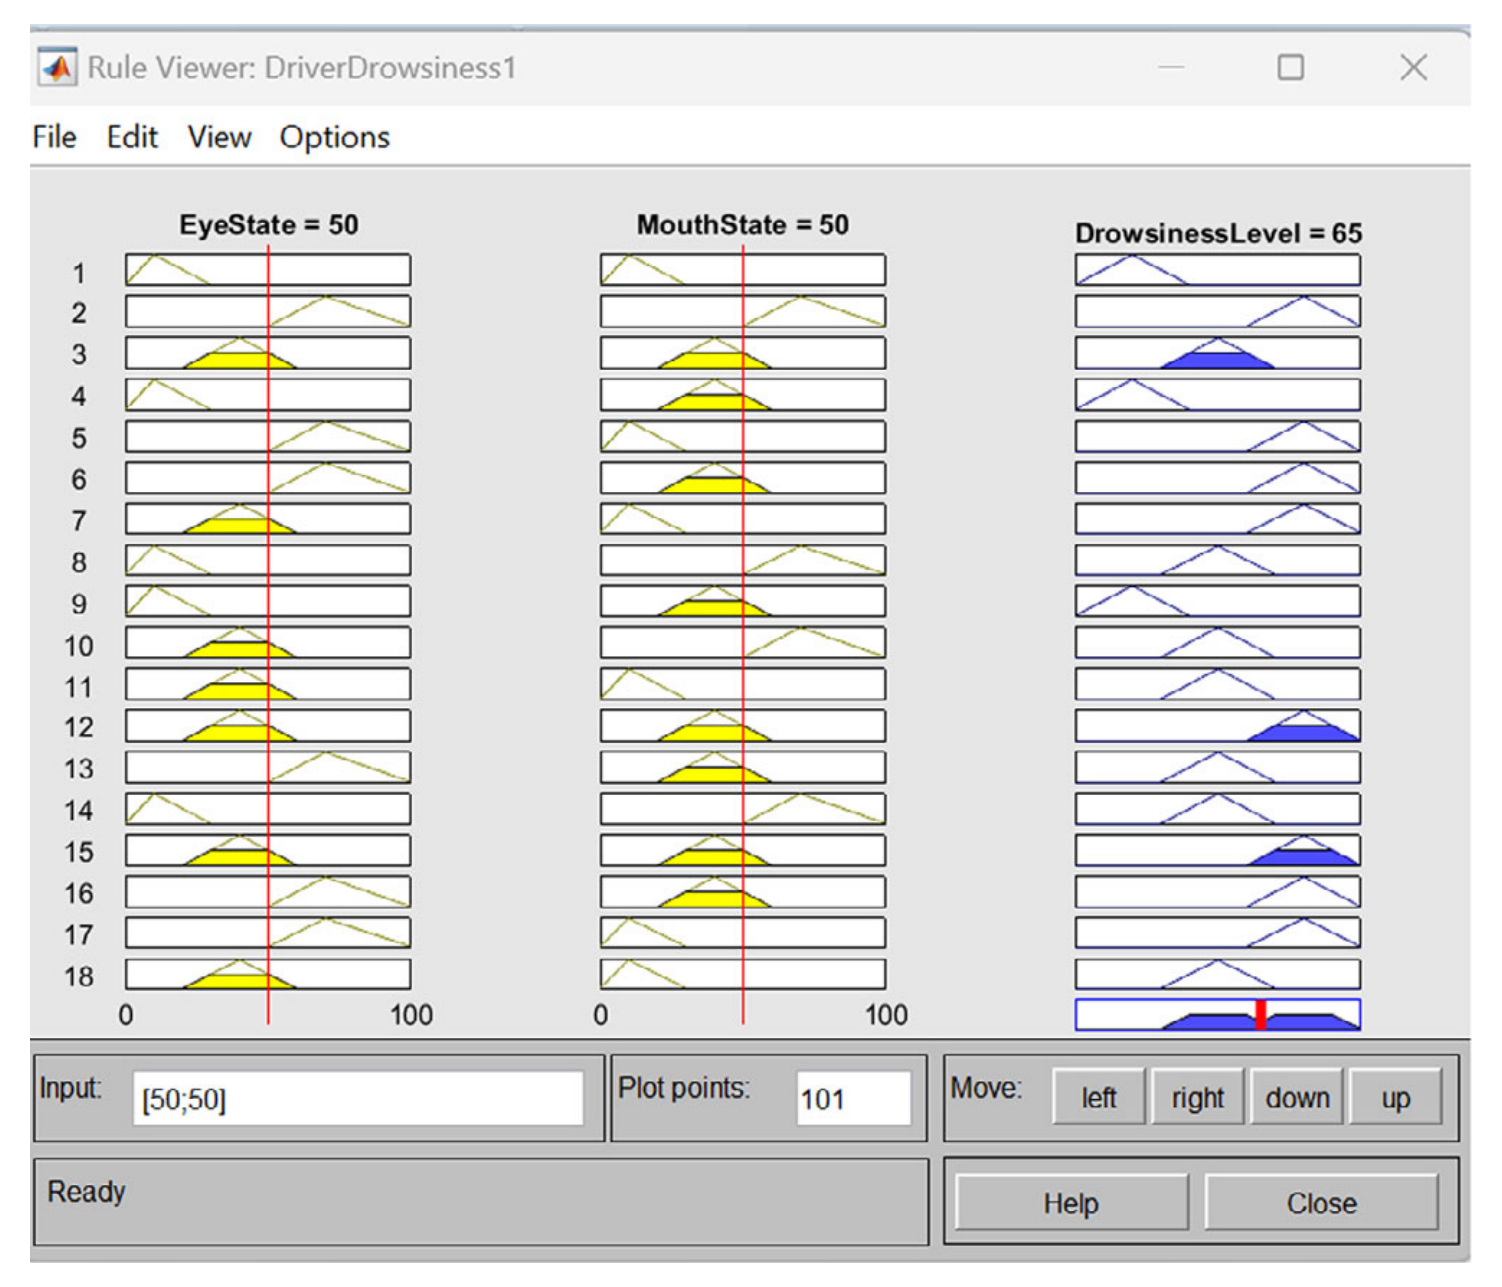
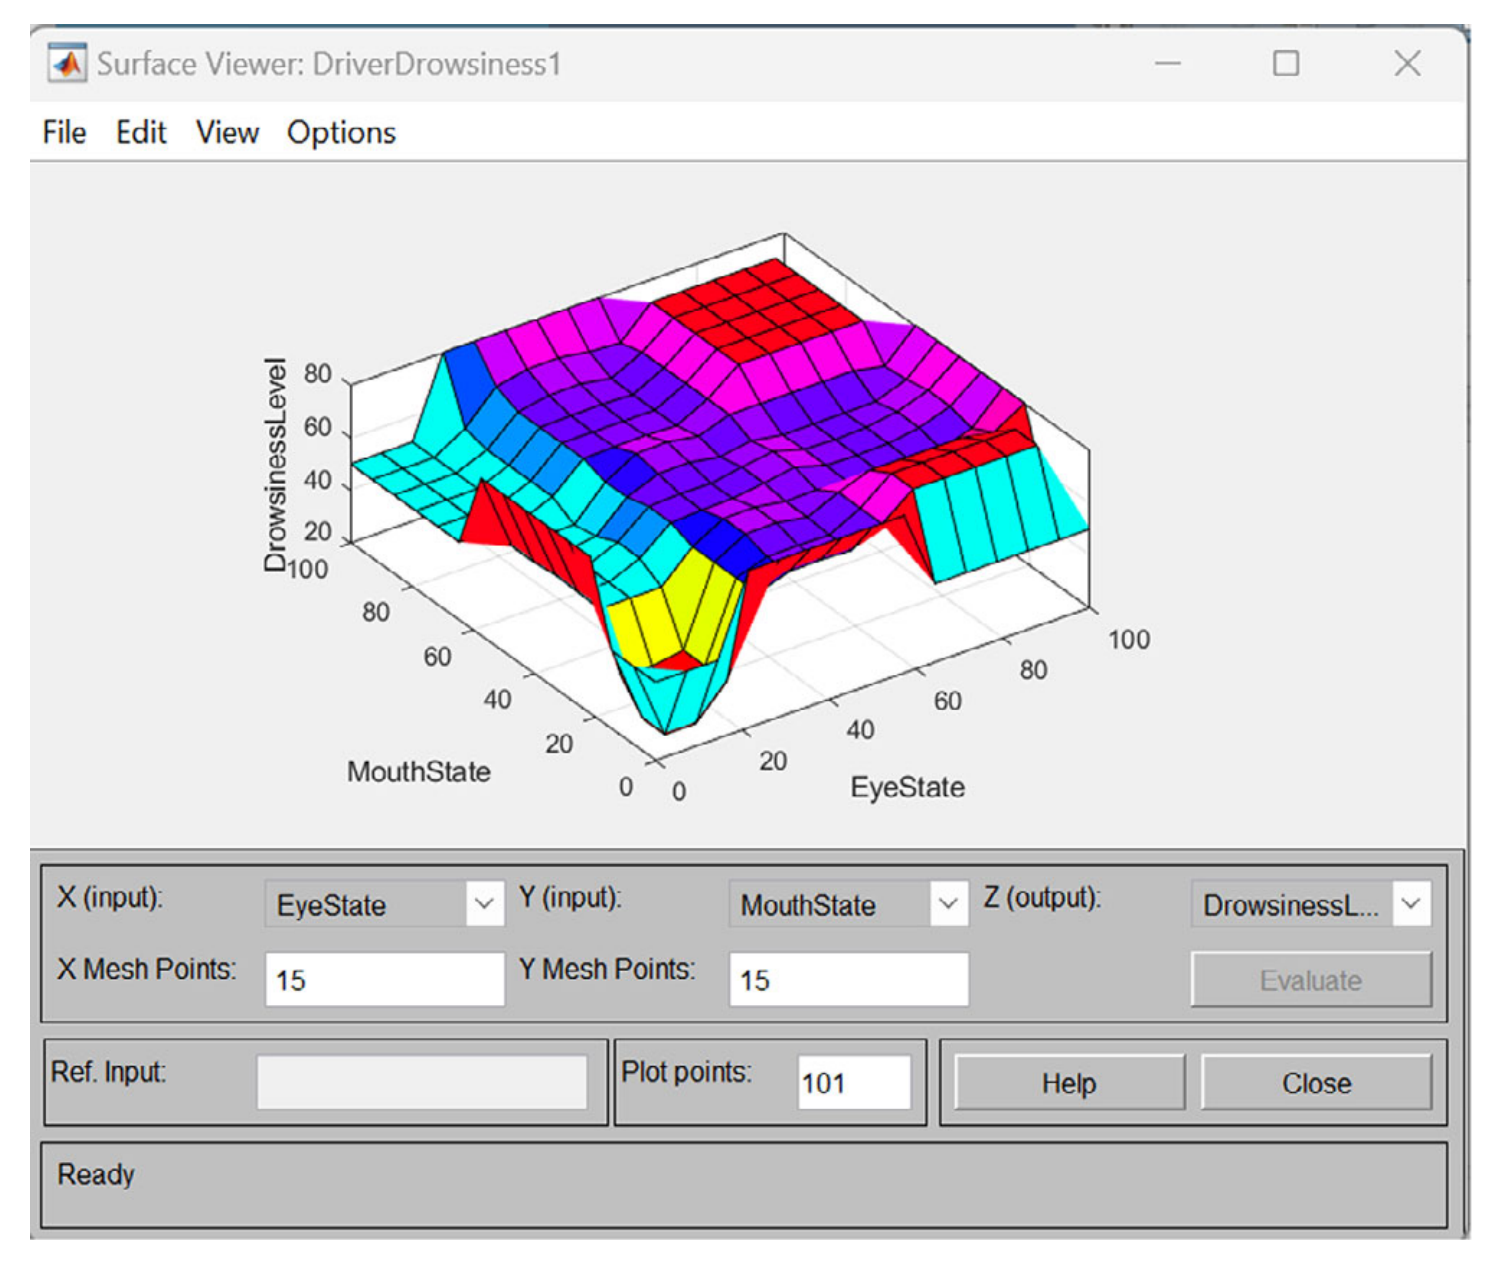
此处 X 表示眼睛状态,Y 表示嘴部状态,Z 表示瞌睡等级。该可视化确保即使在复杂情形下计算时间也可控。此外,为匹配模糊模块设计,IF-THEN 规则用九种颜色符号的调色板表示。举例而言,当眼睛状态记录 0.3 度的闭合、嘴部状态记录 0.9 度的张开时,将产生高等级瞌睡。
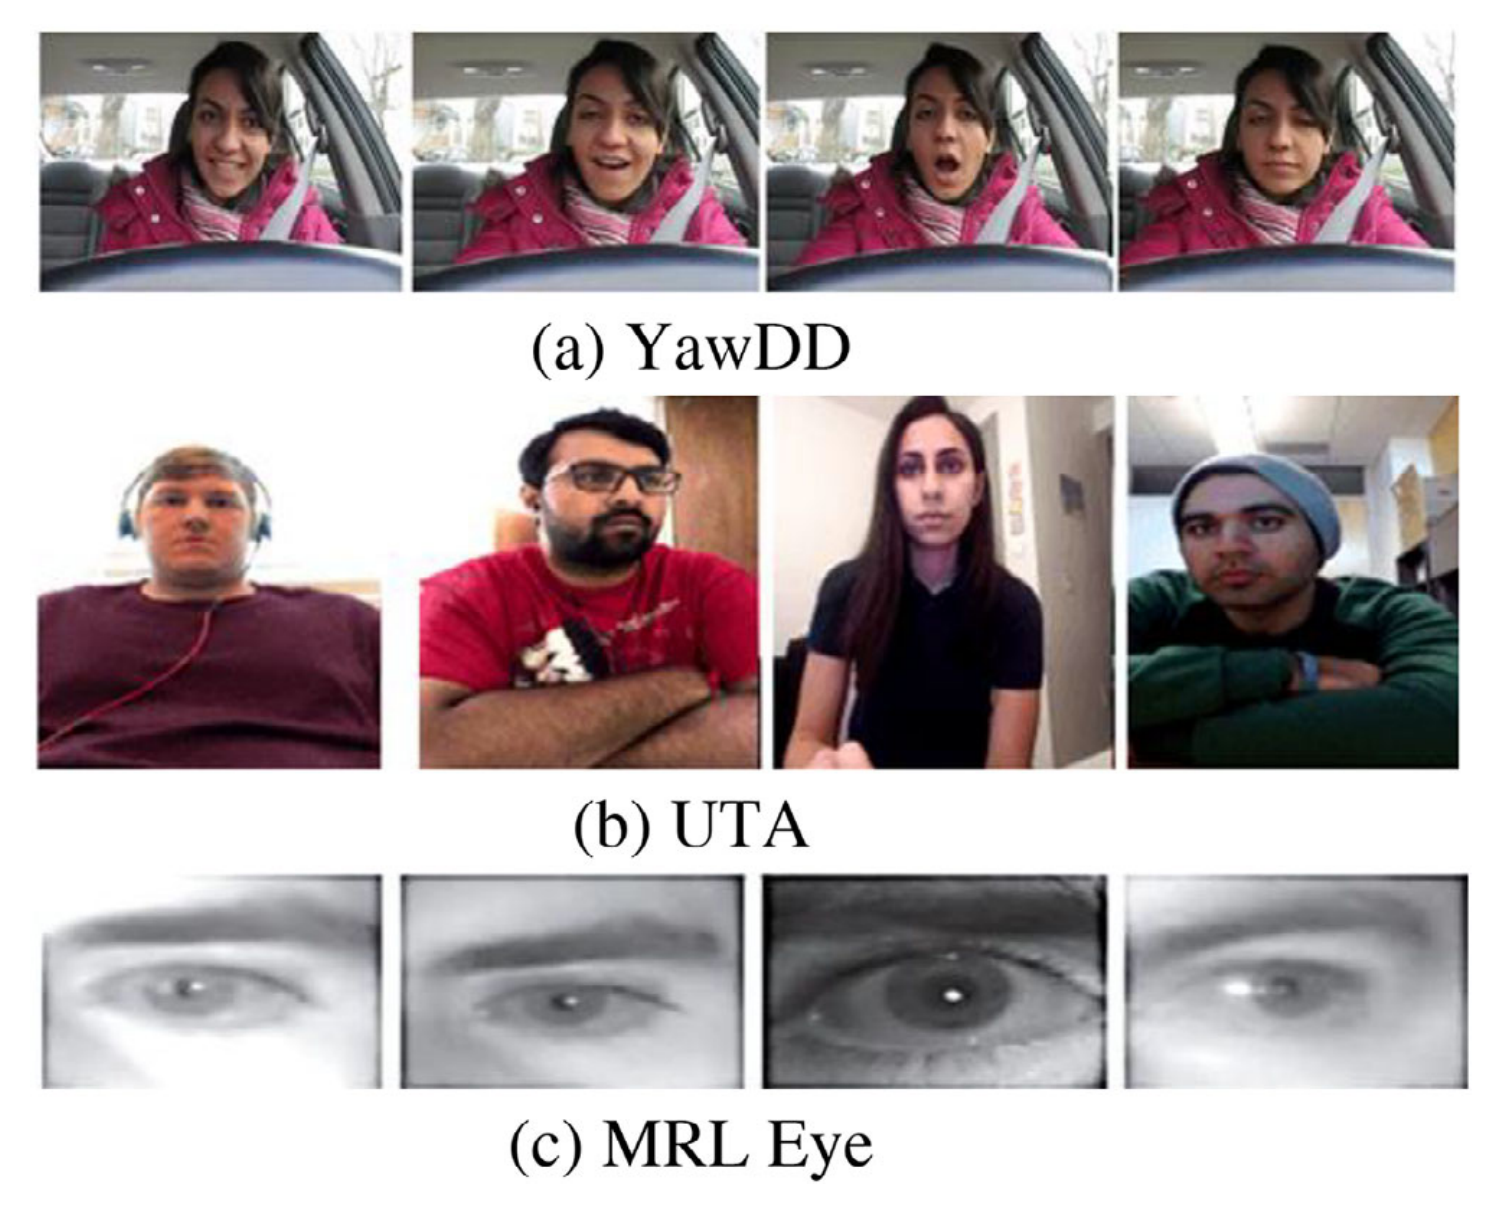
本工作在三个不同数据集上训练与测试:MRL 眼部数据集、哈欠检测数据集(YawDD)与德州大学阿灵顿分校(UTA)数据集。
1. MRL 眼部数据集:MRL Eye Dataset [49] 是驾驶员瞌睡检测领域的重要资源,为研究者与从业者推进道路安全提供了有价值的工具。该数据集源自多媒体研究实验室(Multimedia Research Lab),聚焦多媒体相关研究,尤其是瞌睡检测等计算机视觉应用。它收录了在各种条件下采集的多样化眼部图像,对不同眼睛状态、表情与疲劳水平提供了真实的呈现,是训练与评估驾驶员瞌睡检测算法的坚实基础。
2. YawDD 数据集:YawDD [51] 在瞌睡检测中意义重大,聚焦识别指示驾驶员疲劳的关键生理线索。该数据集跨越各种实例,在不同条件与场景下采集哈欠发生情况,为打磨有效区分哈欠与非哈欠状态的算法提供了定制平台。在该数据集上运用机器学习技术,研究者可以建立能够及时检测并分析实时哈欠模式的算法,为瞌睡发生的及时识别做出贡献。
3. UTA 数据集:除上述两个部件专用数据集外,研究还纳入 UTA 数据集 [50] 进行分析。系统处理从两个视频数据集提取的逐帧图像以检测瞌睡。实验使用 UTA-RLDD(德州大学阿灵顿分校真实生活瞌睡数据集,The Real-Life Drowsiness Dataset from the University of Texas at Arlington),这是瞌睡检测领域最大的公开基准数据集。该数据集包含 36 名参与者在不同场景下的视频,包括哈欠、点头等瞌睡相关症状,以及打电话、大笑、凝视等非瞌睡活动。每段视频约 90 秒。研究者按瞌睡状态从每位参与者的视频中随机抽取帧并做二值标注。帧分辨率为 640 × 480,相对较高。数据集呈现尺度、姿态与感知等变换,是展示所提出系统在真实场景中的效率与性能的合适基准。各数据集样例见图 11。
本研究的主要目标是开发一个能够以非侵入方式监测驾驶员警觉程度的瞌睡检测系统。识别驾驶员状态的关键参数是眼睛与嘴部状态。首先对 MRL 眼部数据集进行离线审查,以区分闭眼与睁眼。基于多份眼部样本测试,若眼部图像比例高于阈值则判定为睁眼,否则为闭眼。结果表明,程序检测到了图像中的大多数眼睛,仅那些存在过度反光与低质量的除外。值得注意的是,在离线检测场景中,系统对不同性别以及戴镜与否的眼睛状态检测均表现良好,仅可能因反光与不利光照条件产生误差。相比之下,程序对嘴部状态的离线检测达到 100% 准确率,因为外部障碍未影响其性能。研究还通过直方图对睁眼与闭眼的眼部状态进行了直观可视化。
灰度图像由强度标量值的像素组成,强度值范围从 0(黑)到 255(白)。处理流程包括:自适应阈值化将睁眼与闭眼照片转换为二值图像,随后裁剪。为去除二值图像中的错误像素,引入扁平结构元素进行腐蚀与膨胀。裁剪后的图像转换为二值格式,以便用「imhist」函数创建直方图,实现睁眼可视化。呈现二值图像信息密度的图表使黑像素(瞳孔)与白像素(皮肤)之比的计算变得容易,从而判定眼睛是否睁开。直方图中,强度 0–50 级别上的暗像素峰值出现在约 155 处;睁眼图像的密度集中在 0 到 400 之间,此后密度逐渐下降。闭眼图像也执行了类似流程,得到 0 到 300 的密度分布、强度 0–50 级别约 155 处的暗像素明显峰值,以及 150–250 之间暗像素的少量增加。
YawDD 数据集的评估涵盖三种驾驶场景:正常驾驶、驾驶中说话与驾驶中打哈欠。对该数据集的分析显示,大多数眼睛状态都能被准确检测,但戴眼镜者的案例因镜片反光而出现检测困难,导致系统检测器对眼睛状态的判定不准。系统在眼部与嘴部状态分析和训练上的成功率为 94.56%。不戴眼镜与戴眼镜的瞌睡检测样例结果分别如图 12 与图 13 所示。
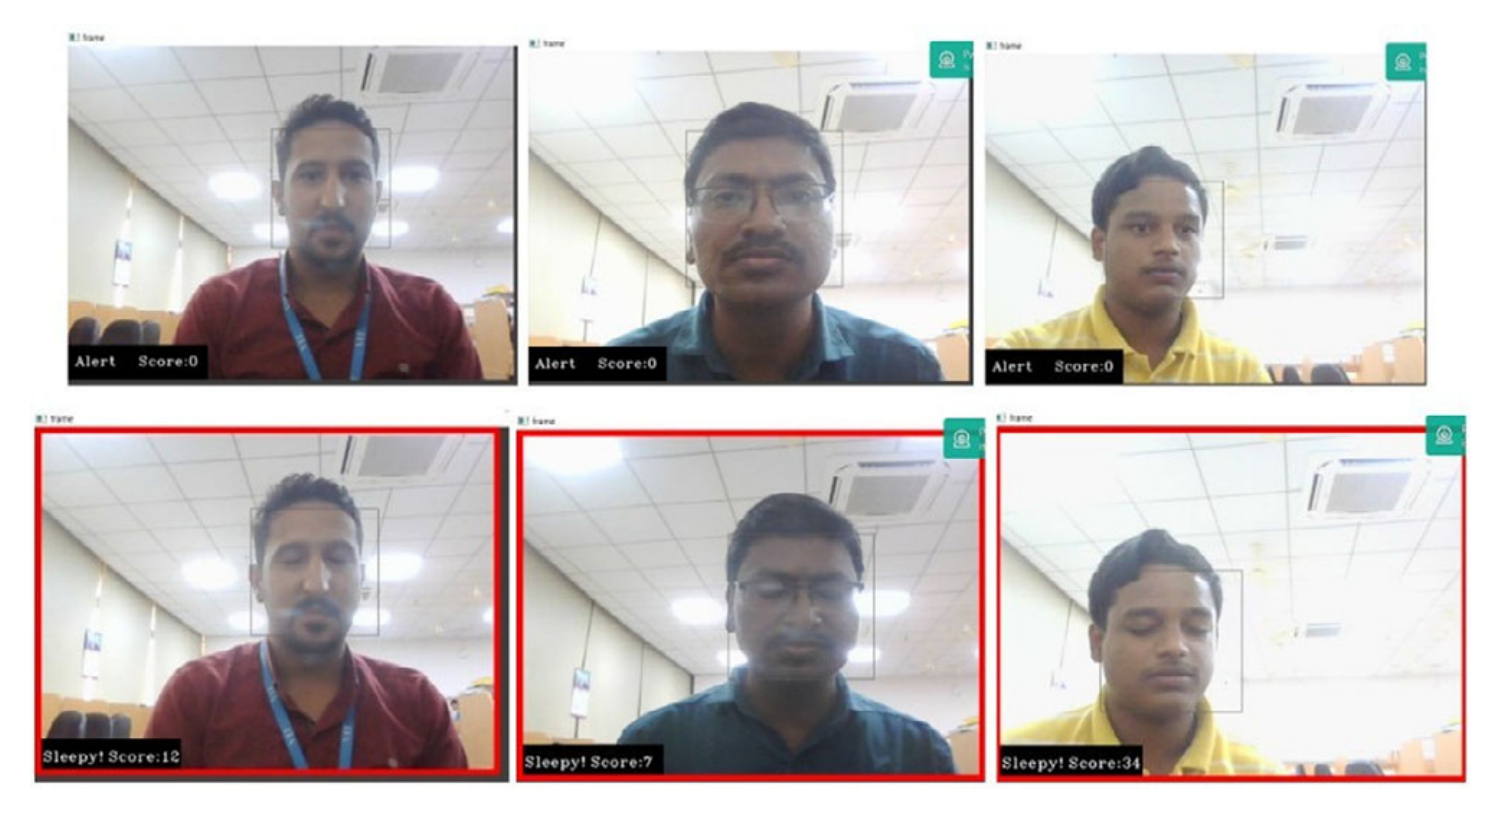
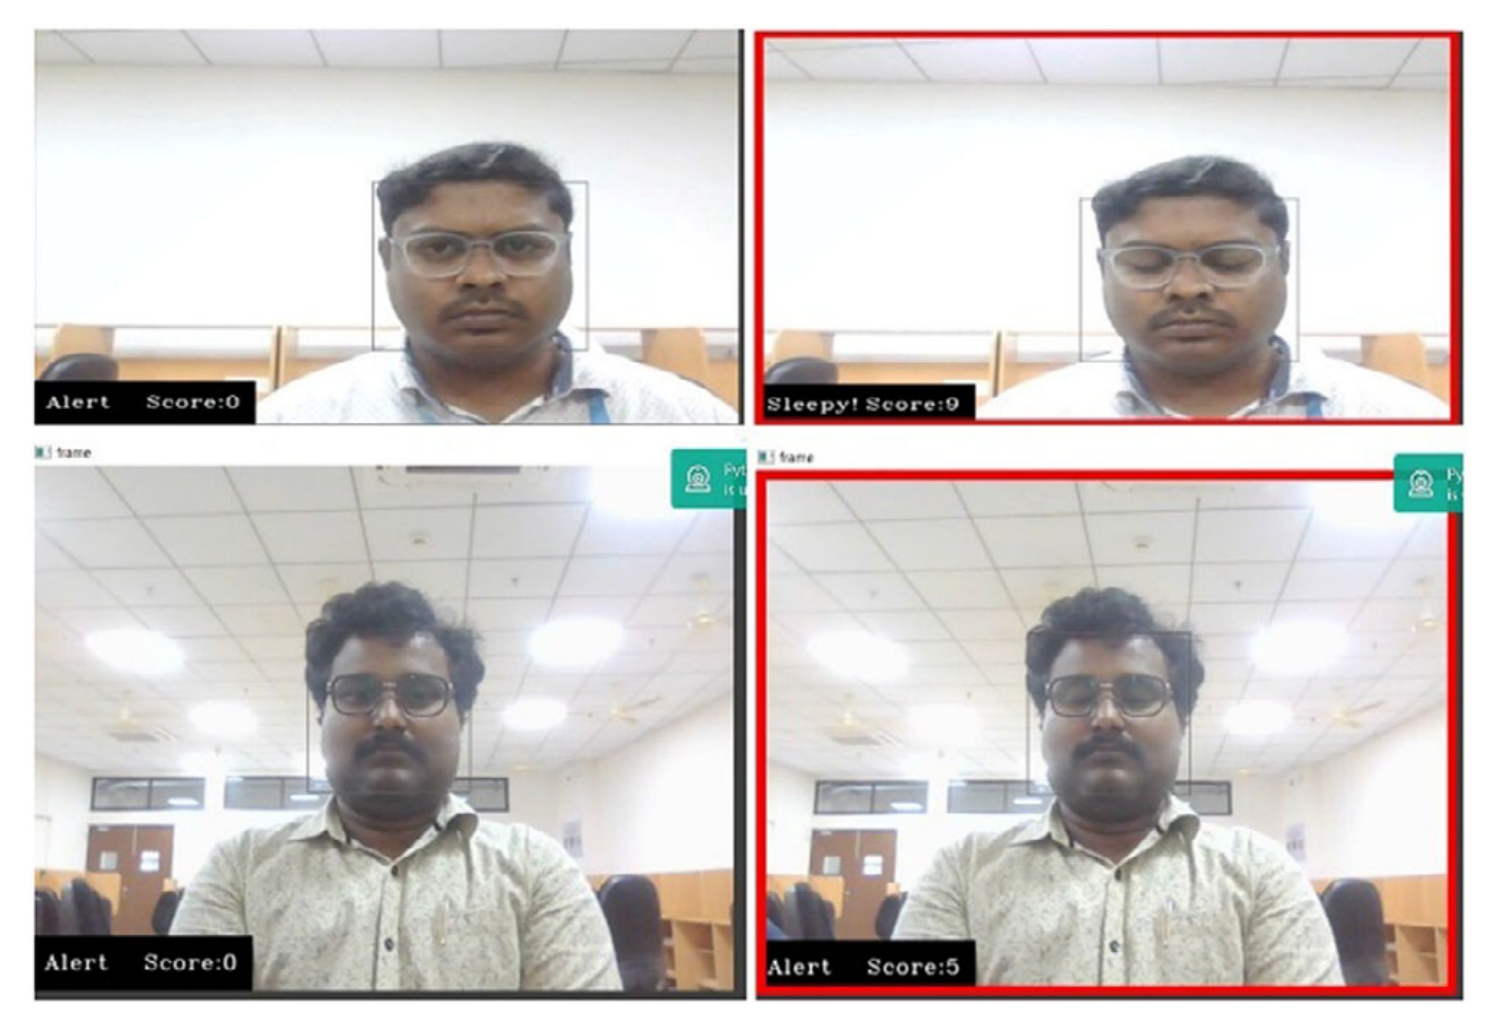
表 4 给出头部位置对驾驶员瞌睡检测的影响。对头部位置影响的分析表明其在实现准确分类中的重要性:驾驶员头部向右倾斜时,所有瞌睡状态(非瞌睡、疲劳、完全瞌睡)都能被有效检测,准确率 94.80%;头部向左倾斜时,能识别疲劳与完全瞌睡状态,但非瞌睡检测受限,准确率略降至 94.07%;头部朝上时,非瞌睡与完全瞌睡状态难以检测,虽能捕捉疲劳,准确率 95.88%;头部朝下时达到最高准确率 96.82%,因为所有状态都被一致检测到。这些结果表明,头部位置对系统准确性有关键影响,头部朝下最有利于鲁棒检测。
| 状态 | 非瞌睡 | 疲劳 | 完全瞌睡 | 准确率(%) |
|---|---|---|---|---|
| 头部向右 | ✔ | ✔ | ✔ | 94.80 |
| 头部向左 | ✘ | ✔ | ✔ | 94.07 |
| 头部朝上 | ✘ | ✔ | ✘ | 95.88 |
| 头部朝下 | ✔ | ✔ | ✔ | 96.82 |
译注:表 4 原文如此——头部朝上一行仅检测到 3 种状态中的 1 种,准确率(95.88%)却高于三种状态全部检出的「头部向右」(94.80%),两者的准确率口径明显不一致,引用时需谨慎。
表 5 展示眼镜对检测不同瞌睡状态的影响,凸显其对系统准确性的作用。驾驶员戴眼镜时,系统能有效检测非瞌睡与疲劳状态,但难以识别完全瞌睡状态,准确率 94.50%;不戴眼镜时,系统能准确识别非瞌睡状态,但未能检测疲劳与完全瞌睡两种状态,取得略高的 97.76%。这些发现表明,眼镜虽然影响特定瞌睡状态的检测,但并非一致地妨碍性能。不过系统整体上在不戴眼镜时表现更好,提示其在处理眼镜导致的反光或遮挡方面存在潜在局限。
| 状态 | 非瞌睡 | 疲劳 | 完全瞌睡 | 准确率(%) |
|---|---|---|---|---|
| 戴眼镜 | ✔ | ✔ | ✘ | 94.50 |
| 不戴眼镜 | ✔ | ✘ | ✘ | 97.76 |
译注:表 5 原文如此——「不戴眼镜」一行疲劳与完全瞌睡两种状态均未检出(✘),准确率反而(97.76%)高于检出两种状态的「戴眼镜」行(94.50%),与表 4 存在同样的口径问题。
表 6 比较了使用不同特征与模型检测驾驶员疲劳的各类方法及其准确率。检测框架的对比凸显了驾驶员疲劳检测系统的若干趋势:UTA 数据集最为常用,反映其适应性;MRL 与 YawDD 数据集也常被使用,支撑鲁棒性测试。检测技术主要依赖模糊逻辑及其变体,如 s-FCM 聚类(Azim 等,2014 [43])与模糊推理系统(Celecia 等,2020 [45]),它们擅长处理不确定性。HOG 特征与朴素贝叶斯分类(Bakheet 等,2021 [46])、Haar 模型(Celecia 等,2020 [45])以及置信规则库方法(Feng 等,2024 [47])等补充方法进一步丰富了检测策略。疲劳检测主要聚焦眼部与嘴部特征,包括 PERCLOS、EAR、MAR 与哈欠,所提出的框架将范围扩展到最长闭眼时长,增强了全面性。尽管如此,显式处理遮挡或眼镜的框架很少,只有 Devi 等(2010 [44])与所提框架有效应对了该问题。对不同光照条件的鲁棒性仍是挑战,成功应对的框架有限,包括 Azim 等(2014 [43])、Devi 等(2010 [44])与所提框架。在准确率方面,所提框架取得最高性能(97.31%),归因于其广泛的特征集、模糊逻辑的整合,以及应对遮挡与光照变化的能力。Devi 等(2010 [44])同样表现出色(96.94%),但其较窄的特征集限制了整体鲁棒性。因此,所提框架作为驾驶员疲劳检测的全面可靠方案脱颖而出。
| 文献 | 数据集 | 检测技术 | 疲劳特征 | 眼镜遮挡处理 | 不同光照鲁棒性 | 准确率(%) |
|---|---|---|---|---|---|---|
| Riaz 等 (2018) [42] | UTA | 情感赋能认知驾驶辅助模型 | 眼、嘴 | ✘ | ✘ | 84.61 |
| Azim 等 (2014) [43] | UTA | 模糊 C 均值(s-FCM)聚类 | 眼、嘴 | ✘ | ✔ | 74.77 |
| Devi 等 (2010) [44] | MRL、UTA | 模糊逻辑算法 | 眼、嘴 | ✔ | ✔ | 96.94 |
| Celecia 等 (2020) [45] | YawDD | 模糊推理系统;Haar 模型;HOG 模型 | PERCLOS、嘴 | ✘ | ✘ | 95.57 |
| Bakheet 等 (2021) [46] | MRL、YawDD | HOG 特征与朴素贝叶斯分类 | 眼 | ✘ | ✘ | 85.60 |
| Feng 等 (2024) [47] | YawDD | 模糊逻辑、置信规则库方法 | 眼、嘴 | ✘ | ✘ | 94.53 |
| 所提框架 | MRL、YawDD、UTA | 疲劳特征与模糊逻辑 | EAR/MAR/哈欠/PERCLOS/最长闭眼时长 | ✔ | ✔ | 97.5 |
译注:正文称所提框架准确率为 97.31%,而表 6 与摘要均为 97.5%,原文两处数字不一致。
本研究提出了一种瞌睡检测方法,在驾驶员驾驶时跟踪其眼部与嘴部运动。研究用不同受试者与环境变量开展了检验系统眼部与嘴部状态检测能力的实验。准确率显著高于竞争工作,嘴部检测达 96%,眼部检测达 87.8%。此外,系统还在不同昼夜时段、戴镜与不戴镜人员参与的多段视频中进行了评估。所提出的方案在驾驶员状态检测方面取得 97.5% 的测试准确率。此外,研究还构建了以视觉与嘴部变量为输入的模糊模型,通过评估与构建的 IF-THEN 规则分析驾驶员疲劳。
考虑到光照问题,系统应考虑集成红外敏感相机,使系统无论光照条件如何都能良好工作。由于驾驶员打哈欠时通常遮住嘴部,所提方法无法检测其说话状态。因此,系统需要纳入方向盘转角等额外因素。通过车内安装相机跟踪驾驶员行为与警觉性是常用手段。系统应提升响应时间,以防止瞌睡检测系统引起的误报并获得可靠结果。
作者贡献:Mohan Arava:实验构思与设计、图表制作、实验执行、数据分析、计算工作,并批准最终稿。Divya Meena Sundaram:实验构思与设计、文章草稿撰写与审阅,并批准最终稿。
利益冲突:作者声明无利益冲突。
数据可用性声明:本研究使用的所有数据集均可在网上公开获取,包括数据集链接在内的详细信息见本文参考文献部分。
本章是译者面向本站关注的驾驶员状态监测(DMS)/舱内感知工程视角的评估,不构成原文内容。评估基于原文的表格与数据,而非正文结论。