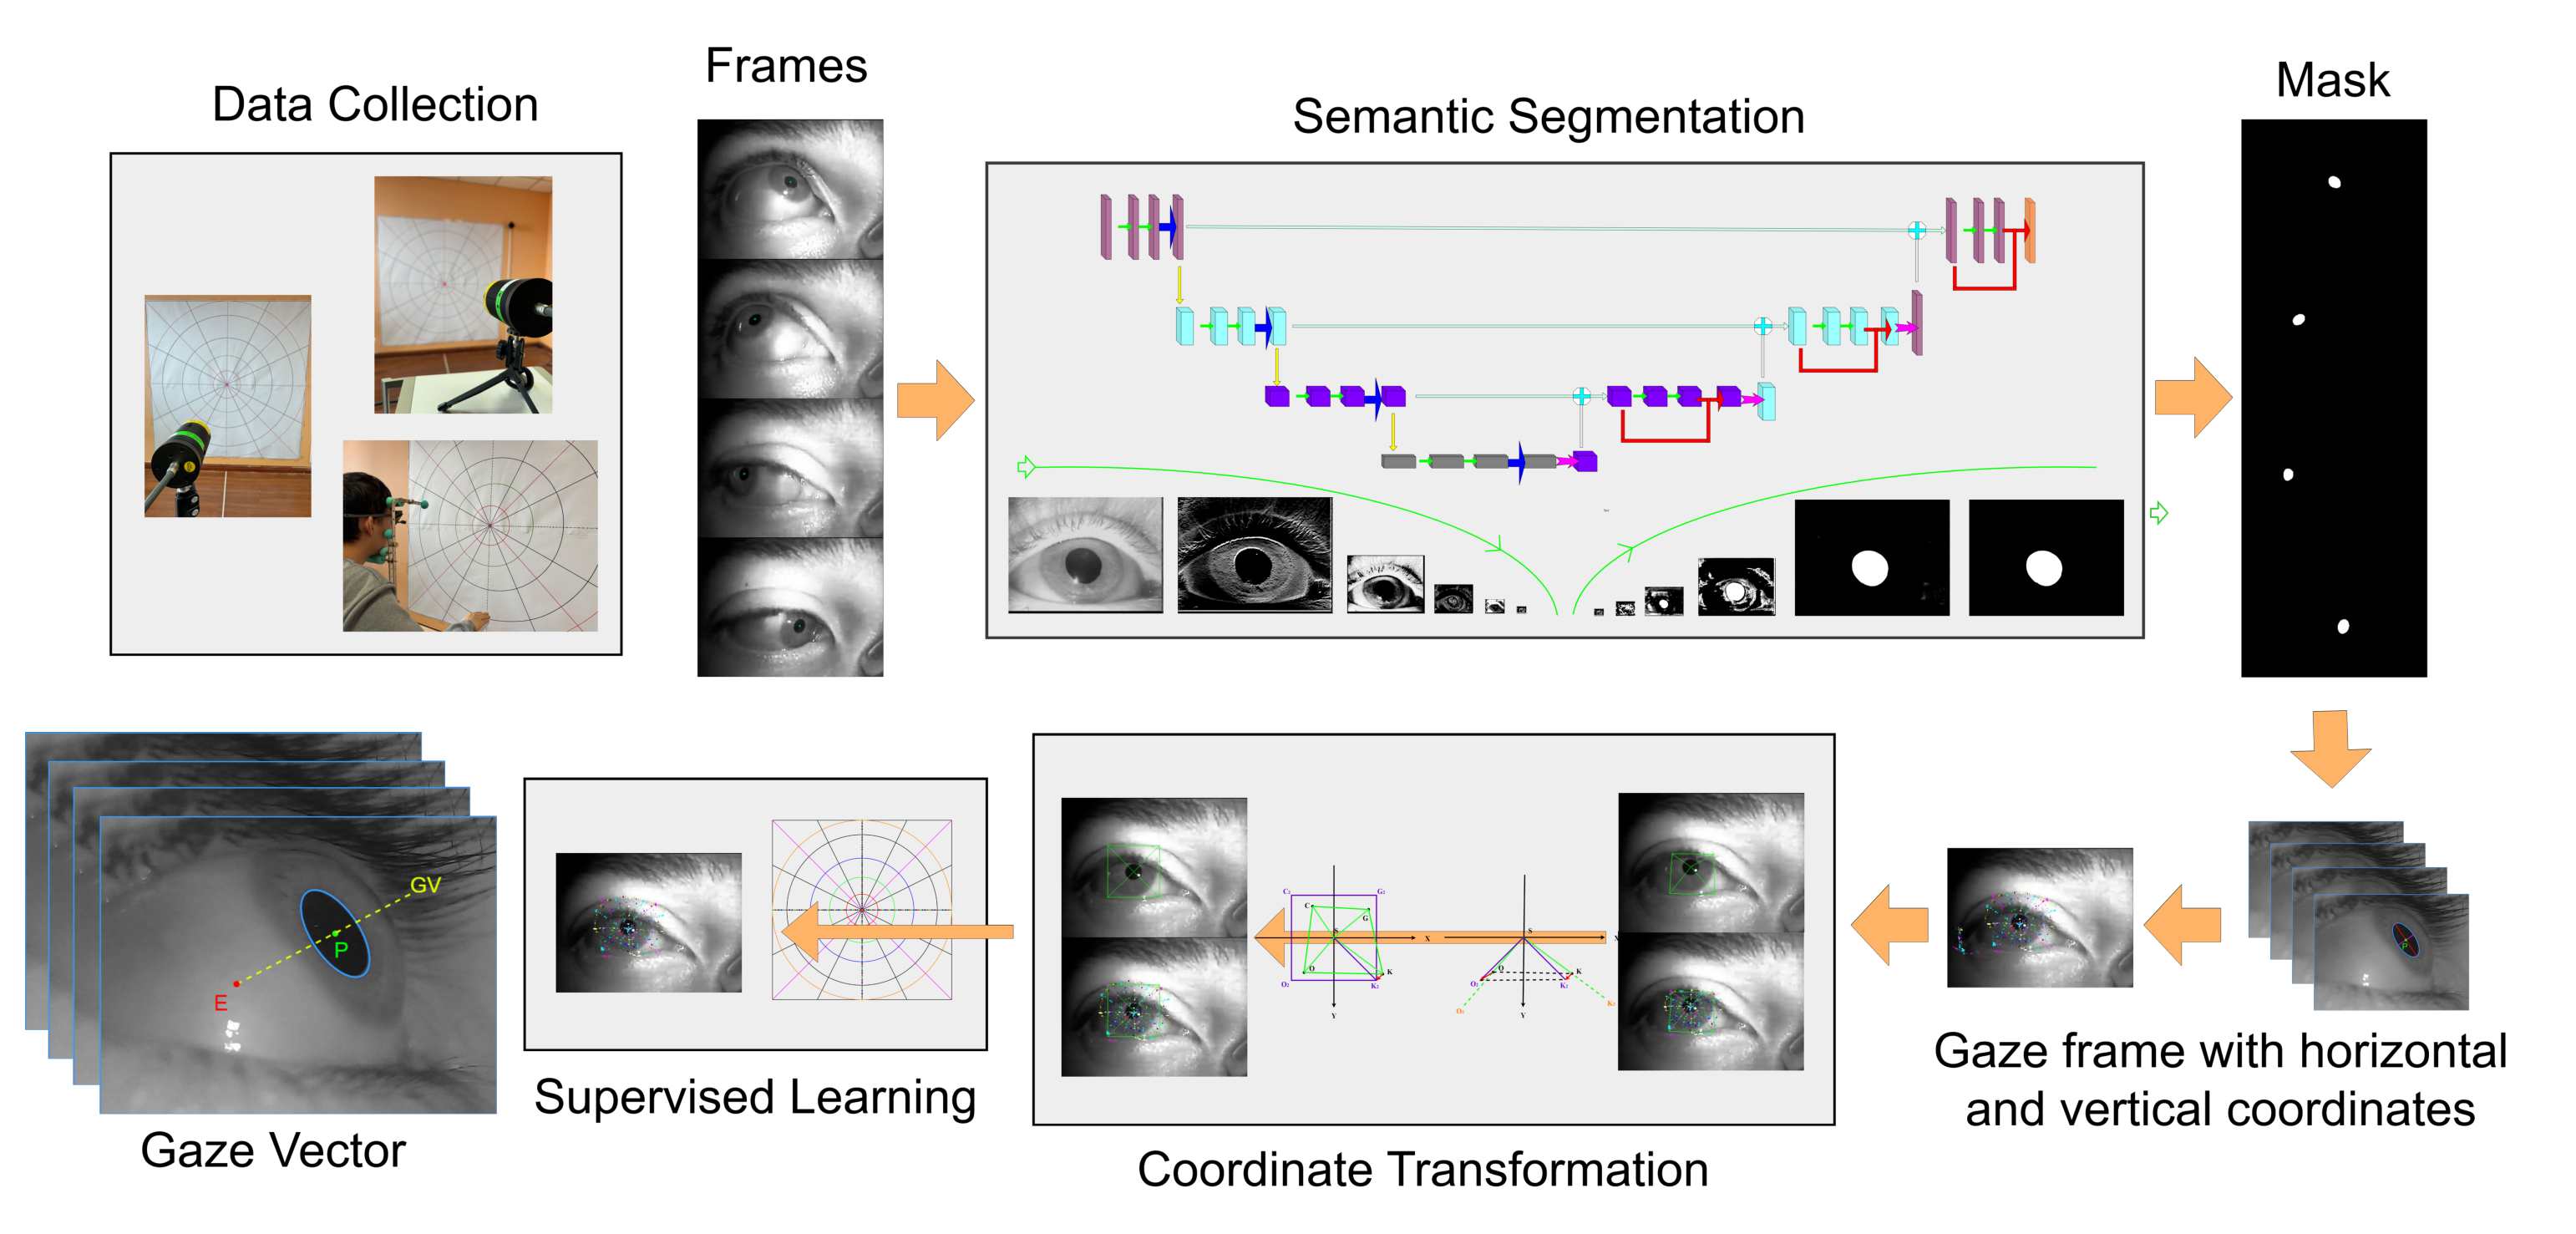
眼动追踪在虚拟现实与增强现实应用中正变得越来越重要;然而,当前的注视精度尚无法满足空间计算(spatial computing)的要求。我们设计了一套注视数据采集框架,并利用高精度设备采集了首个精确的基准数据集 GazeTrack,涵盖不同族裔、年龄段与视立条件,用于瞳孔定位与注视追踪。我们提出一种新颖的形状误差正则化方法来约束瞳孔椭圆拟合,并在开源数据集上训练,提升了语义分割与瞳孔位置预测的精度。此外,我们发明了一种类似"纸张展开"的新颖坐标变换方法,以在 GazeTrack 数据集上准确预测注视向量。最后,我们构建了一个注视向量生成模型,与其他方法相比,以更低的计算复杂度实现了更小的注视角度误差。更多细节请参阅我们的项目页面:https://github.com/—-(请参阅其他补充材料)。
空间计算时代的兴起(Balakrishnan 等,2021)为人机交互(HCI)方法带来了前所未有的发展机遇。作为人机交互的重要手段,眼动追踪技术已逐渐成为研究与应用领域的热点。眼动追踪技术通过追踪用户的眼动,实现更智能、更直观的交互,显著提升用户体验。基于空间计算的注视向量生成技术代表着眼动追踪技术发展的新方向。一方面,该技术能够精确监测与分析用户的注视行为,为用户提供个性化的交互体验;另一方面,它可以应用于虚拟现实(Anthes 等,2016)和智能驾驶(Wu、Chen 与 Metaxas,2020)等领域,为相关技术的发展提供新的思路与方法。这对推进人机交互技术意义重大。
然而,实现注视向量生成面临诸多挑战。首先,眼动追踪需要处理与分析眼部图像,而眼图常受环境光照与快速眼动影响,图像质量较差。其次,眼睛形状复杂,传统图像处理方法难以准确提取眼部轮廓。注视向量生成需要准确的数据,但现有数据精度不足。此外,当前硬件难以满足注视向量生成的计算复杂度要求——后者要求低延迟与高帧率。
为应对这些挑战,我们的研究采用语义分割、椭圆拟合与坐标变换等技术,对眼部图像进行精确处理与分析,最终生成注视向量。
特别地,本工作做出如下贡献:
局限性(limitations) 眼动追踪设备通常需要佩戴在头部,剧烈的头部运动可能会对眼动追踪数据引入干扰,导致数据失真与精度下降。
语义分割、图像形变、坐标变换、视线估计与空间计算是涉及计算机视觉、人机交互与人工智能等多个领域的重要研究方向。多个团队致力于这些领域的研发。
O. Ronneberger 提出的 U-Net(Ronneberger、Fischer 与 Brox,2015)将全卷积网络(FCN)与自编码器结构相结合,实现端到端语义分割。它采用由对称的编码器与解码器部分构成的 U 形架构,并借助跳跃连接(skip connection)融合低层与高层特征,有效提升分割精度并降低模型训练中过拟合的风险。U-Net 在电子显微镜堆叠图像的神经结构分割任务中表现出色,并赢得了当年的 ISBI 细胞追踪挑战赛。
W. Fuhl(Fuhl 等,2016a)专注于眼部分割的语义分割,提出了一种包含眼睑识别与瞳孔估计的通用眼动追踪方法。该方法在户外驾驶场景中取得了高达 40% 的性能提升,展现了实时运行与高精度。该团队在保持模型性能与实时性的同时,提出了一种新方法(Fuhl 等,2020),用决策树层替代卷积层,显著降低计算复杂度。他们还比较了在神经网络中使用卷积层、二值层与决策树层估计瞳孔轮廓的效果(Fuhl 等,2020),证明可以在提升瞳孔轮廓估计的精度与鲁棒性的同时保持实时性。该团队结合 Haar 类特征(Haar-like features)(Fuhl、Schneider 与 Kasneci,2021)与统计学习技术,提出了一种适用于移动眼动追踪与高速注视追踪的瞳孔分割方法。
Mirikharaji Z 与 Hamarneh G 通过在皮肤病灶分割任务中引入星形(Star Shape)先验,优化了全卷积网络(FCN)的性能(Mirikharaji 与 Hamarneh,2018),取得了领先的实验结果。受此启发,Han 等人通过引入形状先验,提出了一种基于 CNN 的鲁棒瞳孔中心检测方法(Han 等,2020),增强了对噪声的鲁棒性。Schnieders(Schnieders、Fu 与 Wong,2010)从单张图像重建眼部模型以计算双眼向量。
微软的 Erroll Wood 团队(Wood 等,2016)利用计算机视觉推断人眼的注视点或注意力焦点,以改进用户界面设计、监控系统等。谷歌已就自动驾驶眼动追踪申请专利,其思路是从注视方向理解驾驶员的注意力与意图,将眼动追踪技术融入其自动驾驶系统,使其更智能、更安全。英伟达发布了 NVGaze 数据集(Kim 等,2019),用于基于解剖学信息的低延迟近眼视线估计,其中包含面部形状、注视方向、瞳孔与虹膜、肤色以及外部条件的变化。他们还从 35 名被试采集了一个真实世界数据集。利用这些数据集,他们训练的神经网络实现了亚毫秒级延迟,视线估计误差为 2.06 度(±0.44 度)。
Dierkes(Dierkes、Kassner 与 Bulling,2018)、Świrski(Świrski 与 Dodgson,2013)等人利用多视角图像获取眼部的几何信息,通过数学建模与优化算法估计眼睛的形状与位置,进而进行注视预测。Otmar Hilliges(Zhang 等,2020)创建并开源了 ETH-XGaze 数据集,并提出了一种用于无监督学习的新损失函数。Jean-Marc Odobez(Siegfried 与 Odobez,2022)采用任务注意力先验与多模态信息进行注视点估计。Sugano(Lu 等,2015)(Zhang 等,2017)采集了 MPIIGaze 数据集,包含 213,659 张用户日常使用笔记本电脑时的全脸图像,以及对应的真实注视位置。数据采用经验采样法采集,以保证注视与头部姿态的连续性,并考虑眼部外观与光照的真实变化。
与以往方法相比,我们的方法提升了注视向量生成的精度、降低了计算复杂度,并适用于从各种角度采集的眼部数据,使高精度空间计算更加实用。
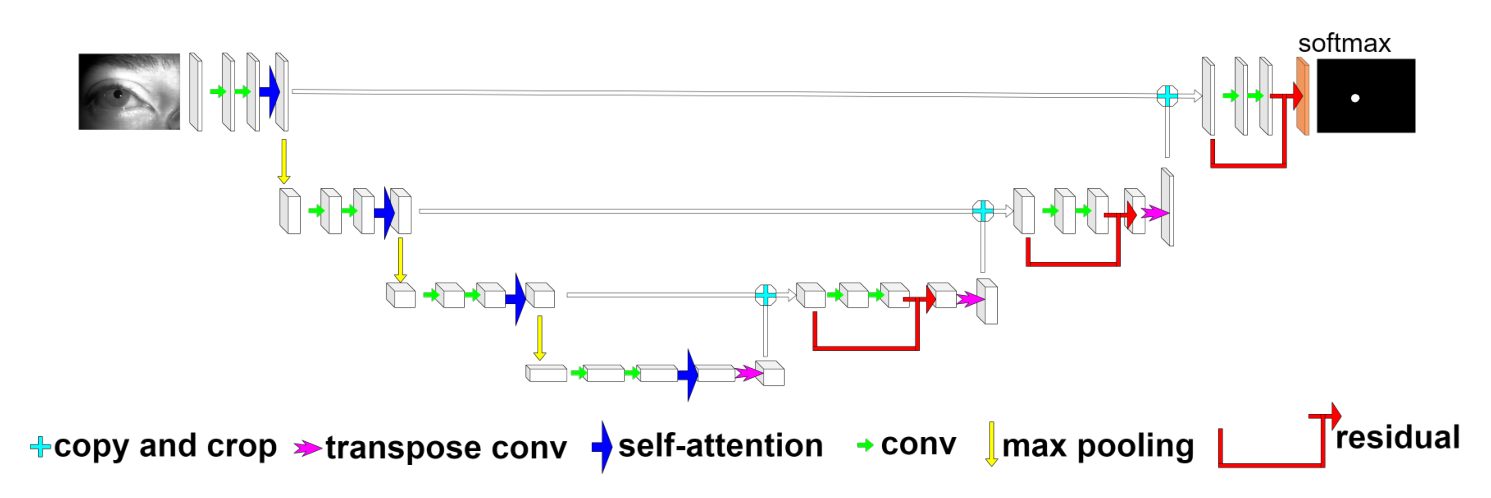
首先,我们开发了基于 U-Net 的 U-ResAtt 模型,融入了注意力机制与残差连接。我们将二值交叉熵与椭圆拟合误差(LEFE)正则化方法相结合来有效约束损失,从而减少由反光、遮挡与快速眼动引起的误差,提升瞳孔定位的精度与鲁棒性。其次,利用图像形变与线性插值的概念,我们创建了一种坐标变换方法,把从被试采集的注视分布图调整成标准形状。最后,我们构建了一个注视生成模型,以滑动窗口为输入进行训练。下面将详细描述该方法的各个组成部分。
模型概述 为实现瞳孔的精确语义分割,我们在 U-Net 模型中融入了注意力机制与残差连接(He 等,2016)。这一改进旨在提升低光照、反光与快速眼动等困难条件下的分割精度。通过减少原始层数,我们解决了实时处理的约束。增强后的 U-ResAtt 模型结构如图 2 所示。
二值交叉熵 在众多可选方案中,二值交叉熵损失(LBCE)函数是图像分割(Yeung 等,2022)任务中常用的损失函数之一。对于二分类问题,该损失函数度量网络预测的概率分布与真实标签概率分布之间的差异。其计算公式如下:
其中 i 表示 N 张图像中的第 i 个批次,I 为图像索引集合,Ω 表示图像的像素空间,y 表示真值(Ground Truth,GT)图像,S 表示 CNN 的 Sigmoid 输出。在瞳孔分割中,GT 中只有两个类别:0 代表背景像素,1 代表构成瞳孔的像素。因此 yip 取 0 或 1。log 表示自然对数。二值交叉熵损失函数的负对数似然形式确保正确类别的概率最大化、错误类别的概率最小化。
在图像分割任务中,整幅图像的二值交叉熵损失函数定义为所有像素损失函数的和或平均。通过最小化该损失函数,网络可以学会把图像正确分割成两部分:目标与背景。
椭圆拟合误差 尽管 U-Net 以二值交叉熵(BCE)作为损失函数在许多图像分割应用中表现令人满意,我们证明仅有 BCE 是不够的。为避免运动模糊与反光等影响瞳孔提取的问题,需要在损失函数中加入一个正则化项。该项被命名为椭圆拟合误差(LEFE),基于被检测目标的形状计算,并乘以一个权重参数后加入损失。
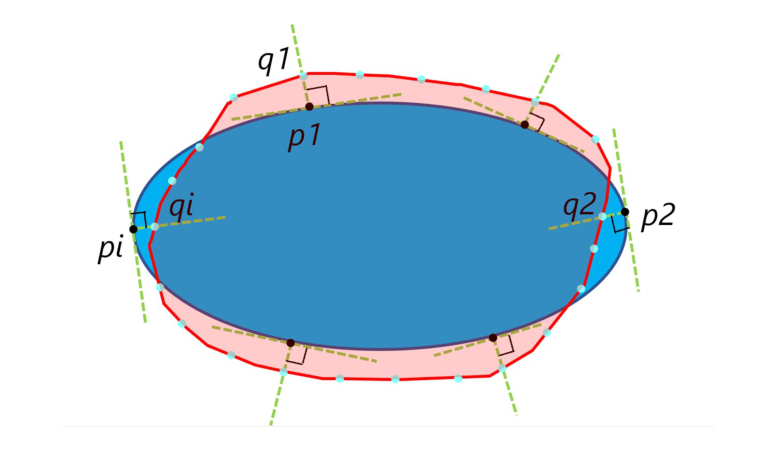
椭圆拟合误差损失作为正则化项加入到像素级损失函数中,以改进瞳孔语义分割。由于 2D 图像中的瞳孔是一个椭圆,目标是让预测的瞳孔分割形状成为一个趋向椭圆的凸多边形,而不仅仅是像素级的边缘分割,从而与瞳孔位置完美匹配。预测瞳孔与真值(GT)椭圆之间的任何偏差都会作为额外的正则化项加入到像素级二值交叉熵损失函数中,迫使模型产生椭圆状的语义推断。
图 3 展示了所提正则化项 LEFE 的计算方式。首先,计算表示 GT 瞳孔边界的椭圆。接着,使用边缘绘制算法(Edge Drawing)(Topal 与 Akinlar,2012)计算预测瞳孔斑点的边界像素(图 3 中的青色点 q)。对预测瞳孔边界上的每个像素,计算 GT 椭圆上距其最近的点(图 3 中椭圆边界上的蓝色点)。然后将 p 与 q 之间的欧氏距离累加到 LEFE。最后,如公式 2 所述,将 LEFE 作为正则化项加入损失函数:
椭圆拟合误差(LEFE)正则化项背后的思想如下:如果检测到的瞳孔斑点边界上的某点位于 GT 之外(如 q1),这一额外损失项会把该点推向 GT 边界上的 p1;反之,如果检测到的瞳孔斑点边界上的某点位于 GT 之内(如 q2),这一额外损失项会把 q2 推向 GT 边界上的 p2。当检测到的瞳孔斑点的所有边界像素都位于 GT 边界上时,LEFE 趋于 0,这正是本研究期望的结果。
用数学语言表述,表示 GT 瞳孔边界的椭圆方程为:
该椭圆方程可转换为参数形式,如公式 4 所示:
给定预测瞳孔斑点边界上的点 q = (x, y),目标是计算椭圆边界上的最近点 p。若 p 以公式 5 所示的极坐标表示,p⃗ 的切向必须与直线 q⃗ − p⃗(θ) 垂直:
公式 5 现在可通过公式 6 对 θ 迭代求解:
建议使用 tan−1(αy / βx) 作为 θ 的初始值。该方程组可用牛顿-拉夫逊法数值求解,且根据 Cakir 与 Topal(Cakir 与 Topal,2018),每个点的收敛只需两到三次迭代。一旦为每个检测到的瞳孔像素 q 找到最近的 GT 椭圆边界像素 p,即可用公式 7 计算两条轮廓在欧氏空间中的距离:
其中 eGT 表示 GT 瞳孔的边缘像素,eP 表示检测到的瞳孔的边缘像素。随着 LEFE 趋近于 0,检测到的瞳孔斑点收敛到 GT 椭圆,从而迫使网络产生椭圆状的推断。
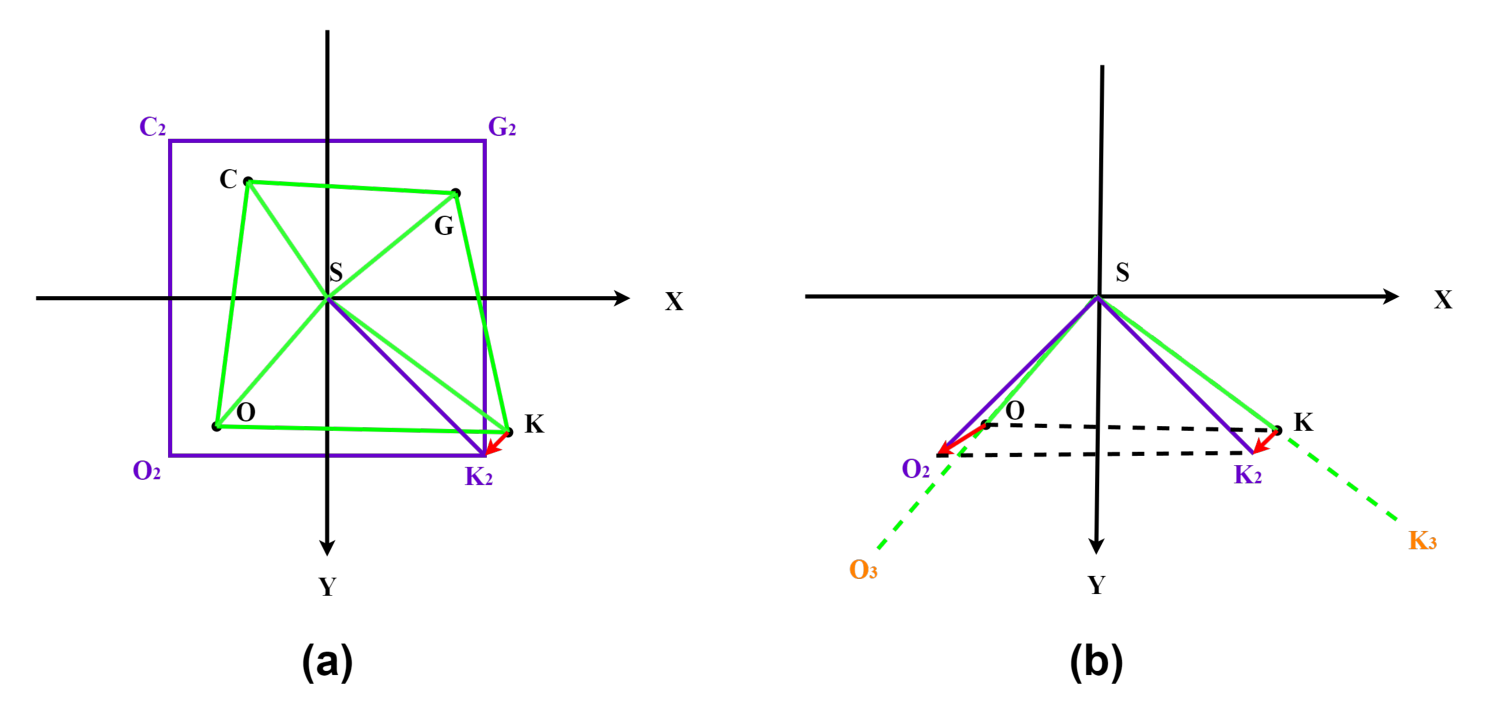
对每一组点 C、G、K 与 O,CoordTransNet 算法计算每个点与中心注视点 S 之间的欧氏距离。它找出距 S 最远的点,并以该距离为参考,确保最长的线段成为坐标轴的对角线。随后,CoordTransNet 算法利用该参考计算变换后的正方形 C2、G2、K2 与 O2,同时计算每个点的变换比例。这些比例随后被用于变换其他注视点的坐标。通过线性插值的概念,该算法保证每个注视点的 X、Y 值经历一种类似弹性形变的均匀变换,而非简单的缩放。因此每个点的变换比例各不相同。CoordTransNet 算法利用这些比例计算每个点的新位置。所有注视点依据 X 轴、Y 轴以及直线 SC、SG、SK 与 SO 被划分为八个区域。下面以第二象限为例给出变换比例的细节;其他象限的处理步骤相同,详见补充材料中的代码。
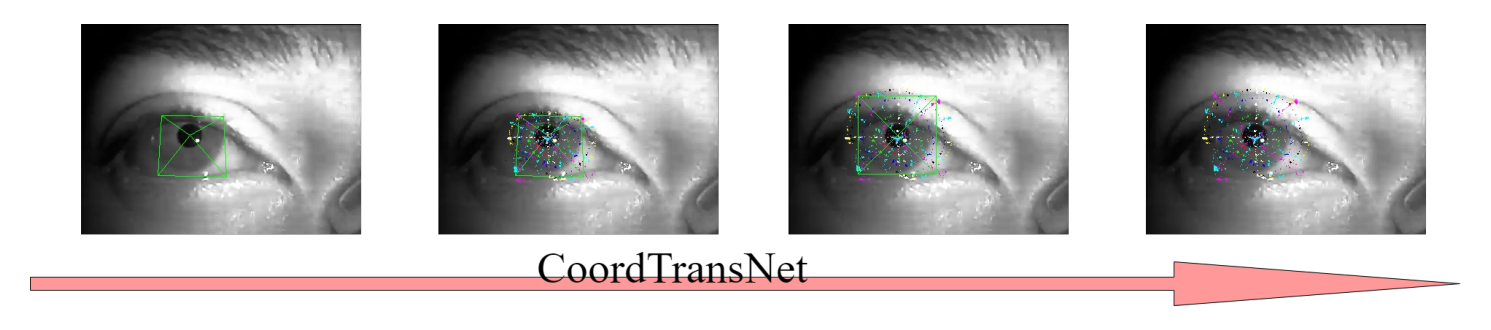
我们使用每个变换后的圆形注视点的坐标进行椭圆拟合(Halır 与 Flusser,1998),并将其线性回归到标准注视视图。这里采用最小二乘法进行拟合。由于前一步进行了精确的语义分割,离群点已大幅减少,类似于拟合前的"净化"过程。若仍有残余离群点干扰,可以设定过滤条件将其剔除。
该方法采用最小二乘法拟合瞳孔椭圆,通过最小化语义分割边缘数据点到拟合椭圆的距离平方和(Fuhl 与 Kasneci,2020)来确定椭圆参数。方法如下:
首先,基于椭圆的一般方程:
令:
待优化的目标函数可确定为:
其中 D 是 n × 6 矩阵 [X1 X2 … Xn]T,‖WTX‖2 = WTXXTW,约束为 WTHW > 0,其中
| 0 | 0 | 2 | 0 | 0 | 0 |
| 0 | −1 | 0 | 0 | 0 | 0 |
| 2 | 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 | 0 | 0 |
| 0 | 0 | 0 | 0 | 0 | 0 |
在公式 8 中,WTHW > 0 表示椭圆参数约束 4AC − B2 > 0。由于 W 是系数向量,对椭圆方程中的系数同时放大或缩小不影响结果。因此当 ‖WTX‖2 = 0 时,任意 W′ = αW(α > 0)均满足条件。于是约束方程可改写为:
基于公式 11 与 12,可构造拉格朗日函数:
对公式 13 关于 W 求导并令其为零,得到:
此时令 S = DTD,则 SW = λHW。由于 S 是正定矩阵,在等式两边左乘 S−1 得:
在公式 15 中,S−1 与 H 均已知,求解该方程等价于求解特征向量,最终得到椭圆方程。
GVnet 模型包含以下关键组件:自注意力层用于捕捉输入数据中的关系;其次,输入数据经过多个隐藏层(即全连接层)处理;由于某些数据集中的输入数据并非全为正值,隐藏层使用 LeakyReLU 激活函数;此外,加入了 Dropout 层以防止模型过拟合。
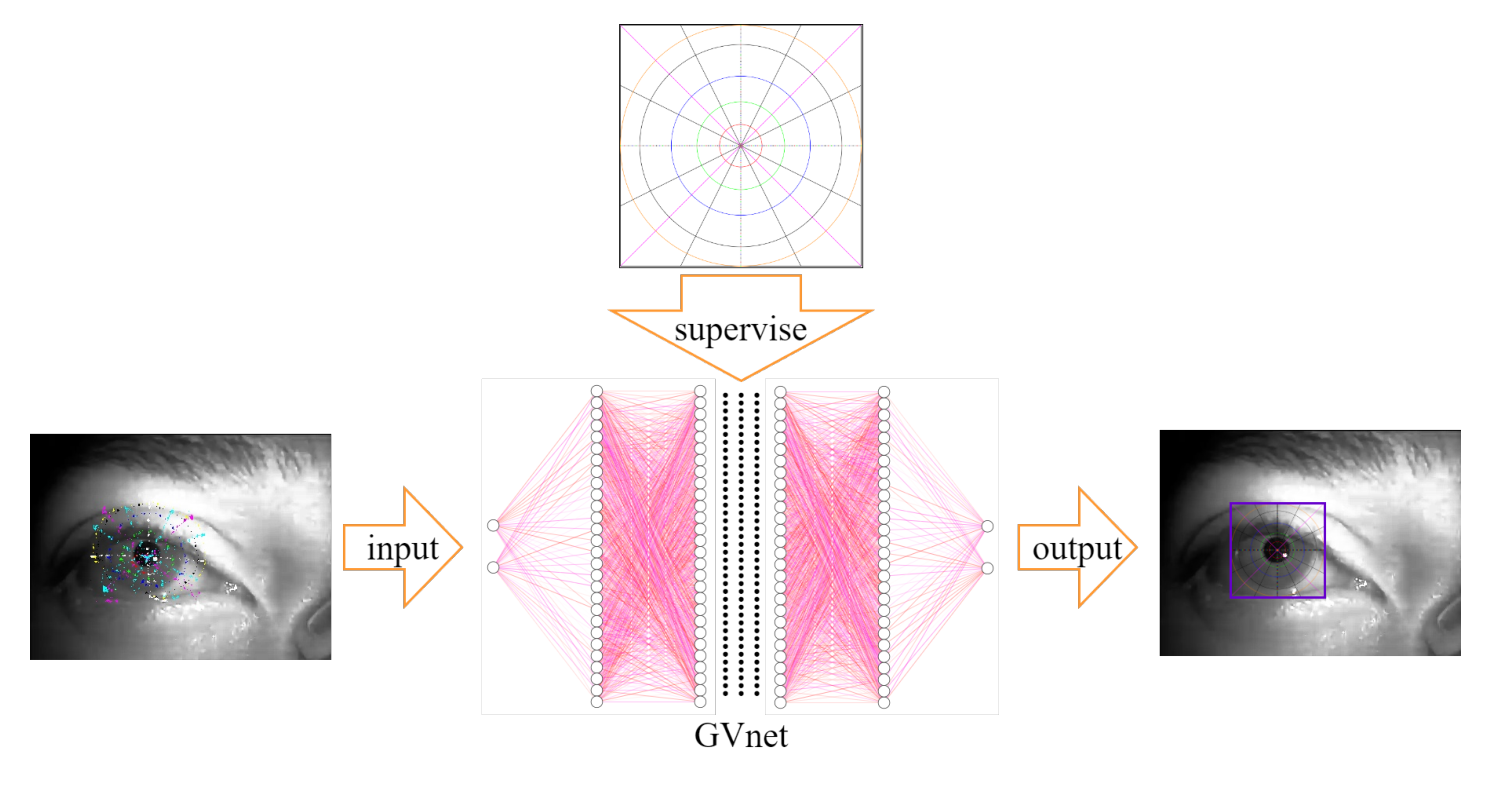
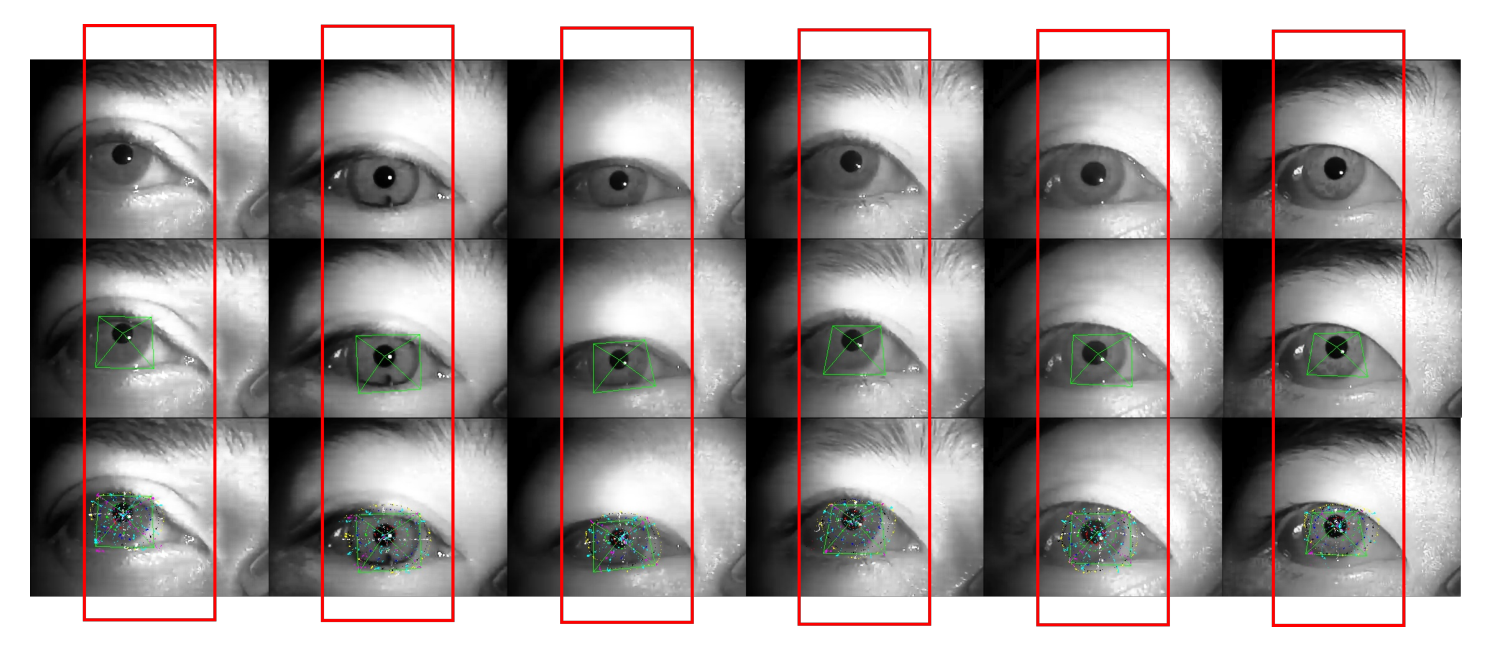
为解决眼动追踪精确训练数据匮乏的问题,我们发明了标准注视视图(standard gaze views),并使用激光定位与眼动仪采集了新的注视数据集 GazeTrack。GazeTrack 包含 47 名不同年龄、性别与族裔志愿者的动态注视数据。这些数据由 DG3 眼动仪上的相机采集,并使用语义分割与形变变换标注了精确的瞳孔坐标。DG3 相机从左眼采集数据,分辨率为 384×288 像素,帧率 60FPS。与以往数据集不同,我们采集了多角度图像,包括点、线与圆,特征鲜明且适用面广。关于数据集的更多细节,如采集方法与环境、类别定义、数据分布等,请参阅补充材料。
下面将描述语义分割、坐标变换与向量生成三组实验结果。关于实验的更多细节请参阅补充材料。
实验设置 我们在带精确标注与过滤的 LPW 数据集上训练 U-ResAtt 语义分割模型,训练-验证比例为 4:1。我们初始化了一个 32 个特征通道的 UNet。采用 Adam 优化器优化模型参数,学习率设为 1e-4。使用学习率调度器('scheduler')在验证损失不再下降时动态调整学习率。我们在二值交叉熵损失中加入了基于椭圆拟合误差的正则化项。若验证损失连续五轮未下降,则提前停止训练。
结果 表 1 给出了在 ExCuSe 数据集 24 名参与者上、不同算法在五像素误差阈值(表示预测瞳孔位置与实际瞳孔位置之间允许的最大偏差,以像素为单位)下的瞳孔检测性能结果,以百分比表示。
| 模型 | 平均精度 |
|---|---|
| Swirski(2012) | 38.23 |
| ExCuSe(2015) | 58.31 |
| EISe(2016b) | 68.20 |
| UNet (base)(2015) | 89.59 |
| UNet (Convex Shape) | 89.78 |
| U-ResAtt (Ellipse Fit Error) | 90.27 |
实验设置 我们使用采集的精确数据集 GazeTrack 进行坐标变换,在 NVIDIA TITAN V 上可实现毫秒级响应。由于该方法纯为数学逻辑,没有任何参数设置。我将通过消融分析来论证该方法的优越性。
结果 表 2 表明坐标变换降低了像素级误差。
| 方法 | 像素误差 |
|---|---|
| 不含 CoordTransNet | 7.20 |
| CoordTransNet | 3.84 |
实验设置 加入早停(early stopping)策略以防止模型过拟合。模型损失函数为均方误差(MSE)损失函数,并使用 Adam 优化器更新模型参数。
结果 为了证明该模型的向量生成效率,即计算复杂度,我们在台式机的 Intel Core i5 单核上使用 1000 条数据统计输入输出的计算时间开销。眼球中心误差的计算方法是像素平均绝对误差(MAE-Pixel),表示估计中心点与实际中心点之间的平均绝对距离,以像素为单位。注视向量误差的计算方法是角度平均绝对误差(MAE-Degree),表示估计注视向量与实际注视向量之间的平均绝对角度,以度为单位。所有误差均以其各自的平均值报告。关于模型的计算复杂度,时间开销基于 1000 对输入-输出数据计算,以秒为单位。表 3 给出了不同模型与算法的结果,其中 W1 表示滑动窗口大小为 1,依此类推。接下来,我将把整个 GazeTrack 方法生成的注视向量的平均误差与第三方数据上的其他算法进行比较。
| 模型 | 注视向量误差(度) | 执行时间(秒) | ||||
|---|---|---|---|---|---|---|
| W1 | W10 | W20 | W1 | W10 | W20 | |
| NN30LM(2020) | 12.57 | 2.58 | 1.82 | 5.00 | 0.50 | 0.47 |
| NN50BR(2020) | 12.33 | 1.73 | 1.02 | 5.00 | 0.34 | 0.32 |
| T5Bag(2020) | 11.37 | 2.81 | 3.16 | 5.00 | 1.48 | 2.15 |
| SVMLIN(2020) | 13.67 | 5.02 | 5.08 | 5.00 | 1.03 | 1.03 |
| SVMGAU(2020) | 12.40 | 11.45 | 19.64 | 5.00 | 1.08 | 1.49 |
| GVnet | 9.37 | 1.35 | 0.94 | 3.93 | 1.01 | 0.75 |
| 方法 | 注视向量误差(度) |
|---|---|
| Swirski(2013) | 7.82 |
| Fuhl(2020) | 5.69 |
| Dierkes(2018) | 5.39 |
| 3dGaze(2022) | 4.38 |
| GazeTrack | 2.84 |
我们解决了虚拟现实与增强现实应用中空间计算对注视精度的现有局限。我们开发了名为 GazeTrack 的注视采集框架,并借助高精度设备采集了涵盖不同族裔、年龄段与视立条件的基准数据集。我们提出了一种新颖的形状误差正则化方法以提升瞳孔椭圆拟合精度,并在开源数据集上训练以增强语义分割与瞳孔位置预测的精度。此外,我们引入了一种类似"纸张展开"的新颖坐标变换方法,以在 GazeTrack 数据集上准确预测注视向量。最后,我们开发了注视向量生成模型,与现有方法相比,以更低的计算复杂度实现了更小的注视角度误差。
Anthes, C.; García-Hernández, R. J.; Wiedemann, M.; and Kranzlmüller, D. 2016. State of the art of virtual reality technology. In 2016 IEEE Aerospace Conference, 1–19. IEEE.
Balakrishnan, S.; Hameed, M. S. S.; Venkatesan, K.; and Aswin, G. 2021. Interaction of Spatial Computing In Augmented Reality. In 2021 7th International Conference on Advanced Computing and Communication Systems (ICACCS), volume 1, 1900–1904. IEEE.
Cakir, H. I.; and Topal, C. 2018. An Euclidean ellipse comparison metric for quantitative evaluation. In IEEE International Conference on Acoustics, Speech and Signal Processing (ICASSP), 1263–1267.
Dierkes, K.; Kassner, M.; and Bulling, A. 2018. A novel approach to single camera, glint-free 3D eye model fitting including corneal refraction. In Proceedings of the 2018 ACM Symposium on Eye Tracking Research & Applications, 1–9.
Fuhl, W.; Gao, H.; and Kasneci, E. 2020. Neural networks for optical vector and eye ball parameter estimation. In ACM Symposium on Eye Tracking Research and Applications, 1–5.
Fuhl, W.; and Kasneci, E. 2020. Learning to validate the quality of detected landmarks. In Twelfth International Conference on Machine Vision (ICMV 2019), volume 11433, 97–104. SPIE.
Fuhl, W.; Kasneci, G.; Rosenstiel, W.; and Kasneci, E. 2020. Training decision trees as replacement for convolution layers. In Proceedings of the AAAI Conference on Artificial Intelligence, volume 34, 3882–3889.
Fuhl, W.; Kübler, T.; Sippel, K.; Rosenstiel, W.; and Kasneci, E. 2015. Excuse: Robust pupil detection in real-world scenarios. In Computer Analysis of Images and Patterns: 16th International Conference, CAIP 2015, Valletta, Malta, September 2-4, 2015, Proceedings, Part I 16, 39–51. Springer.
Fuhl, W.; Santini, T.; Geisler, D.; Kübler, T.; Rosenstiel, W.; and Kasneci, E. 2016a. Eyes wide open? Eyelid location and eye aperture estimation for pervasive eye tracking in real-world scenarios. In Proceedings of the 2016 ACM International Joint Conference on Pervasive and Ubiquitous Computing: Adjunct, 1656–1665.
Fuhl, W.; Santini, T. C.; Kübler, T.; and Kasneci, E. 2016b. Else: Ellipse selection for robust pupil detection in real-world environments. In Proceedings of the Ninth Biennial ACM Symposium on Eye Tracking Research & Applications, 123–130.
Fuhl, W.; Schneider, J.; and Kasneci, E. 2021. 1000 pupil segmentations in a second using haar like features and statistical learning. In Proceedings of the IEEE/CVF International Conference on Computer Vision, 3466–3476.
Halır, R.; and Flusser, J. 1998. Numerically stable direct least squares fitting of ellipses. In Proc. 6th International Conference in Central Europe on Computer Graphics and Visualization. WSCG, volume 98, 125–132. Citeseer.
Han, S. Y.; Kwon, H. J.; Kim, Y.; and Cho, N. I. 2020. Noise-robust pupil center detection through CNN-based segmentation with shape-prior loss. IEEE Access, 8: 64739–64749.
He, K.; Zhang, X.; Ren, S.; and Sun, J. 2016. Deep residual learning for image recognition. In Proceedings of the IEEE Conference on Computer Vision and Pattern Recognition, 770–778.
Kim, J.; Stengel, M.; Majercik, A.; De Mello, S.; Dunn, D.; Laine, S.; McGuire, M.; and Luebke, D. 2019. NVGaze: An anatomically-informed dataset for low-latency, near-eye gaze estimation. In Proceedings of the 2019 CHI Conference on Human Factors in Computing Systems, 1–12.
Lu, C.; Chakravarthula, P.; Liu, K.; Liu, X.; Li, S.; and Fuchs, H. 2022. Neural 3D gaze: 3D pupil localization and gaze tracking based on anatomical eye model and neural refraction correction. In 2022 IEEE International Symposium on Mixed and Augmented Reality (ISMAR), 375–383. IEEE.
Lu, F.; Sugano, Y.; Okabe, T.; and Sato, Y. 2015. Gaze estimation from eye appearance: A head pose-free method via eye image synthesis. IEEE Transactions on Image Processing, 24(11): 3680–3693.
Mirikharaji, Z.; and Hamarneh, G. 2018. Star shape prior in fully convolutional networks for skin lesion segmentation. In Medical Image Computing and Computer Assisted Intervention – MICCAI 2018: 21st International Conference, Granada, Spain, September 16-20, 2018, Proceedings, Part IV 11, 737–745. Springer.
Ronneberger, O.; Fischer, P.; and Brox, T. 2015. U-net: Convolutional networks for biomedical image segmentation. In Medical Image Computing and Computer-Assisted Intervention – MICCAI 2015: 18th International Conference, Munich, Germany, October 5-9, 2015, Proceedings, Part III 18, 234–241. Springer.
Schnieders, D.; Fu, X.; and Wong, K.-Y. K. 2010. Reconstruction of display and eyes from a single image. In 2010 IEEE Computer Society Conference on Computer Vision and Pattern Recognition, 1442–1449. IEEE.
Siegfried, R.; and Odobez, J.-M. 2022. Robust unsupervised gaze calibration using conversation and manipulation attention priors. ACM Transactions on Multimedia Computing, Communications, and Applications (TOMM), 18(1): 1–27.
Świrski, L.; Bulling, A.; and Dodgson, N. 2012. Robust real-time pupil tracking in highly off-axis images. In Proceedings of the Symposium on Eye Tracking Research and Applications, 173–176.
Świrski, L.; and Dodgson, N. A. 2013. A fully-automatic, temporal approach to single camera, glint-free 3D eye model fitting. Proceedings of ECEM, 2013.
Topal, C.; and Akinlar, C. 2012. Edge drawing: A combined real-time edge and segment detector. Journal of Visual Communication and Image Representation, 23(6): 862–872.
Wood, E.; Baltrušaitis, T.; Morency, L.-P.; Robinson, P.; and Bulling, A. 2016. Learning an appearance-based gaze estimator from one million synthesised images. In Proceedings of the Ninth Biennial ACM Symposium on Eye Tracking Research & Applications, 131–138.
Wu, P.; Chen, S.; and Metaxas, D. N. 2020. Motionnet: Joint perception and motion prediction for autonomous driving based on bird's eye view maps. In Proceedings of the IEEE/CVF Conference on Computer Vision and Pattern Recognition, 11385–11395.
Yeung, M.; Sala, E.; Schönlieb, C.-B.; and Rundo, L. 2022. Unified focal loss: Generalising dice and cross entropy-based losses to handle class imbalanced medical image segmentation. Computerized Medical Imaging and Graphics, 95: 102026.
Zhang, X.; Park, S.; Beeler, T.; Bradley, D.; Tang, S.; and Hilliges, O. 2020. ETH-XGaze: A large scale dataset for gaze estimation under extreme head pose and gaze variation. In Computer Vision – ECCV 2020: 16th European Conference, Glasgow, UK, August 23–28, 2020, Proceedings, Part V 16, 365–381. Springer.
Zhang, X.; Sugano, Y.; Fritz, M.; and Bulling, A. 2017. MPIIGaze: Real-world dataset and deep appearance-based gaze estimation. IEEE Transactions on Pattern Analysis and Machine Intelligence, 41(1): 162–175.
本文:
本文是否做出理论贡献?(yes/no)若是,请完成以下列表:
本文是否依赖一个或多个数据集?(yes/no)若是,请完成以下列表:
本文是否包含计算实验?(yes/no)若是,请完成以下列表:
本章是译者面向本站关注的座舱感知 / DMS 工程项目的评估,不属于原文。
先把边界划清楚,避免浪费时间:
headline 修正量其实很小。表 1 里 U-ResAtt(EFE)对 base UNet 的提升是 90.27 对 89.59,即 +0.68 个百分点;形状先验的另一个版本 UNet (Convex Shape) 也有 89.78。也就是说 EFE 正则相对已有形状先验方法的净增益约 0.5 个百分点,正文"显著提升"的表述与表格之间有落差。
"更低计算复杂度"只在 W1 成立。表 3 中所有基线 W1 执行时间清一色 5.00 秒、GVnet 3.93 秒;但 W10/W20 下 NN50BR(0.34/0.32 秒)比 GVnet(1.01/0.75 秒)快 2–3 倍,误差只差 0.3–0.08 度。结论段"以更低计算复杂度实现更小误差"是对整表的选择性阅读。
CoordTransNet 的公式有疑似笔误,且无处核对。伪代码第一分支 δ′Ox = δ′Kx(直接把 K 的比例赋给 O)、第二分支与 else 分支 δ′Oy = δ′Oy(自身恒等)在数学上都讲不通;真正实现在"补充材料代码"里,而补充材料与项目页均为占位符。
表 2 的消融对象不明。"不含 CoordTransNet 7.20 / CoordTransNet 3.84"没有说明基线是什么(原始注视分布直接拟合?),像素误差在哪套数据上测得,只有一句"消融分析"。
可复现性清单形同虚设。勾选项无法分辨,而正文反复出现的"参见补充材料"(数据集细节、实验细节、CoordTransNet 实现)在当前版本全部不可获取——这是评估该文可信度时最大的折扣项。