分心驾驶是交通致死的主要原因之一,约占全部致死案例的 30%,2023 年夺走 3,275 条生命 [NHTSA, 2023];它还造成巨额财产损失,仅直接的道路基础设施与养护成本就达 98 亿美元 [NHTSA, 2025]。除经济负担外,分心驾驶还对执法与医疗资源造成沉重压力。因此,及时研究驾驶员分心检测问题至关重要。
驾驶中的分心可分为三类:手动、视觉与认知分心 [Kashevnik 等, 2021]:(i) 手动分心:驾驶员的手离开方向盘(如拿着手机或食物);(ii) 视觉分心:视线离开风挡与后视镜覆盖的注意区域(如看导航);(iii) 认知分心:注意力被与驾驶无关的想法占用(如盯着一点却在想无关的事),即使视线仍在路面上。手动与视觉分心已被广泛研究,而认知分心因其隐性、不可直接观测而长期欠探索 [Guo 等, 2024]。三类分心的详细讨论见附录 A.1。
认知分心体现在驾驶员随时间变化的内部心理状态中,很难仅凭外部行为直接检测:即使驾驶员目视前方、手握方向盘,认知分心仍可能发生。现有方法大多依赖侵入式手段——需要给驾驶员佩戴生理传感器或打断正常驾驶。例如脑电(EEG)能提供精确的神经信号,但需要传感器与身体的物理耦合 [Li 等, 2023];自我报告问卷可评估驾驶员对驾驶环境的主观感知 [Cooper 等, 2014],检测响应任务(DRT)常用于测其对意外事件的反应时 [Al-Mekhlafi 等, 2024]。这些方法会干扰正常驾驶,且只能做事后评估,难以持续使用。因此,一个关键研究问题是:如何设计一种不干扰驾驶、能随时间持续检测认知分心的非侵入式方法?
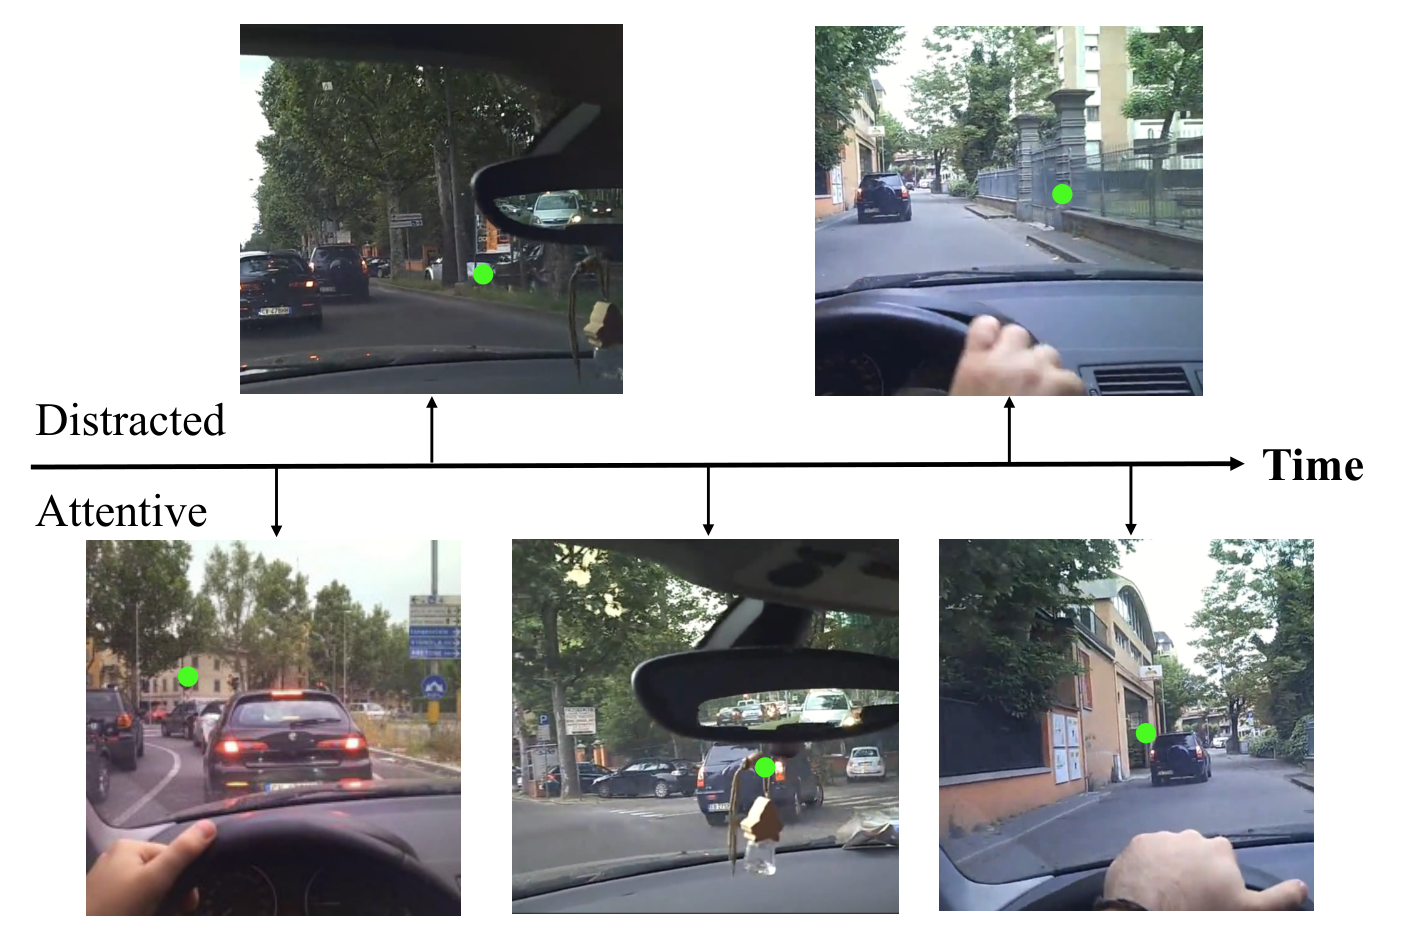
为回答该问题,我们利用眼动注视作为理解驾驶员认知状态的行为线索——注视反映内部认知过程对注意力的分配 [Oyama 等, 2019]。而且,随着 Meta Aria Gen 2 等轻量级 AR 眼镜的普及,实时眼动数据可以以非侵入方式采集,无需用户额外付出 [Engel 等, 2023]。然而,仅靠眼动数据不足以检测认知分心,因为它缺乏场景上下文 [Zhou 等, 2025]:同一注视模式在不同驾驶场景下可能对应不同的认知状态。如图 1 所示,第一个专注案例中,驾驶员在等红灯时注视信号灯;第一个分心案例中,驾驶员在直行时盯着路边的停放车辆。这自然引出一个多模态视角:同时使用眼动注视与场景上下文,解读驾驶过程中注意力的时间分配。
为此,我们希望通过分析随时间变化的眼动模式与注意的视觉目标(第一视角视频 captures 驾驶场景的时空结构 [Zhou 等, 2024])来推断驾驶员认知状态。具体地,我们利用一个关键洞察:检测认知分心需要理解驾驶员的视线如何随时间与周围第一视角视觉场景交互。这种交互既体现在一段驾驶片段上(全局交互),也体现在每一帧内(细粒度交互)。尽管洞察清晰,缺乏适合建模这种交互的高质量数据集仍是挑战——同时提供眼动信息、第一视角驾驶视频与认知分心标注的数据集极为稀缺,根本原因是采集与标注困难。由此产生三个关键挑战:(C1) 如何分别从第一视角视频与眼动数据中学习全局与细粒度特征?(C2) 如何将眼动信息与第一视角视频融合以检测认知分心?(C3) 缺乏可扩展、可泛化的认知分心数据集。
针对 C1 与 C2,我们提出 EyeCue——一个将时间眼动与第一视角视频结合的非侵入式框架。它由三个核心组件构成:(i) 视频编码器:处理每段视频片段,理解驾驶员周围上下文;(ii) 注视编码器:分析眼动数据,提取驾驶员的注视模式;(iii) 注视驱动语义查询(GDSQ)模块:利用注视线索从第一视角视频中动态选取视觉 token,反映注视随时间在场景上的分配。最后融合三者输出进行认知分心检测。
针对 C3,DR(eye)VE 是唯一同时包含眼动、第一视角视频与认知分心标签的公开数据集 [Palazzi 等, 2018],但其场景覆盖有限、分心样本可能不足。因此我们另选三个既有驾驶数据集(连同 DR(eye)VE)构建 CogDrive:选取同样提供注视数据与第一视角视频的 BDD-A [Xia 等, 2018]、DADA-2000 [Fang 等, 2021] 与 TrafficGaze [Deng 等, 2019],沿用 DR(eye)VE 的标注流程,构建出含 3,662 个认知分心标注样本的更大规模数据集。
据我们所知,EyeCue 是首个将时间眼动信息与第一视角视频结合检测驾驶员认知分心的工作。主要贡献:
驾驶员分心检测。分心三分为手动、视觉与认知 [Kashevnik 等, 2021]。针对手动与视觉分心,近期方法多用车内摄像头检测可观测的肢体动作 [Sonth 等, 2023]。而认知分心体现于心理状态,多数研究转向侵入式手段测认知负荷,例如 Figalová 等 [2023] 用问卷评估驾驶员认知状态——但会干扰驾驶。这促使我们设计非侵入式检测方法。
基于注视的分析技术。驾驶员注视线索对注意力评估很有价值 [Huang 等, 2025]。Maralappanavar 等 [2016] 用瞳孔估计驾驶员状态,但缺失环境上下文;Zhou 等 [2025] 预测驾驶员注视区域并生成解释文本;Bhagat 等 [2023] 发现注视模式与显著性随驾驶任务变化;近期 DCDD 结合单帧与眼动数据做分心检测 [Qiao 等, 2025],但缺少时间维度的注意力建模。
视频理解模型。此类模型可理解驾驶过程中驾驶员感知的上下文 [Min 等, 2024]:TimeSformer [Bertasius 等, 2021] 与 VideoMAE [Tong 等, 2022] 捕捉视觉内容的时空关系;视频基础模型与文本等模态结合后推理能力更强 [Wang 等, 2024]。这启发我们把眼动与视频理解模型结合。
注视增强的视觉模型。现有多模态模型证明了"注视+视觉"的优势:Voila-A [Yan 等, 2024] 与 GazeGPT [Konrad 等, 2024] 用注视帮助视觉模型识别用户关注的物体;GazeLLM 只取注视区域以降低计算量 [Rekimoto, 2025];Egovideo 利用第一视角视频增强感知 [Pei 等, 2024]。但它们面向图像中的视觉内容,而非视频中的第一人称状态理解。近期 egoEmotion 把眼动视为反映人的状态的关键感知模态 [Jammot 等, 2025]。受此启发,我们设计了融合眼动与第一视角视频的驾驶员认知分心检测方法。
安全驾驶研究表明,驾驶员的感知体现在其随时间对不同物体的注意力分配上 [Du 等, 2020]。Musabini 与 Chetitah [2020] 发现正常驾驶时驾驶员注视大范围环境区域,而认知分心时注意力局限于特定区域;Ojstersek 与 Topolšek [2019] 观察到驾驶员会在不同场景注视不同物体以维持专注。由此得到本文的核心洞察:
(C1)如何从第一视角与眼动中同时学习全局与细粒度特征?全局特征帮助把握整段视频的环境与注视总体信息;细粒度特征揭示每时刻的场景物体与注视模式。二者处于不同时空尺度,需要分别建模两种模态的两类特征。
(C2)如何将注视信息与第一视角视频融合?需利用注视理解驾驶员如何感知环境:例如等红灯时视线从信号灯移向行人——应把注视与视频表征融合,捕捉驾驶员对场景各区域的注意。如何有效整合仍是主要挑战。
(C3)缺乏可扩展、可泛化的数据集。目前 DR(eye)VE 是唯一同时提供第一视角驾驶视频、眼动与认知分心标签的数据集,但采集场景与地域受限,泛化性不足;且认知分心是隐性的,没有具体协议就难以可靠标注。
设计目标。基于驾驶员第一视角视频得到预处理后的片段序列 F 与时间对齐的注视坐标序列 C,任务形式化为二分类:预测驾驶员处于认知分心或专注状态。
架构总览。如图 2,EyeCue 包含三个核心组件:针对 C1,两个模态专用编码器——(i) 视频编码器提取第一视角视频的全局与细粒度时空特征,(ii) 注视编码器建模全局注视模式与帧级注视动态;针对 C2,引入 (iii) GDSQ 模块建模注视与场景的交互。最后把视频类别 token、注视类别 token 与语义类别 token 拼接,送入多层感知机(MLP)分类。
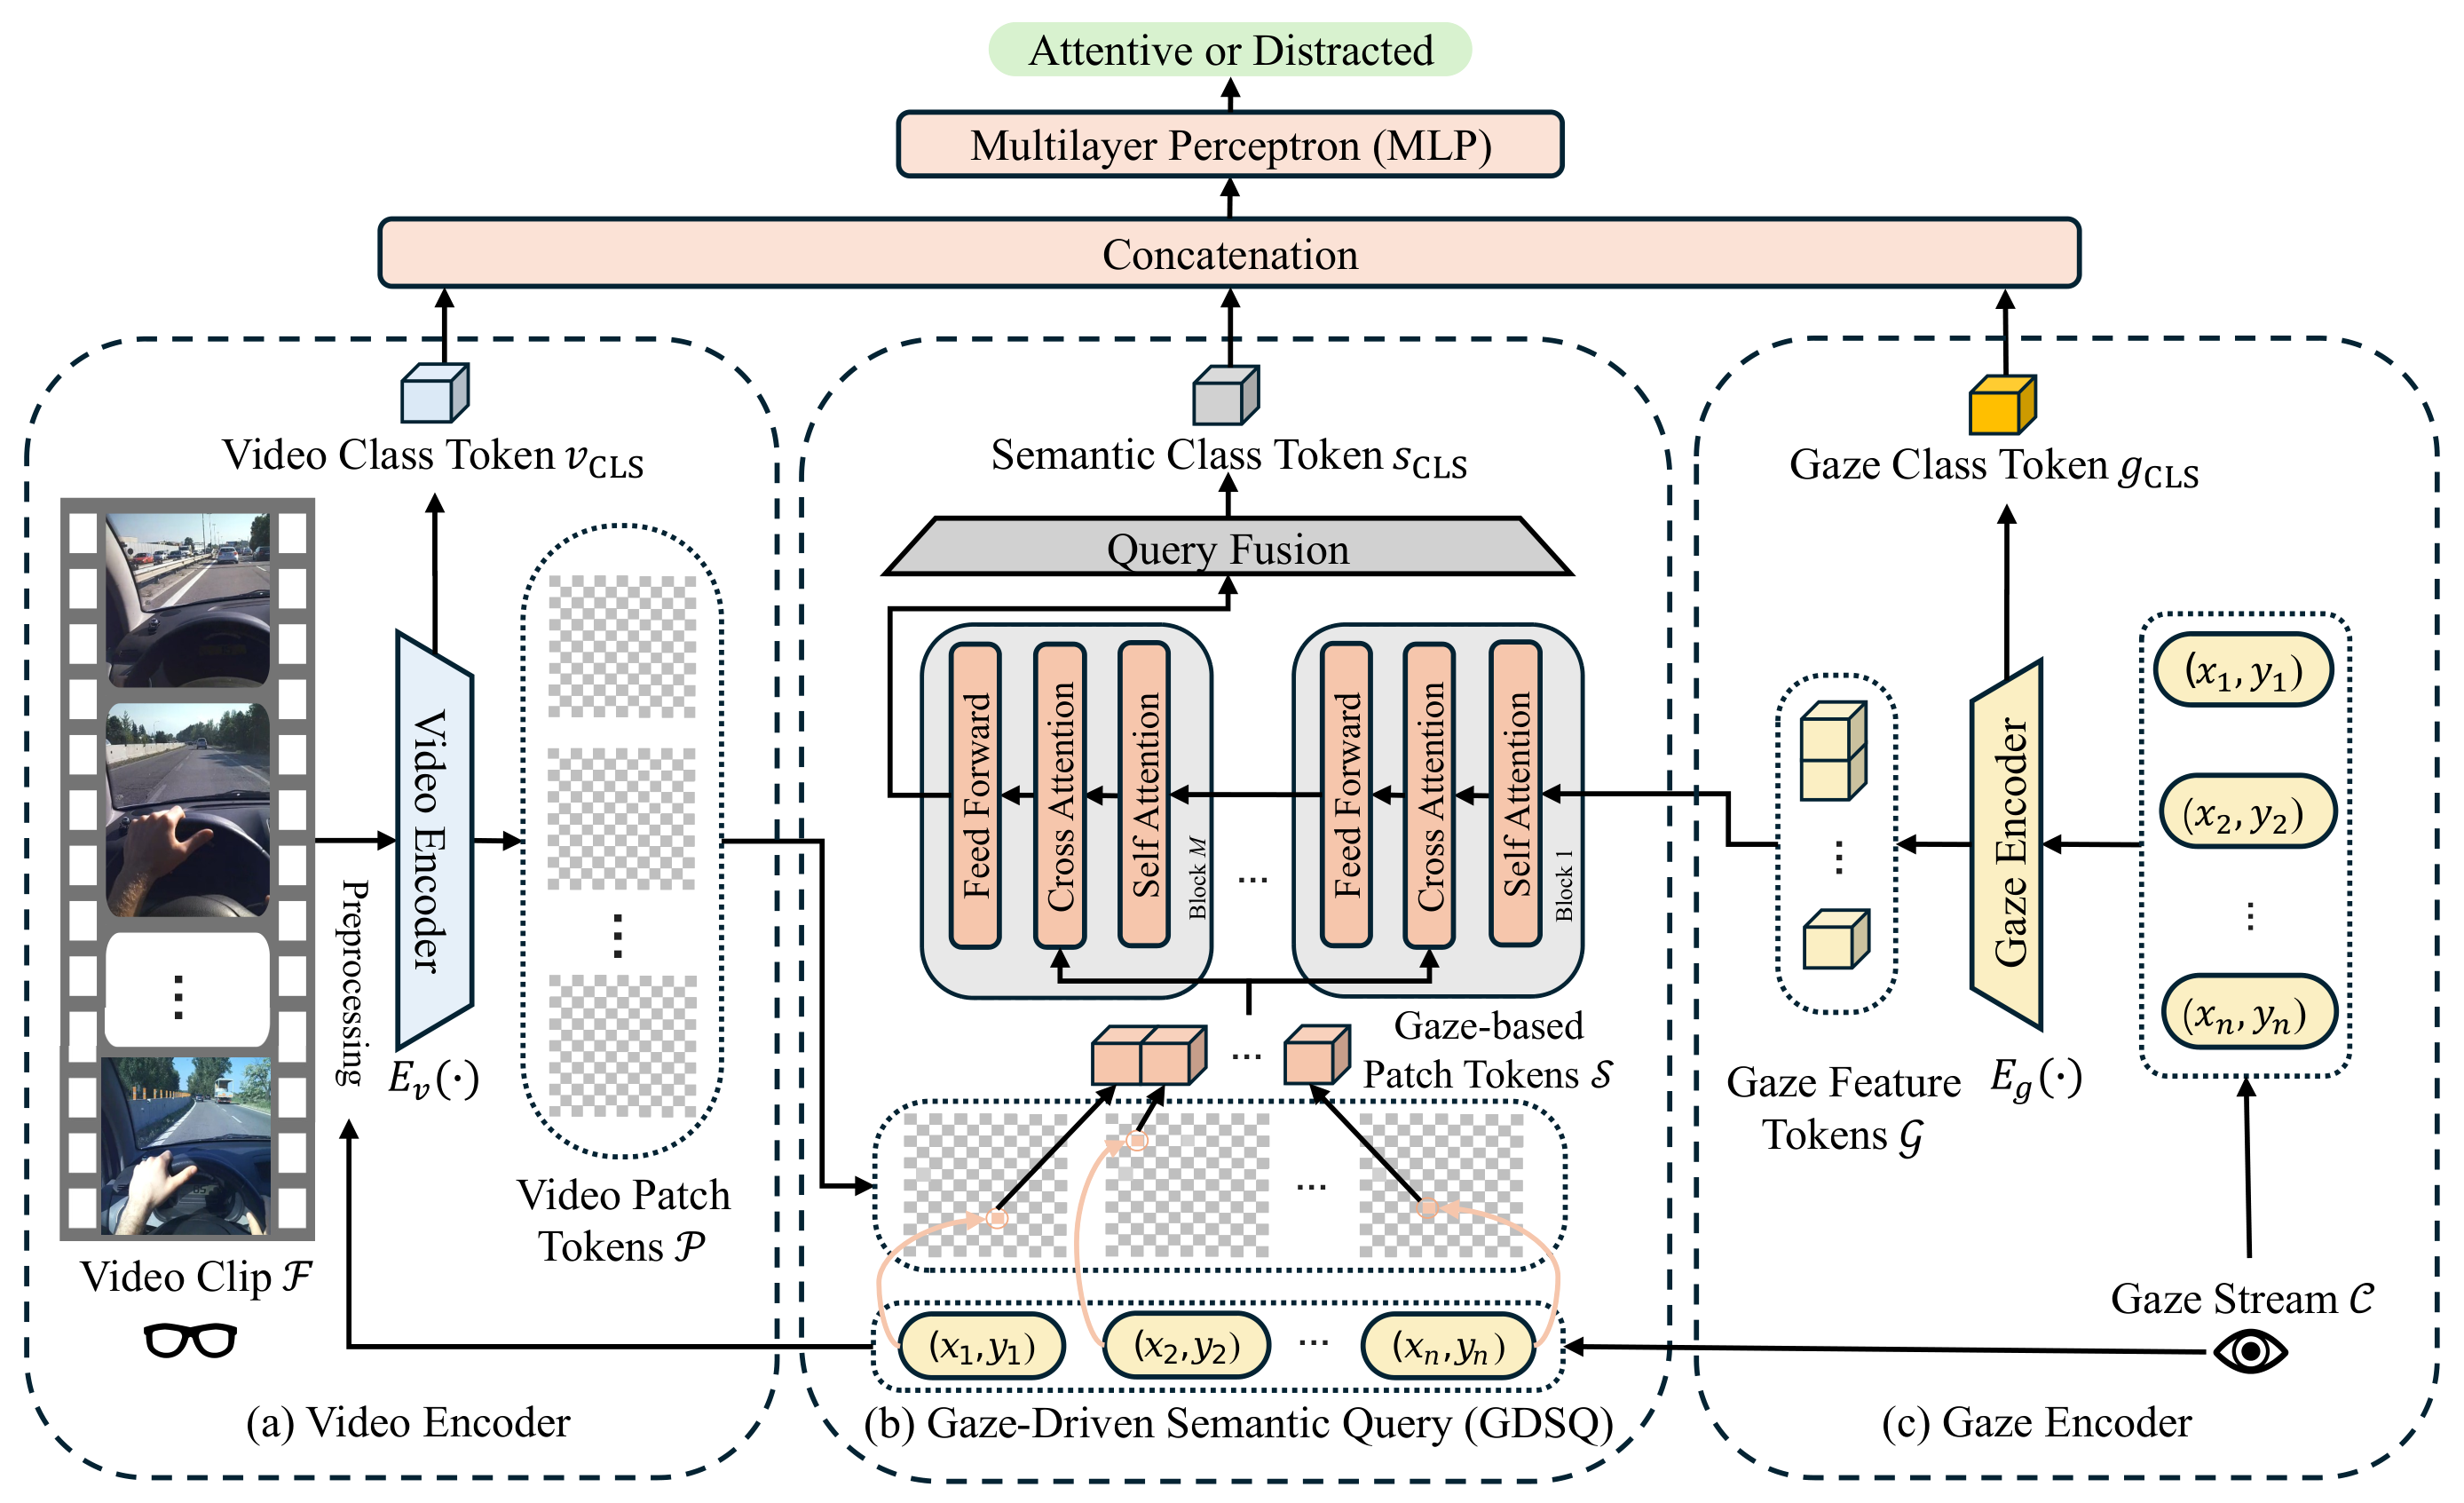
在 EyeCue 中,注视信息有三种用法:其一,在视频编码器中引导视频预处理,突出驾驶员注意的区域;其二,注视编码器同时建模整段片段的全局注意模式与帧级注视动态;其三,GDSQ 通过注视引导的图块选择与交叉注意力对齐注视与细粒度视觉内容。
视频编码器。给定含 n 帧的第一视角片段,先用基于注视的视频预处理(圆点叠加、热力图掩码、裁剪帧)增强输入(记预处理后片段为 F)。再用预训练视频编码器 Ev(·) 提取驾驶场景的丰富时空表征 [Bertasius 等, 2021];我们偏好能在帧内细粒度区域提取特征的编码器。编码器输出单个视频类别 token vCLS 与图块 token 序列 P := {pi}i=1..l(l 为图块 token 总数):vCLS 学习驾驶环境的全局表征;每帧切成多个图块,每个图块编码为一个 token,表征该小区域的细粒度特征。
注视编码器。(xt, yt) 为帧 ft 中对齐的注视坐标。先经可学习线性层把每个注视坐标投影到与视频图块 token 相同的嵌入空间,得到嵌入坐标 token 序列;再加入类别 token,送入定制的轻量 Transformer 编码器 [Vaswani 等, 2017],得到注视类别 token gCLS 与注视特征 token 序列 G := {gt}t=1..n:gCLS 汇总整段片段的注视模式,G 的各 token 捕捉帧级注视模式。
注视驱动语义查询(GDSQ)。该模块把驾驶员注视与第一视角视频整合,是"视线—场景"交互建模的关键,目标是提取驾驶员的视觉感知特征。首先把注视点投影到帧内对应区域,选取该区域周边的 h 个视频图块 token:每帧可只选注视点所在的单个图块(h=1),或包含周边区域的多个图块(h>1);选择策略见附录 A.2。对所有帧重复该操作,共得 h×n 个基于注视的图块 token,记 S := {sm}m=1..h·n。
为捕捉帧级的注视—环境交互,把注视特征 token G 与基于注视的图块 token S 送入交叉注意力模块。直觉是:驾驶员用视线"感知并查询"周围环境——因此以 G 为查询(Query),S 为键(Key)与值(Value)。交叉注意力块重复 M 次以迭代精炼注视与环境特征的关系;对第 M 块输出做池化,得到语义类别 token sCLS,表征驾驶员与场景的整体交互。最后拼接 vCLS、sCLS、gCLS 三个类别 token,送入 MLP 预测是否认知分心。
模型配置。视频编码器评估两个预训练骨干:TimeSformerK600 [Bertasius 等, 2021] 与 VideoMAEK400 [Tong 等, 2022]。注视编码器为 8 头注意力、1 层编码块的 Transformer;GDSQ 含 2 个交叉注意力块(M=2),后接两层 MLP。超参按经验选择,轻量配置已能取得强性能;视频编码器选型讨论见附录 A.2。
基线。6 个家族 11 个基线:(i) 纯注视:Heatmap-based SVM [Musabini 与 Chetitah, 2020];(ii) 经典骨干:TimeSformer、VideoMAE;(iii) 第一视角视频理解:EgoVideo [Pei 等, 2024];(iv) 视频基础模型:InternVideo2 [Wang 等, 2024]、Video-LLaVA [Lin 等, 2023]、VideoLLaMA3 [Zhang 等, 2025];(v) 注视+图像:GazeGPT [Konrad 等, 2024]、Voila-A [Yan 等, 2024];(vi) 注视+视频:GazeVQA [Ilaslan 等, 2023]、GazeLLM [Rekimoto, 2025]。
训练与推理。NVIDIA L40S GPU 上训练推理:微调视频编码器,注视编码器与 GDSQ 从头训练 15 轮,其余配置沿用视频编码器默认设置。所有可训练基线都在 CogDrive 上微调以公平对比;免训练方法(如 GazeGPT、GazeLLM)不微调直接评估。语言模型的 prompt 设计见附录 A.2。可训练基线取 5 次运行平均,免训练模型评估 1 次。
针对 C3,我们整合四个既有驾驶视频数据集构建 CogDrive:DR(eye)VE、BDD-A、DADA-2000、TrafficGaze——选择它们是因为同时提供注视与第一视角视频。我们沿用由 DR(eye)VE 标签导出、经领域专家指导的统一协议(详细流程见附录 A.3),按"注视—场景交互"定义专注与分心判据;所有片段由两名标注者独立标注、领域专家复核,标注者间一致性超过 98%。鉴于认知分心片段通常较短,视频统一切为 16 帧定长片段。
| 数据集 | 专注 | 分心 | 总数 |
|---|---|---|---|
| DR(eye)VE | 1,485 (78.41%) | 409 (21.59%) | 1,894 |
| BDD-A | 424 (66.88%) | 210 (33.12%) | 634 |
| DADA-2000 | 463 (73.84%) | 164 (26.16%) | 627 |
| TrafficGaze | 481 (94.87%) | 26 (5.13%) | 507 |
| CogDrive | 2,853 (77.91%) | 809 (22.09%) | 3,662 |
片段级统计。表 1 报告 CogDrive 统计:共 3,662 个片段,含 2,853 个专注与 809 个分心样本;各源数据集中专注片段均占多数,符合现实。训练使用全部 809 个分心片段,并按各子数据集分布随机选取 809 个专注片段,再按 70%/30% 划分训练/测试。
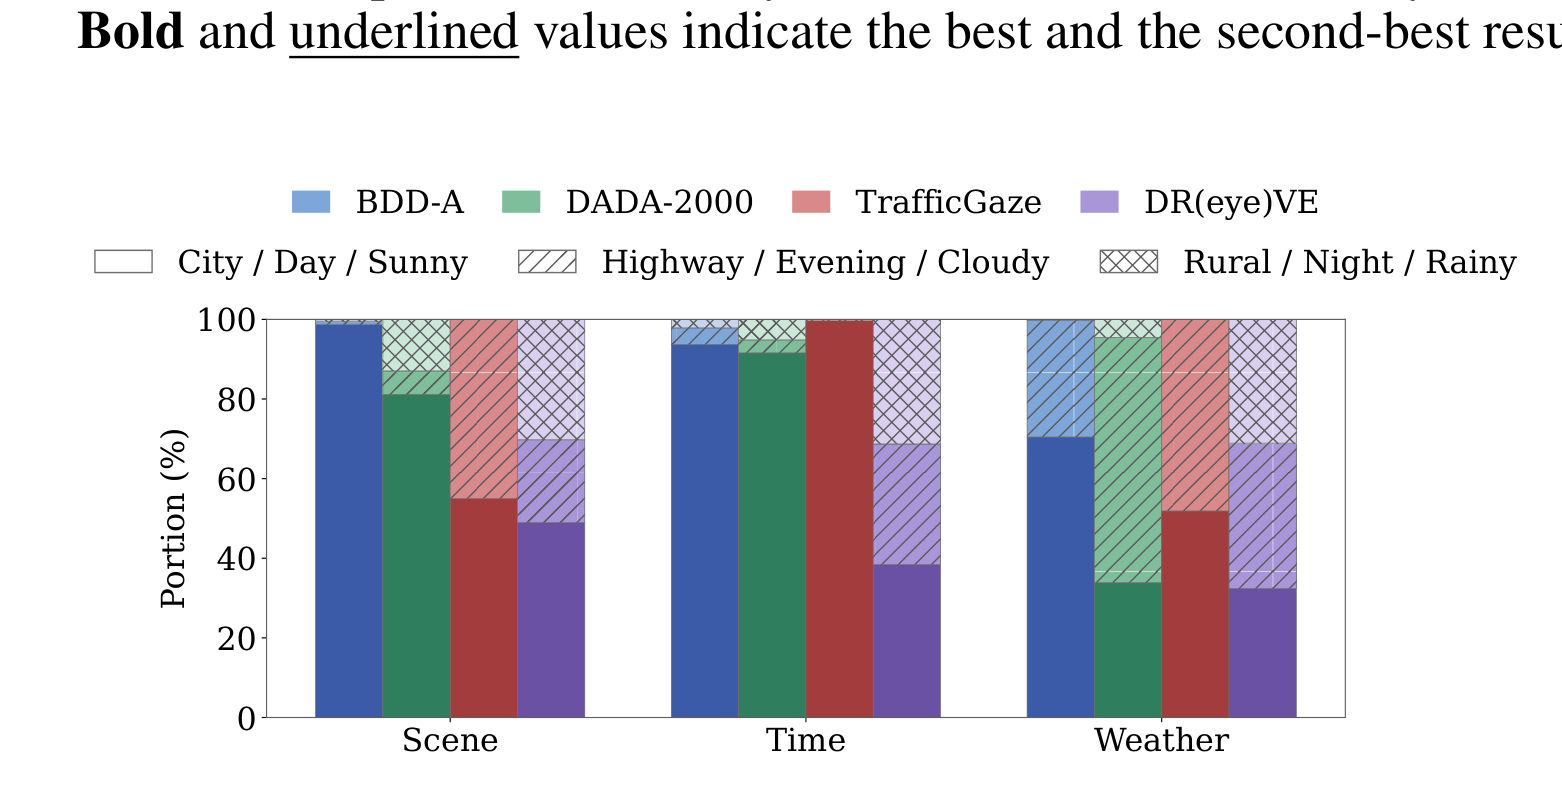
场景维分布。图 3 展示 CogDrive 在道路类型、时段、天气三个互补条件下的片段分布,既呈现数据集内部构成,也呈现跨数据集异质性。
对比研究。表 2 报告 EyeCue 与 11 个基线在完整 CogDrive 及其子数据集上的准确率与 F1(分心类)。采用留一数据集法(leave-one-dataset-out)评估跨数据集泛化(如评估 BDD-A 时,在 DADA-2000、DR(eye)VE、TrafficGaze 上训练)。因类别严重不平衡,TrafficGaze 不做留一评估。总体上 EyeCue 在所有设置下最优:完整 CogDrive 上,采用 TimeSformerK600 骨干的 EyeCue 取得最高 74.38% 准确率与 0.74 F1;留一设置下同样泛化良好。值得注意的是,训练集包含 DR(eye)VE 的模型泛化更好,说明 DR(eye)VE 为认知分心建模提供了更有信息量的样本。相比之下,纯注视、经典视频、第一视角、视频基础模型与注视+视觉方法都更差——说明仅靠时空视觉建模或仅靠注视线索都不够。结果凸显了建模视线—场景交互的重要性与 EyeCue 的泛化能力。
| 方法 | 骨干 | BDD-A Acc. / F1 | DADA-2000 Acc. / F1 | DR(eye)VE Acc. / F1 | CogDrive 总体 Acc. / F1 | |
|---|---|---|---|---|---|---|
| 纯注视 | Heatmap-based | SVM | 61.95 / 0.57 | 65.85 / 0.64 | 49.39 / 0.14 | 66.12 / 0.64 |
| 经典 | TimeSformerK400 | ViT-B/16 | 60.71 / 0.62 | 62.63 / 0.63 | 55.40 / 0.55 | 65.35 / 0.70 |
| TimeSformerK600 | ViT-B/16 | 60.52 / 0.67 | 61.89 / 0.53 | 55.41 / 0.61 | 66.80 / 0.71 | |
| VideoMAEK400 | ViT-B/16 | 57.38 / 0.62 | 61.28 / 0.60 | 58.85 / 0.64 | 67.21 / 0.66 | |
| 第一视角 | EgoVideo | ViT-B/14 | 58.57 / 0.65 | 59.15 / 0.63 | 55.65 / 0.56 | 65.29 / 0.68 |
| 基础模型 | InternVideo2S1-1B | ViT-B/14 | 50.16 / 0.45 | 50.51 / 0.45 | 59.31 / 0.58 | 56.61 / 0.53 |
| Video-LLaVA | OpenCLIP-L/14 | 52.43 / 0.37 | 52.09 / 0.47 | 53.75 / 0.51 | 55.06 / 0.55 | |
| VideoLLaMA3 | ViT-B/16 | 54.86 / 0.47 | 53.26 / 0.38 | 51.17 / 0.39 | 53.17 / 0.45 | |
| 注视+图像 | GazeGPT∗ | GLM-4.5V-AWQ | 51.00 / 0.47 | 51.81 / 0.53 | 51.29 / 0.42 | 51.69 / 0.48 |
| Voila-A | CLIP ViT-L/14 | 58.81 / 0.57 | 67.68 / 0.67 | 54.91 / 0.45 | 62.81 / 0.58 | |
| 注视+视频 | GazeVQA | CLIP ViT-B/32 | 59.15 / 0.49 | 59.45 / 0.47 | 51.97 / 0.65 | 67.77 / 0.68 |
| GazeLLM∗ | Gemini-2.5-Pro | 44.53 / 0.02 | 49.09 / 0.28 | 49.14 / 0.08 | 48.35 / 0.12 | |
| EyeCue(本文) | VideoMAEK400 | ViT-B/16 | 60.95 / 0.59 | 62.50 / 0.62 | 54.67 / 0.62 | 70.83 / 0.68 |
| TimeSformerK600 | ViT-B/16 | 65.24 / 0.71 | 68.29 / 0.68 | 60.20 / 0.67 | 74.38 / 0.74 | |
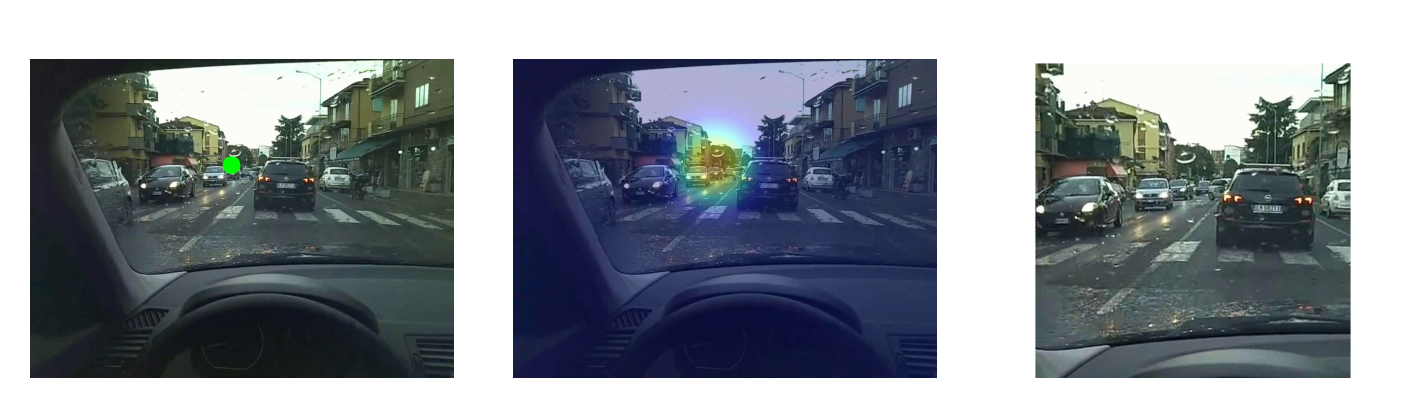
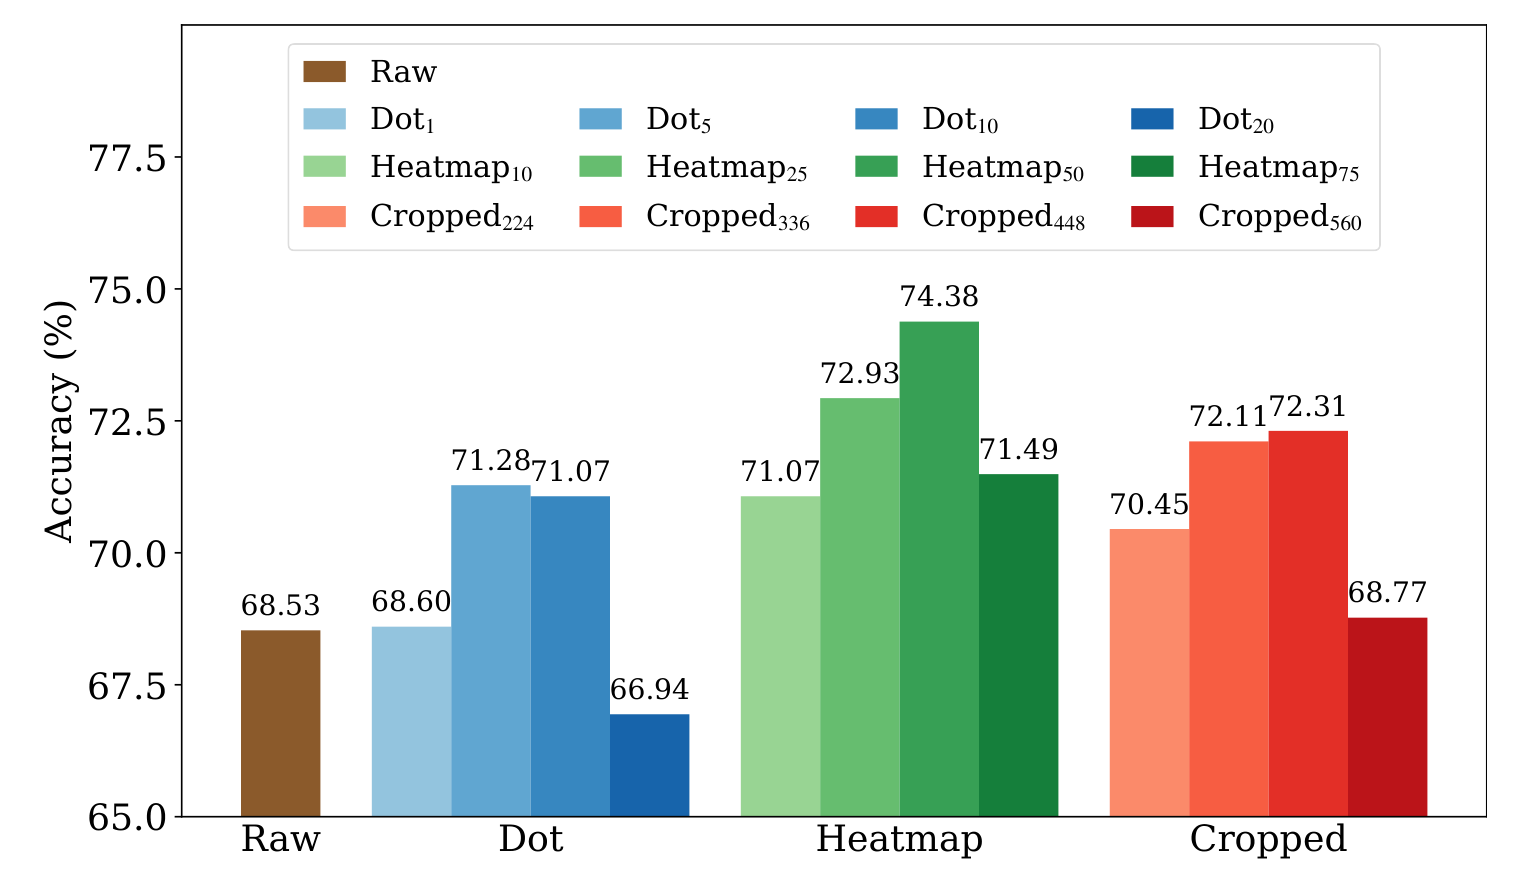
注视引导的视频预处理。除原始视频外,我们探索多种基于注视的预处理策略(图 4):圆点叠加、热力图掩码、注视中心裁剪。如图 5,热力图掩码表现最佳——中等核半径下取得最高准确率,既突出注视区域又保留周边上下文;圆点叠加收益有限,过度显著反而降低准确率;裁剪只在很窄的尺寸区间内有效,体现"局部聚焦 vs 全局上下文"的折中。
超参分析。分析两个关键超参:片段长度与注视图块 token 数。对比 8/16 帧片段,h ∈ {1, 5, 9, 25} 控制每个注视点周边的区域覆盖。如表 3,16 帧 + 每帧单 token(h=1)最高达 74.38%:16 帧的更长时序上下文有益;而增大 h 准确率渐降,h=25 最低。我们将其归因于人类视觉的中央凹(foveated)特性:h=1 时注视中心 token 恰为包含注视点的单个图块,精确对应驾驶员的中央凹视觉焦点;更大的 h 选取周边多图块,使表征超出中央凹范围并在帧间产生空间重叠,稀释了"眼动线索",削弱视线—场景交互。
| 帧数 | h = 1 | h = 5 | h = 9 | h = 25 |
|---|---|---|---|---|
| 8 | 74.09 | 72.93 | 70.04 | 68.60 |
| 16 | 74.38 | 73.35 | 72.11 | 70.04 |
消融实验。分析各组件贡献(表 4):仅注视编码器只有 54.13%,仅视频编码器 67.53%——场景上下文很重要;仅 GDSQ 达 68.80%,说明显式建模注视—场景交互能捕捉有效信息;视频与注视编码器直接融合进一步提升至 72.31%,两模态互补;最终完整模型(直接融合 + GDSQ 交互建模)取得最佳 74.38%。所有含 GDSQ 的设置中,视频与注视编码器都在运行,只是其类别 token 未必参与。
| Gaze | Video | GDSQ | Acc.(%) |
|---|---|---|---|
| ✓ | 54.13 | ||
| ✓ | 67.53 | ||
| ✓ | 68.80 | ||
| ✓ | ✓ | 69.36 | |
| ✓ | ✓ | 70.25 | |
| ✓ | ✓ | 72.31 | |
| ✓ | ✓ | ✓ | 74.38 |
场景分析。表 5 报告 EyeCue 在不同驾驶场景、时段与天气下的分项准确率。乡村场景最可靠——城市驾驶干扰因素更多,单调的高速公路环境则更易走神;夜间准确率更高,可能因为夜间可见物体更少;晴天因视觉质量更好而最高。总体说明模型在多样真实场景中泛化良好。详细失败案例分析见附录 A.4。
| C | H | R | D | E | N | Su | Cl | Ra | |
|---|---|---|---|---|---|---|---|---|---|
| Clips | 368 | 50 | 66 | 366 | 44 | 74 | 253 | 147 | 84 |
| Acc. | 73.64 | 76.00 | 78.79 | 74.32 | 61.36 | 79.73 | 74.70 | 72.79 | 72.62 |
我们提出 EyeCue——一个以非侵入方式检测驾驶员认知分心的注视增强第一视角视频理解模型。通过显式融合眼动与第一视角视频,EyeCue 建模了驾驶员与周围场景的交互;充分实验表明其性能强劲,CogDrive 数据集则为多样驾驶场景下的认知分心研究建立了新基准。尽管如此,EyeCue 仍有局限:其一,用于构建 CogDrive 的附加数据集并非为认知分心分析而设计,认知线索可能欠一致;其二,EyeCue 在复杂驾驶场景与低质量眼动数据下可能失效。解决这些局限将进一步提升真实驾驶场景下的鲁棒性。
伦理声明:本文所有数据均来自公开数据集,未采集新的人类受试者数据;方法仅使用注视坐标作为输入,不涉及虹膜纹理、瞳孔图像等生物特征或其他可识别个人身份的眼部信息。
致谢:感谢弗吉尼亚理工运输研究院(VTTI)对数据标注的支持;本研究受仁荷大学研究基金资助。
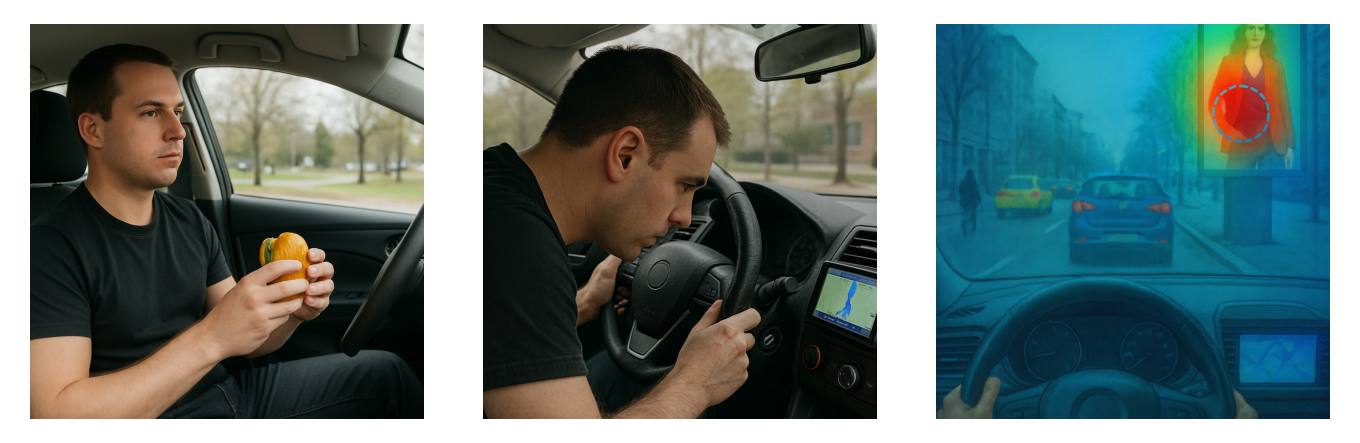
手动分心:驾驶中一只或双手暂时离开方向盘做无关操作(调多媒体、操作导航、拿个人物品等),损害精确控车能力(图 6a)。视觉分心:视线偏离安全驾驶所需注意区域(风挡、后视镜;如看导航屏、看手机、看侧窗风景),削弱对驾驶场景的感知(图 6b)。认知分心:想与驾驶无关的事(聊天、走神),视线虽仍在风挡/后视镜区域,却未指向驾驶任务相关物体,无法分配足够认知注意去感知和解读整体驾驶环境(图 6c:驾驶员盯着广告牌而忽略前车)。三类分心可能同时发生;本文聚焦认知分心。
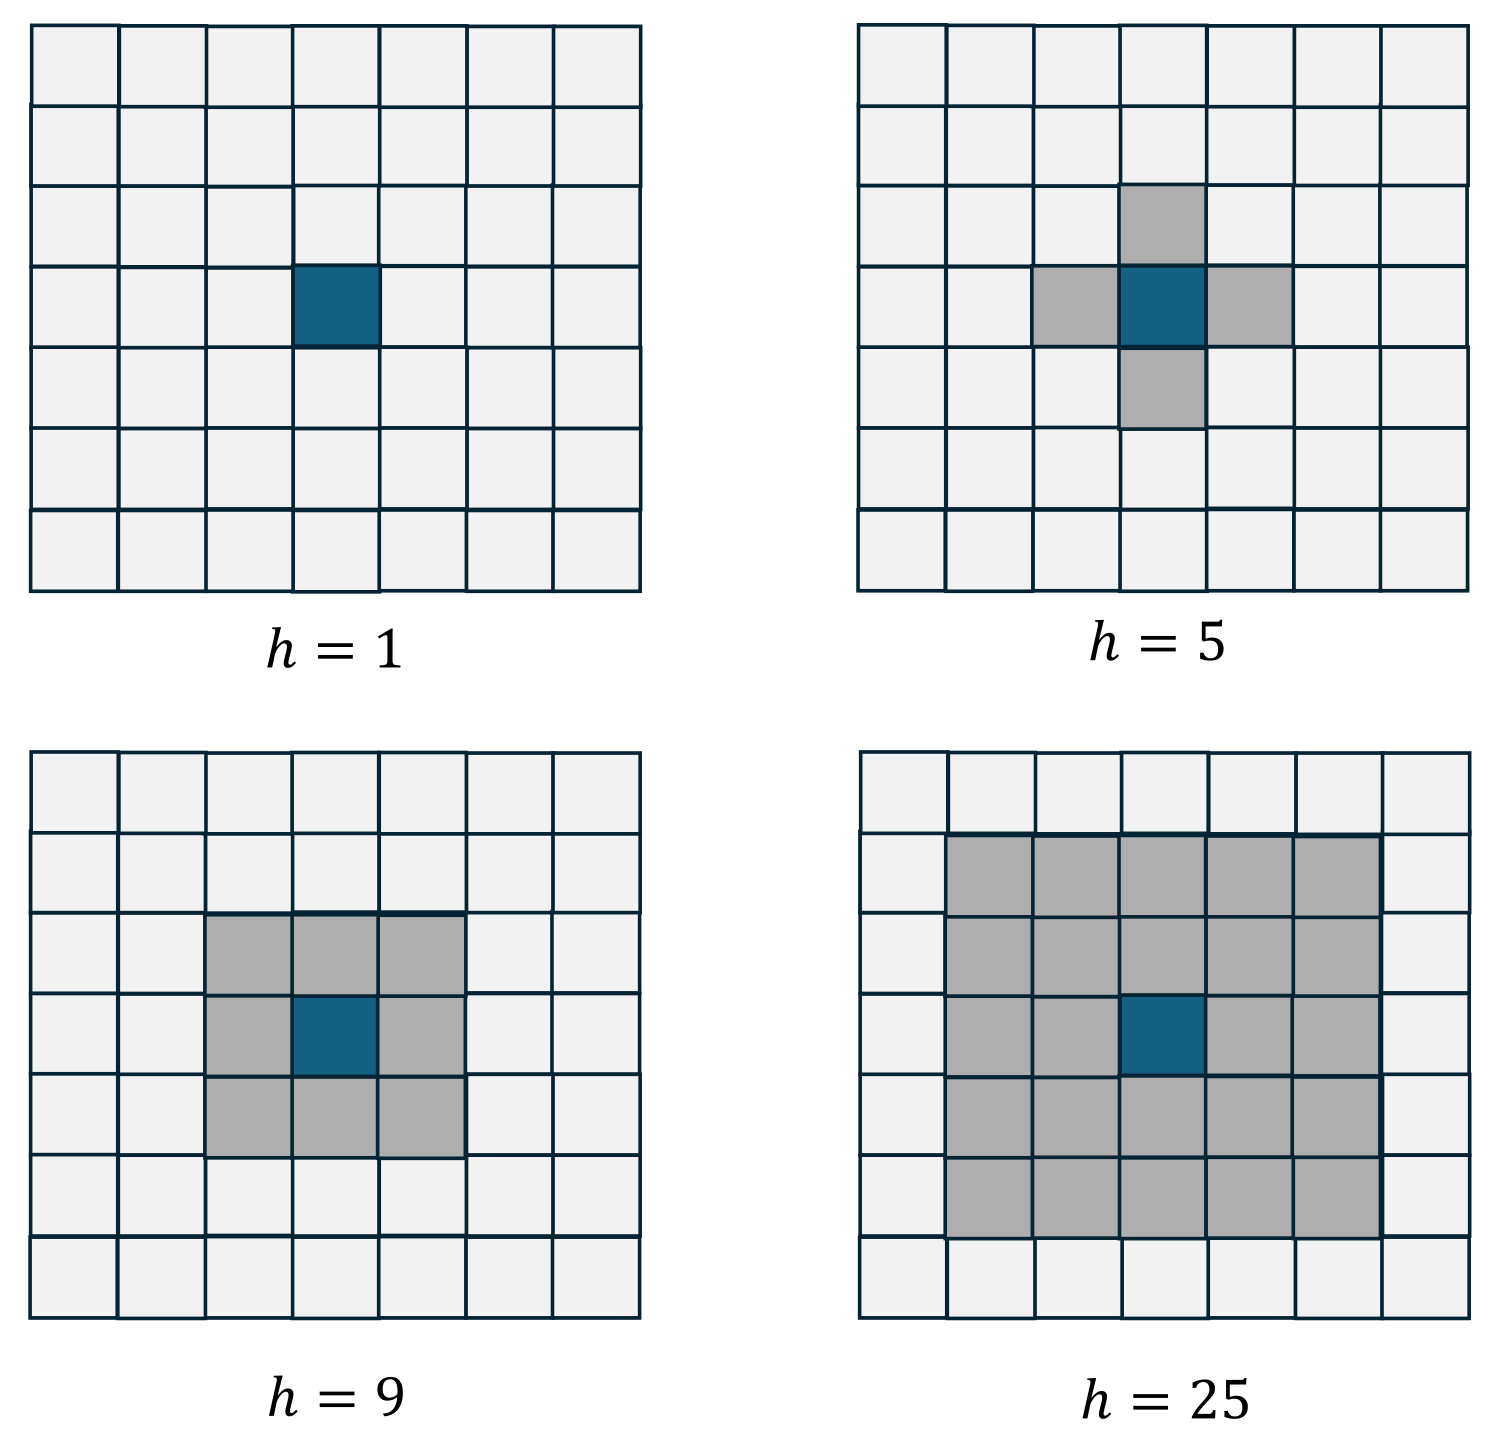
注视图块选择。图 7 展示单帧内如何用注视信息从视频图块 token P 中选取子集:h=1 只选注视点所在图块;h=5 选注视图块加 4 个直接邻居;h=9 选 3×3 邻域;h=25 选 5×5 邻域。
视频骨干选择。适合的编码器对从注视区域捕获上下文至关重要:偏好能生成稠密图块 token 的骨干(TimeSformer、VideoMAE),细粒度 token 可更精确定位注视区域、更好建模视线—场景交互;反之,采用 token 精简或只输出少量汇总 token 的编码器 [Arif 等, 2025; Hao 等, 2025] 会限制细粒度注视表征,可能丢失视线与场景的细节交互。
视频语言模型的 prompt 设计。对所有视频语言模型基线(EgoVideo、InternVideo2、Video-LLaVA、VideoLLaMA3、GazeGPT、Voila-A、GazeVQA、GazeLLM)统一使用:"这是一段记录驾驶员所见的第一视角视频。我在做一项分类任务,判断驾驶员是否分心。分心定义:若驾驶员看向与当前驾驶任务无关的区域或物体,判为分心;若看向与驾驶任务相关的区域或物体,判为专注。若你认为驾驶员不专注,直接输出 1;若专注,直接输出 0。"
数据集。DR(eye)VE 是唯一同时提供同步第一视角视频、眼动信号与认知分心标签的数据集,作为主要参考与协议设计基础;BDD-A、DADA-2000、TrafficGaze 用车顶前视相机采集、无认知标注——BDD-A 采样自大规模驾驶记录的重要时刻,DADA-2000 选取险撞/碰撞片段,TrafficGaze 采集时驾驶员被明确要求保持高度专注。四者覆盖多样工况、视角与注意状态。
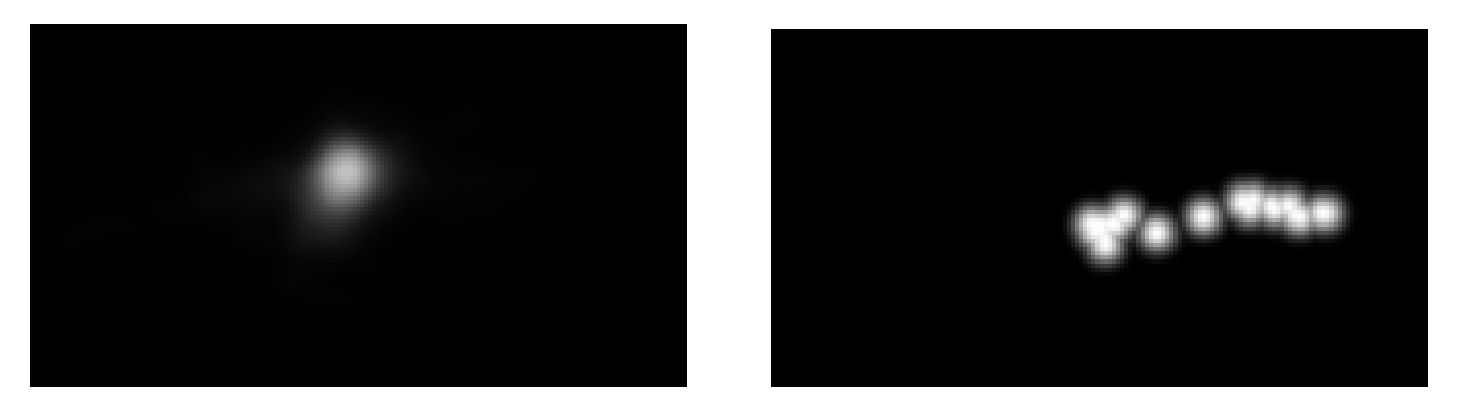
事件片段筛选。DR(eye)VE 直接采用其专家标注。所有原始视频(含 DR(eye)VE)统一切为 16 帧定长片段作为标注单元。对每个原始视频,先聚合全视频眼动计算平均真值注视密度图(图 8a),再对每个 16 帧片段计算其密度图(图 8b);计算片段级密度图与全视频平均图的皮尔逊相关系数(CC),CC < 0.3 的片段被标记为候选事件片段——它们的眼动模式偏离总体驾驶行为,可能对应专注、分心或错误状态。
标注协议。候选片段交由专家人工复核,按领域专家指导制定的结构化认知注意标注协议执行(表 6)。明显错误的注视模式或视频内容判为无效。完整协议文件"cognitive attention protocol.xlsx"随补充材料提供。
| 场景 | 驾驶行为 | 注视行为 | 标签 |
|---|---|---|---|
| 城市 | 直行 | 远处路中心、前车、路牌 | 专注 |
| 路边广告、路边建筑 | 分心 | ||
| 高速 | 直行 | 远处路中心、前车 | 专注 |
| 路边护栏、路边环境 | 分心 | ||
| 乡村 | 路口转弯 | 前方道路、路边提示物 | 专注 |
| 路边植被、无关物体 | 分心 |
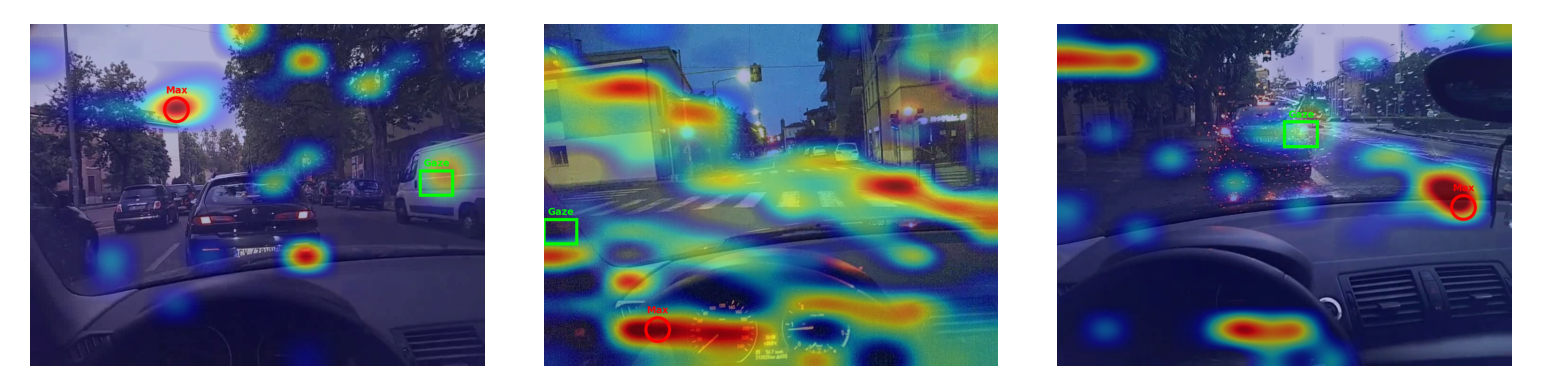
理想情况下模型应关注与驾驶员视觉注意一致、与驾驶上下文相关的区域。但在城市街道、傍晚光照与夜间驾驶等挑战场景中,观察到注视图块与最强激活区域间的明显错位(图 9)。失败有两大原因:其一,视频编码器可能被高对比度但与驾驶无关的区域(反光、强光、背景物体)带偏,视频类别 token 编码了误导性场景信息;其二,低照度、眩光、复杂城市背景会劣化图块级特征质量,削弱注视—图块对齐,使模型难以把注视与正确的上下文证据关联。此外,物体重叠或"视觉显著但与场景无关"的区域也会导致失败。改进挑战视觉条件下的鲁棒性、增强细粒度注视区域对齐是未来的重要方向。
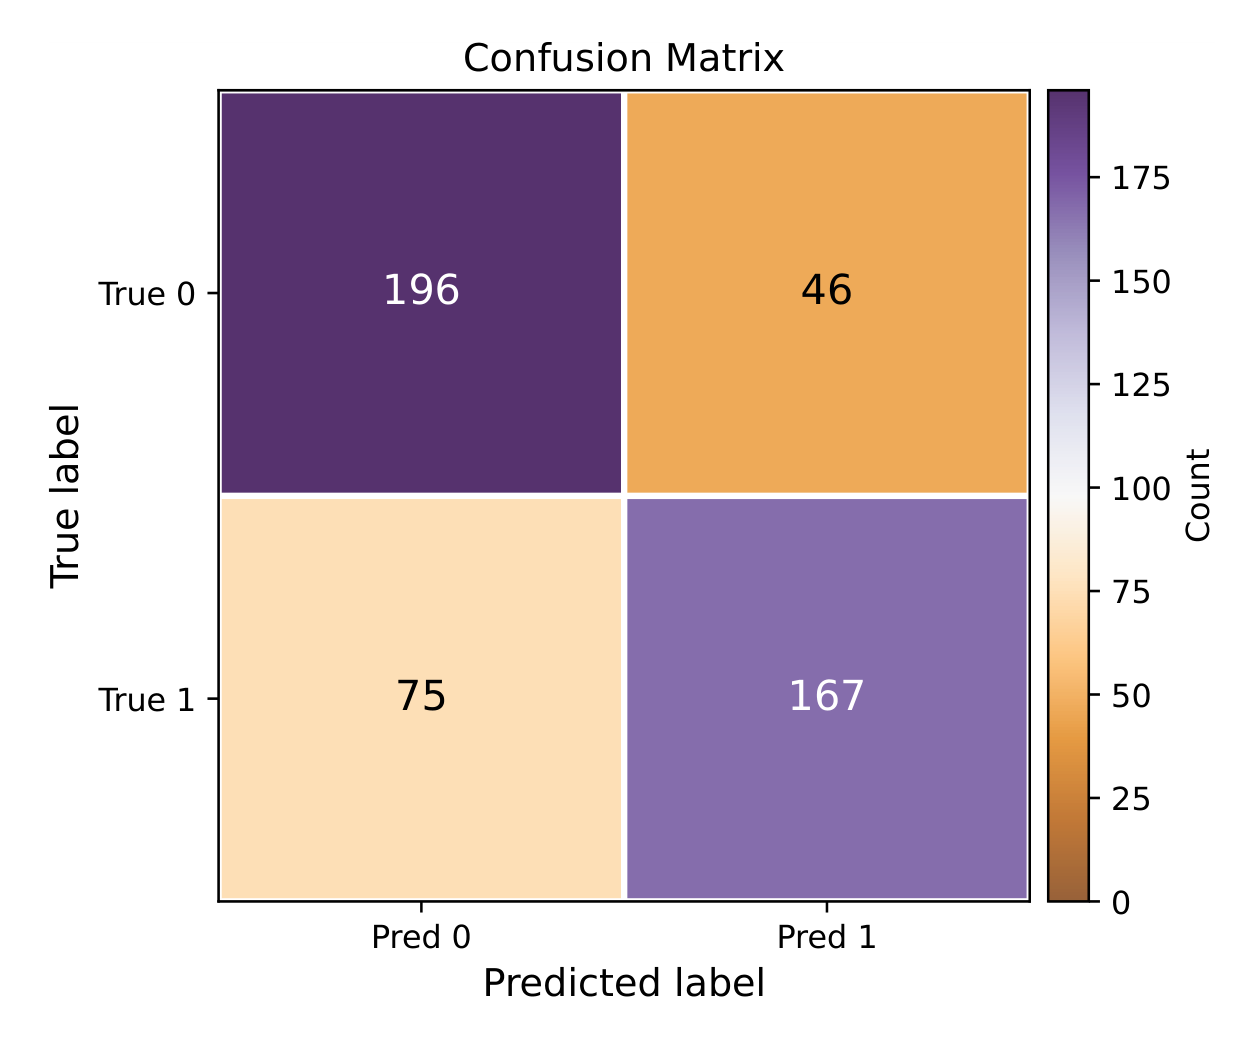
混淆矩阵。图 10 为单轮评估(484 样本,242 专注 + 242 分心)的混淆矩阵。EyeCue 正确识别大多数分心样本:167 个真阳性,75 个分心被误判为专注。分心类 recall=0.69、precision=0.78,F1=0.74,灵敏度与可靠性权衡均衡。
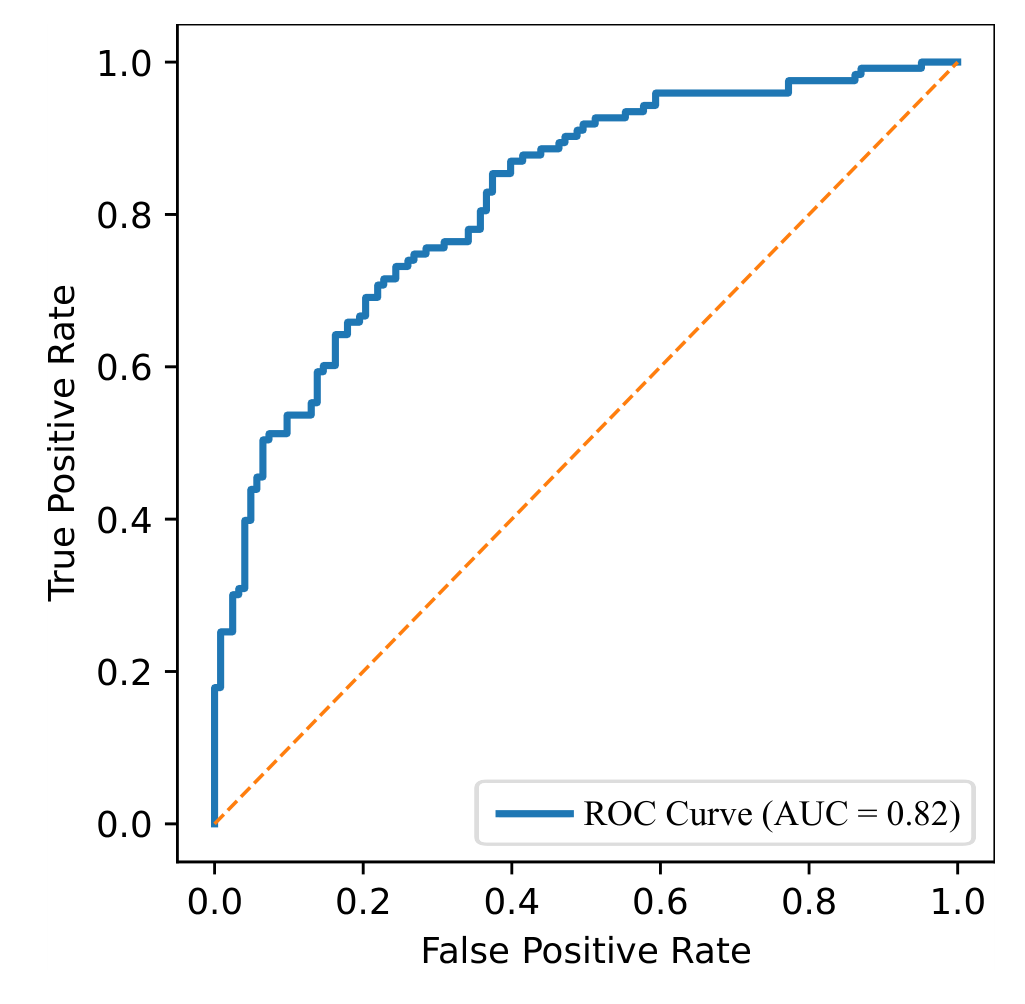
ROC-AUC 分析。图 11 中 EyeCue 在 CogDrive 上 AUC=0.82,低假阳率下仍保持高真阳率,说明其有效捕捉了有信息量的视线—场景交互模式,而非依赖特定阈值。
计算开销。TimeSformer 骨干下 EyeCue 含 138M 参数、760G FLOPs,L40S 上单样本推理 0.4 秒——在强视频 Transformer 骨干下仍保持计算上的实用性。
眼动噪声鲁棒性。数据集眼动仪采样率 30 fps、校准精度 < 0.5°。对注视坐标加 20 像素随机噪声,准确率 74.17%(几乎不变);加至 100 像素降至 71.07%——中等噪声下相对鲁棒,大幅偏离真实注视区域会明显降低性能。
一、这篇论文不能给我们什么。先划边界:(1) CogDrive 的标签是"专注/分心"二值协议下的片段级标注,不是行业 DMS 意义上的分心等级或 KSS 困倦度,不能直接当作量产 DMS 的输出定义;(2) 模型假设有可靠的注视点坐标流——数据集来自眼动仪(<0.5° 校准精度),而后装 DMS 摄像头的视线估计普遍在 3–5° 误差量级,论文的噪声实验只做到 100 像素(准确率掉到 71.07%),跨到车内摄像头视线估计域之前,结论不可外推;(3) 138M 参数 / 760G FLOPs / L40S 上 0.4 秒每样本,TimeSformer 骨干在 QCS8255 级车规 SoC 上无法实时,论文未讨论蒸馏、剪枝或量化路径。
二、能直接取走的东西。(1) h=1 的中央凹先验:每个注视点只取 1 个图块反而最好(表 3,h=25 时掉到 70.04)——这一条零成本,任何带视线输入的 ViT 类模型都值得先试;(2) 热力图掩码预处理:不改模型、75 像素核,原始视频 68.53% → 72.93%(图 5),是性价比最高的第一步;(3) CogDrive 标注协议(表 6 + CC<0.3 片段筛选 + 双标注者 + 专家复核、98% 一致性)可以整套搬去标注自采数据;(4) 附录 prompt(A.2)可直接用于 VLM 基线复测。
四、我们相对论文的增量。车内 DMS 摄像头有驾驶员面部图像而论文只有前视路面——可用头部姿态与眼睑开度做注视质量的先验校验(低质量视线样本直接降权);CAN 总线信号(方向盘角速度、车速)是论文没有的"认知状态间接证据",可做低成本交叉验证。
五、落地路线(按论文自己的消融证据排性价比,而非按论文叙述顺序)。第一步:现网视频模型 + 热力图掩码预处理(+4.4 点,零架构改动);第二步:接入注视编码器做直接融合(70.25 → 72.31 的证据表明融合有效);第三步:再做 GDSQ 交叉注意力(+2.07)。每一步都可独立回退验证,不必一步到位复刻全模型。
六、动手前必须确认的前提(go/no-go)。视线估计精度能否稳定优于 1°?不行则 GDSQ 的收益会被噪声吃掉(100 像素噪声 ≈ 71.07% 的教训);标注团队是否有领域专家做表 6 协议复核;边缘侧算力预算能否容纳"视频骨干 + 轻量注视 Transformer"的组合(8 头 1 层的注视编码器本身很轻,大头是视频骨干)。