面向高级驾驶辅助系统的驾驶员分心检测与道路目标实时识别一体化深度学习框架 Integrated deep learning framework for driver distraction detection and real-time road object recognition in advanced driver assistance systems

Rakesh Salakapuri¹, Naveen Kumar Navuri², Thrimurthulu Vobbilineni³, G. Ravi⁴, Karthik Karmakonda⁵ & K. Asish vardhan²
¹ Symbiosis Institute of Technology, Hyderabad Campus, Symbiosis International (Deemed University), Pune, India
² Department of Computer Science & Engineering, Malla Reddy University, Hyderabad, India
³ Department of Computer Science & Engineering, MLR Institute of Technology, Hyderabad, India
⁴ Department of Computer Science & Engineering, MRCET, Hyderabad, India
⁵ Department of Computer Science & Engineering, CVR College of Engineering, Hyderabad, India
通讯作者:srakesh@sithyd.siu.edu.in
Scientific Reports (2025) 15:25125 · https://doi.org/10.1038/s41598-025-08475-4
收稿:2025-04-09 · 录用:2025-06-23

摘要

大多数事故源于驾驶过程中的分心,道路使用者的安全是全球性议题。本文提出的方法将用于驾驶员分心检测的先进深度学习与实时道路目标识别相结合,以共同应对这一问题。驾驶员行为借助卷积神经网络(CNN)与迁移学习被划分为视觉分心、操作分心和认知分心,以在获得更高精度的同时消耗更少的计算资源。YOLO(You Only Look Once)实时检测车辆、行人、车道线与交通信号。该系统包含(1)分心检测与(2)输出(或场景)识别两个部分,二者结合其他系统与代码来评估驾驶场景。决策模块对融合后的数据进行评估以判断危险等级,并及时发出警告或采取纠正措施。我们的集成方案将使高级驾驶辅助系统(ADAS)具备完整的场景感知能力,提醒驾驶员注意分心与危险,提升整体态势感知并减少事故。方法部分辅以雨、雾与低照度场景下驾驶员行为与道路状况的标注图片和视频。通过数据增强、模型优化与迁移学习,系统在多种驾驶场景下实现了可靠性。系统在 State Farm Distracted Driver Dataset、KITTI 与 MS COCO 基准上表现出更好的准确率与效率。将现有的驾驶员监测系统与道路感知系统集成,可以构建多目标、全面的解决方案,既让驾驶更安全,也助力现有 ADAS 技术的发展。通过融合 CNN 与 YOLO 两项深度学习进展,本文建立了一个实时、可扩展的道路安全系统。系统在 NVIDIA Jetson Xavier NX 平台上完成实时嵌入式部署,达到 25 帧/秒(FPS),延迟与内存占用均有所降低,验证了其在资源受限 ADAS 中的可行性。本文还提出了一个领域专用的驾驶员监测模块和一个基于知识的道路危险识别模型,使自动驾驶与"人"这一侧连接得更紧密。

关键词:驾驶员分心检测,道路目标识别,卷积神经网络(CNN),YOLO(You Only Look Once),高级驾驶辅助系统(ADAS),深度学习,迁移学习,实时目标检测,操作分心,嵌入式系统,决策模块,环境感知,态势感知

背景

道路交通事故在全球范围内频繁发生,这凸显了改进安全措施的必要性。有一种观点认为,驾驶员分心是交通事故的主要成因之一,因为发短信、吃东西或视线离开道路等行为导致了其中相当大比例的事故1。传统的路边驾驶员监测与道路危险检测系统通常适用范围有限,因为它们要么只关注驾驶员行为,要么只关注周围环境,而不能整体兼顾2。深度学习方法,包括卷积神经网络(CNN)与实时目标检测算法(如 YOLO——You Only Look Once),为上述挑战提供了一些潜在的解决方案。这些技术使得在低照度、雨天与城市交通等多种工况下可靠且高效地检测驾驶员行为与环境风险成为可能3,4。

问题陈述

现有用于提升道路安全的解决方案往往没有将驾驶员分心检测与道路目标识别能力整合起来。许多系统要么面向驾驶员状态检测(如视线跟踪、动作分类),要么面向道路危险检测(如车辆、行人、交通标志),这限制了整体态势感知5。这种碎片化削弱了高级驾驶辅助系统(ADAS)的价值,因为它们无法提供驾驶场景的"人视角"来实时帮助预防事故6。

研究目标

本研究旨在设计并开发一个整体系统,利用深度学习技术同时检测驾驶员分心并识别道路危险。更具体地,所提出的系统将:

范围与意义

这种高层次的集成通过在统一框架内融合驾驶员分心检测与道路目标识别,弥补了当前安全系统的关键缺口。所提出的系统因此有望减少道路事故,并通过增强态势感知来扩展 ADAS 的能力12。利用 ResNet、YOLOv4 等预训练模型进行迁移学习,还使系统能够以更低的计算代价实现高精度、低成本的部署13。

此外,该方法的可扩展性使其成为自动驾驶技术演进中的关键一环。该模型通过集成以人为中心的监测与外部危险检测,弥合了辅助驾驶系统(ADAS)与完全自动驾驶系统之间的鸿沟,从而带来更智能、更安全的交通解决方案,并实现向自动驾驶的平滑过渡14。

文献综述

现有研究概述

在智能交通系统领域,驾驶员分心检测与道路环境目标识别各自都已被充分研究。驾驶员分心检测研究主要局限于发短信、吃东西、视线离开道路等行为,依托基于图像与机器学习的方法15。相比之下,道路目标检测借助 YOLO、Faster R-CNN 等深度学习模型取得了显著进展,实现了对车辆、行人、交通标志与车道线的实时检测16,17。当前系统往往是孤立的,要么做驾驶员监测,要么做环境感知,这严重限制了它们在复杂真实场景中的作用。

关键技术及其局限

驾驶员分心检测

CNN 已被用于多项驾驶员分心检测研究,并展现出良好的精度,尤其是对操作分心与视觉分心等单一类型的检测。例如,基于 State Farm Distracted Driver Dataset,多种机器学习模型都达到了性能里程碑18。然而,这类系统通常在不同场景之间的泛化能力有限,因为它们未考虑光照条件、遮挡或驾驶员人群差异等因素19。

道路目标识别

自第一版问世以来,基于 YOLO 的方法一直是道路目标检测在速度方面的首选,同时保持了精度。尽管 YOLOv3 与 YOLOv4 在城市环境中表现良好,但它们在雾天、雨天或夜间行驶等对抗性场景下表现不佳20。此外,训练目标识别系统需要大规模标注数据集,数据获取成本可能非常高21。

集成这两个系统的重要性

通过将驾驶员分心检测与道路目标识别相结合,本方法克服了孤立系统的局限,提供了对驾驶场景更完整的视图。集成系统能够同时估计驾驶员状态与环境危险,从而为 ADAS 的实时决策提供关键输入7。一个既能检测驾驶员姿态变化又能识别路上行人的系统,可以及时发出警告以预防事故3。此外,集成系统对自动驾驶项目也有益处——在这些项目中,人的监督与周围环境知识对车辆的平稳运行至关重要。

迁移学习的作用

迁移学习在此用于从强大的深度学习模型中提取特征。使用 ResNet、VGG、YOLO 等预训练模型,系统能够在领域专用数据较少的情况下依然获得高精度,同时减少训练时间与系统成本8。例如迁移学习18可将从 ImageNet 等大型数据库的通用任务(如目标识别)中学到的信息迁移过来,增强驾驶员分心检测模型。又如,在 MS COCO 等数据集上预训练的 YOLO 模型,也已在环境条件变化下的道路目标检测中展现出很好的效果19。

提出的方法

在本研究中,我们提出了一个基于深度学习的集成系统,用于驾驶员分心检测与道路目标识别。本节讨论系统的数据需求、模型配置、集成策略与部署方案。

数据收集与预处理

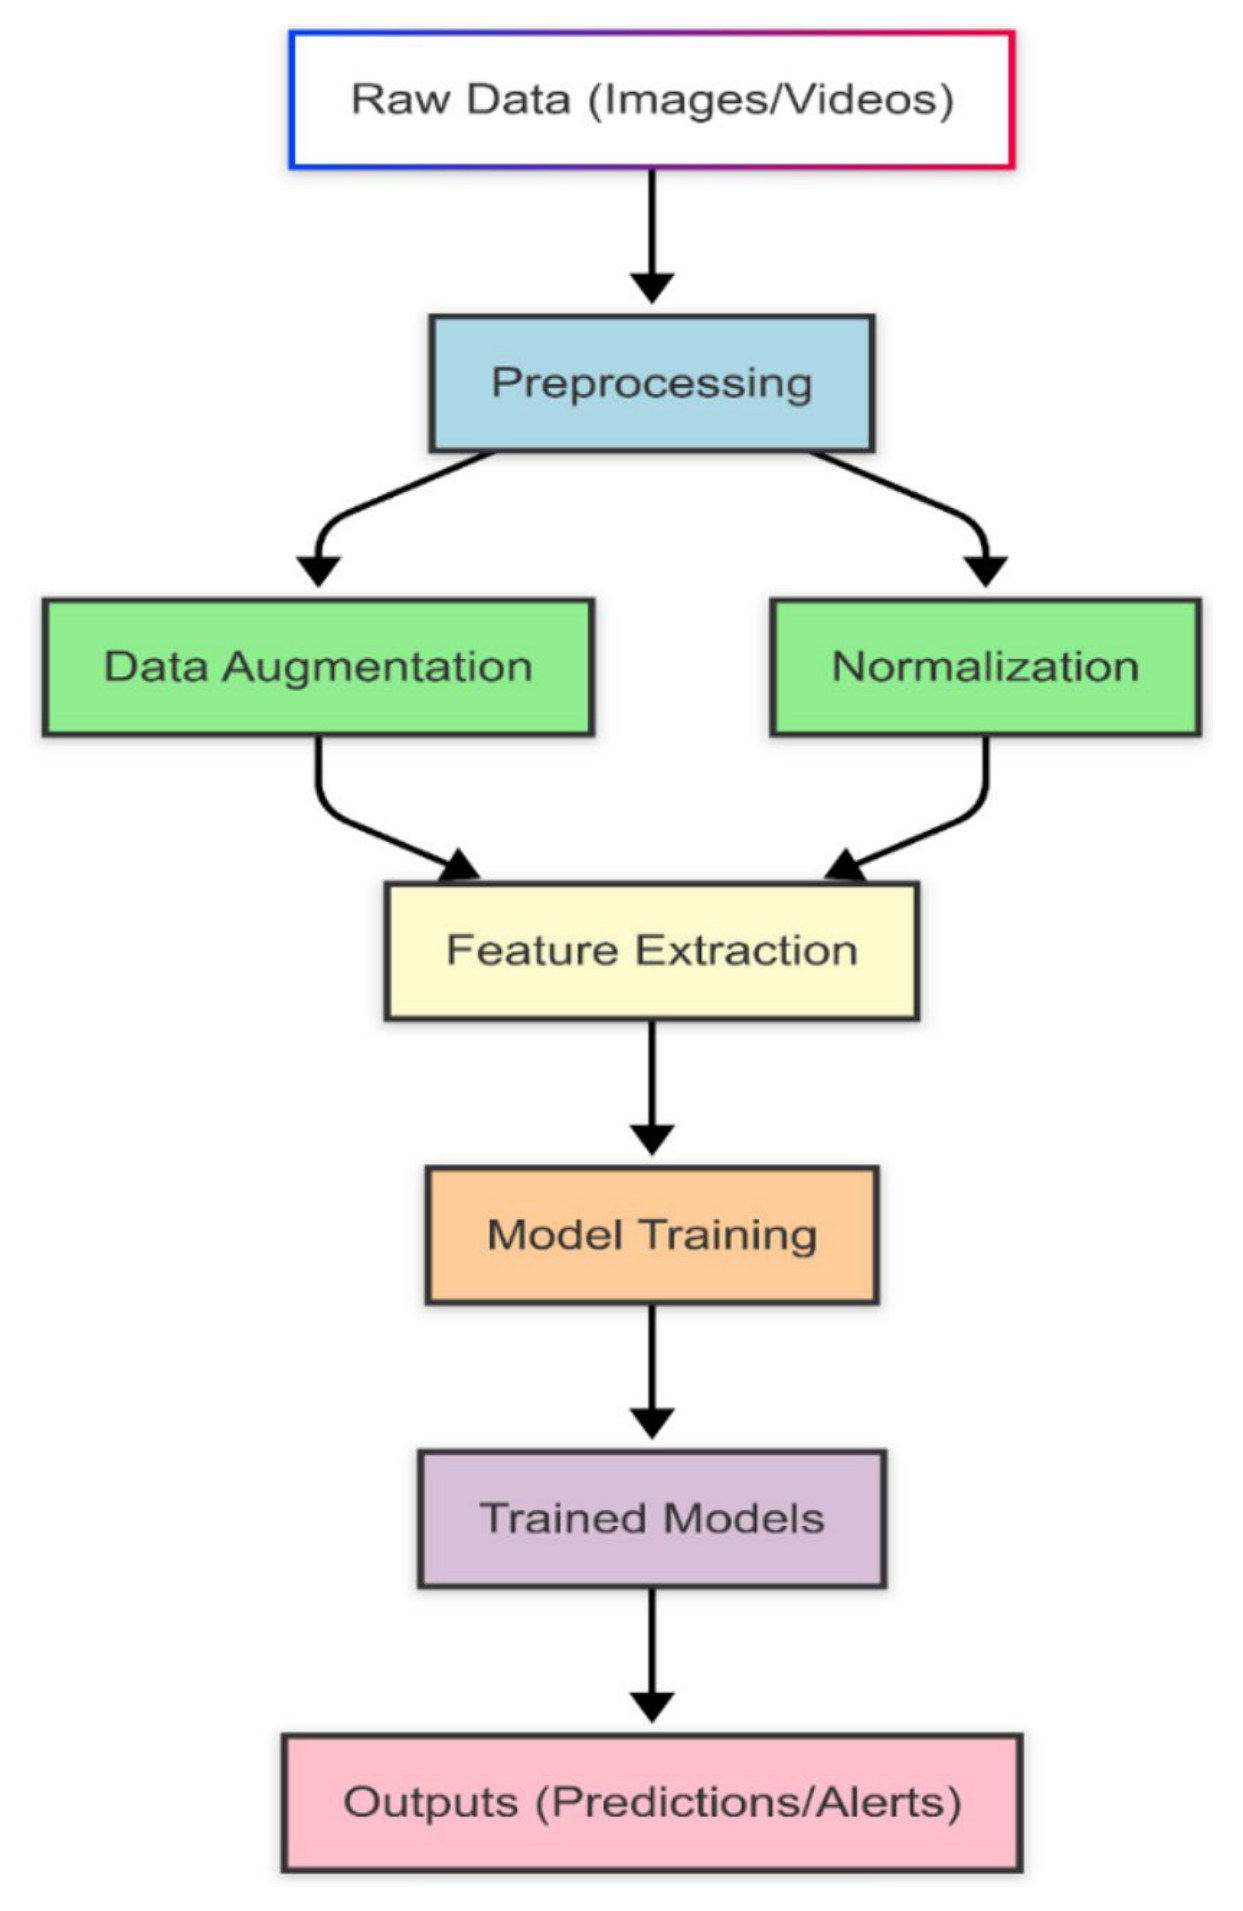
完整的数据预处理流程如图 1 所示,它描述了构建一个强健系统所需的关键步骤。这些方法用于提升数据质量、增强模型泛化能力,并保持训练与测试阶段的一致性:

图 1. 系统工作流:展示从输入到训练的预处理与数据流。

数据集要求

数据增强

通过随机裁剪、旋转、亮度调整与翻转等图像增强手段2,增加可用于训练模型的数据多样性,并改善模型的泛化能力。

预处理步骤

输入图像归一化

此处对输入图像做归一化,以保持训练期间的一致性:

I′ = (I − μ) / σ

其中:

基于 CNN 的驾驶员分心检测

架构设计

CNN 架构由特征提取与分类的多层结构组成。这些层的设计7用于检测头部朝向、视线方向与手部动作等信号。

迁移学习

通常将以数千张图像预训练的模型(如 VGG-16 与 ResNet)针对驾驶员行为检测进行微调8。交叉熵损失为:

L = −Σi=1N  yi log(ŷi)

其中:

特征提取

仅提取细微特征,如视线模式、头部位置与手部位置18,用于分类分心类型,即视觉分心、操作分心或认知分心。

F = σ(W ∗ X + b)

其中:

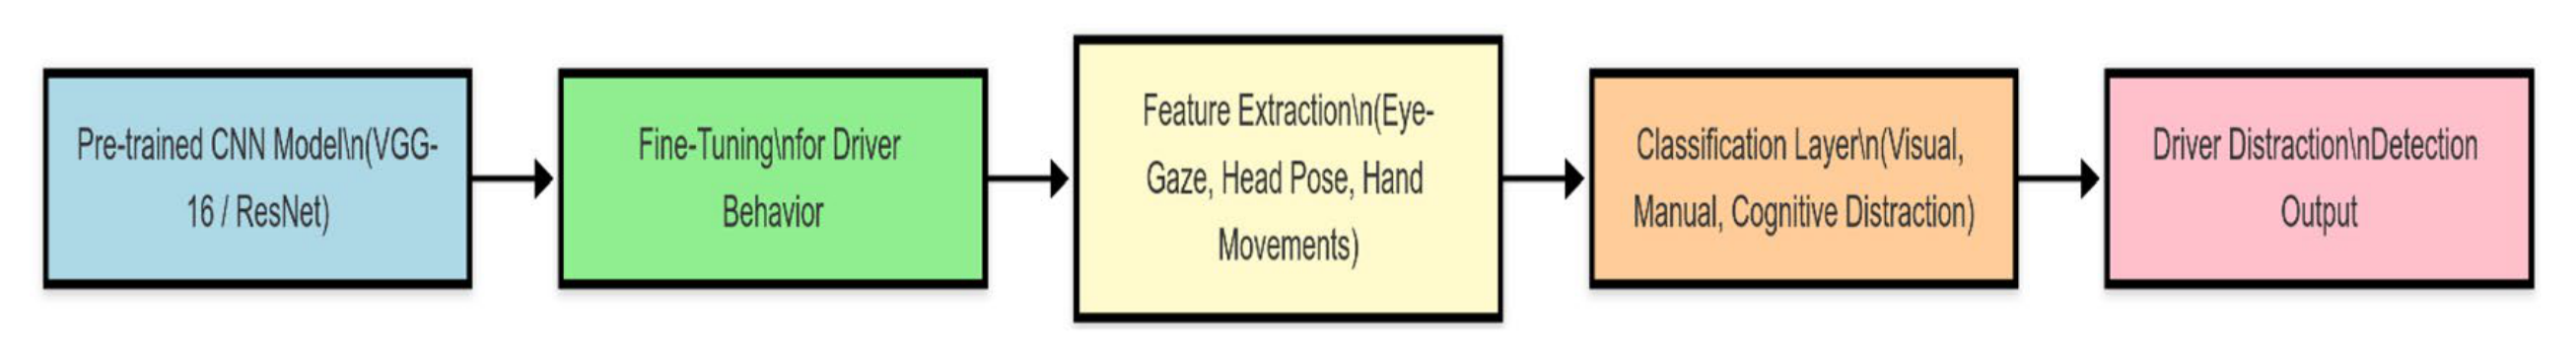
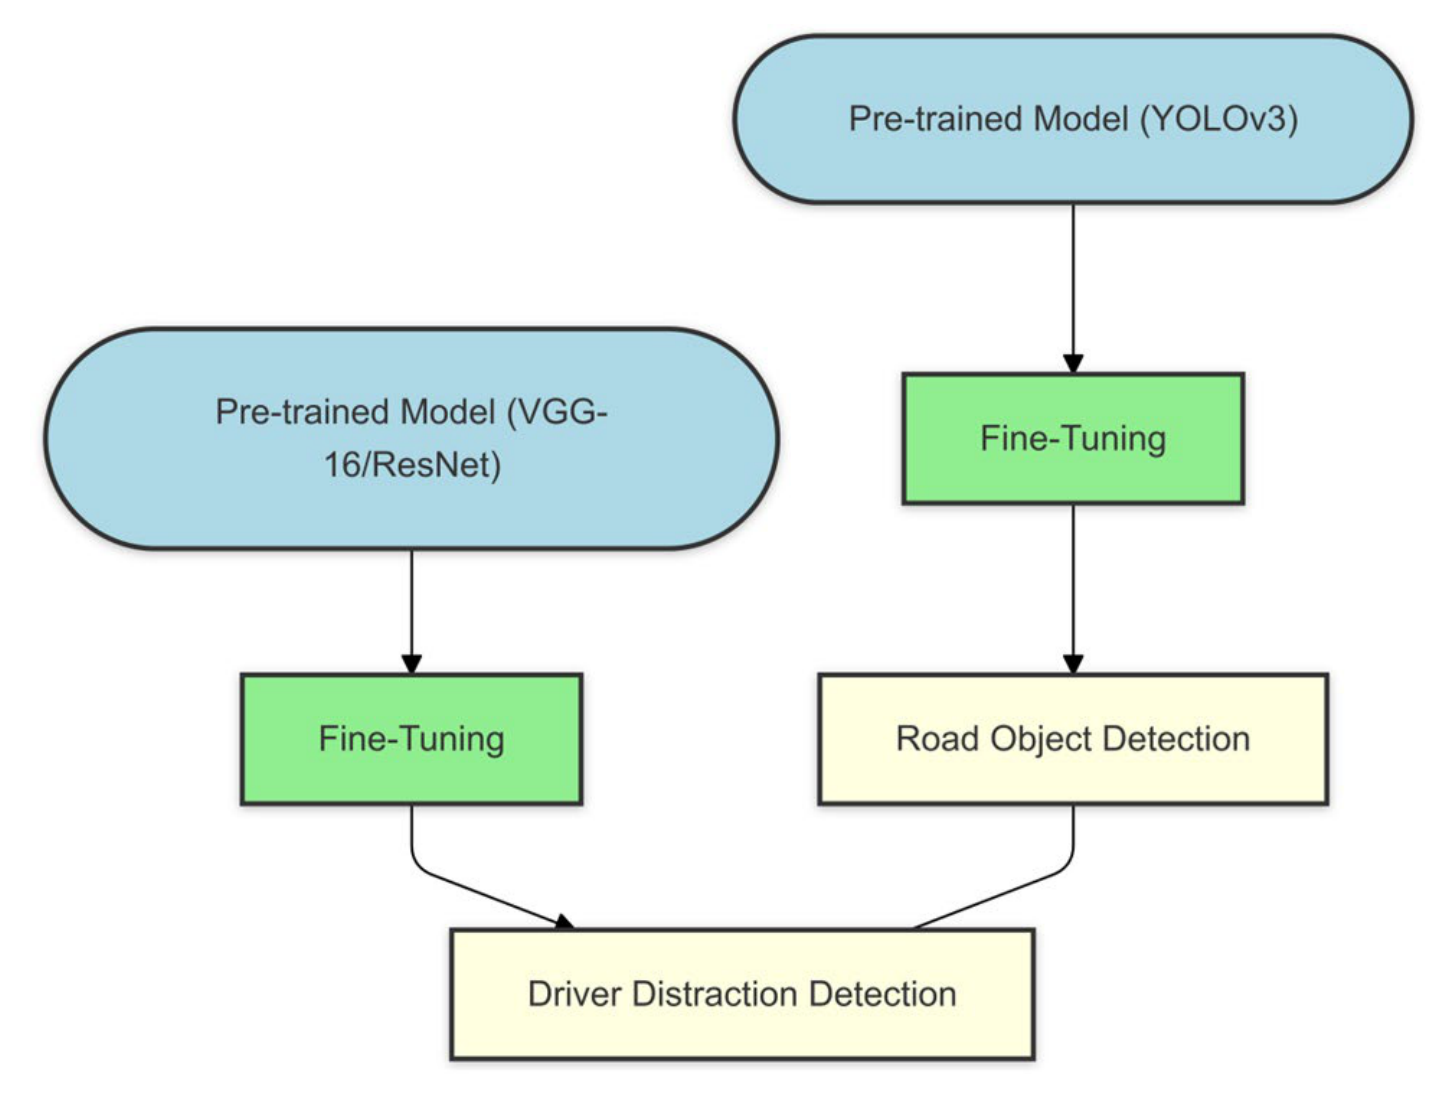
具体而言,CNN 通过帧间的细微行为(如头部姿态、视线方向与手部动作)来判断驾驶员是否分心。图 2:CNN 架构通过迁移学习针对分心相关特征进行微调。这里使用的是原本在类别繁多的巨型数据集(如 ImageNet 上训练的 VGG-16、ResNet)上预训练的模型。如图 3 所示,迁移学习的方法是调整这些模型的层组织方式,然后以较少的轮次训练,使其适应特定任务——此处的任务即驾驶员行为分类。

图 2. 迁移学习架构。
图 3. 迁移学习架构:展示预训练模型如何针对驾驶员分心检测进行微调。

基于 YOLO 的道路目标检测

YOLO 配置

该调研方法采用 YOLO(You Only Look Once)框架对道路目标(即行人、车辆、交通标志与车道线)进行实时检测的流程图21。YOLO 快速而准确的目标检测能力增强了其实时应用价值。

迁移学习

微调是指取在 MS COCO 数据集上预训练的 YOLO 模型(如 YOLOv3 或 YOLOv4),并对其进行微调,使其能够识别其将要部署的特定道路场景中的目标9。

环境因素考虑

训练已包含夜间、雾天、雨天等多种场景,使模型在更严苛的条件下依然保持稳健16。YOLO 损失函数为:

L = λcoord Σi=0s² Σj=0B 1ijobj[(xi − x̂i)² + (yi − ŷi)²]
+ Σi=0s² 1iobj(ci − ĉi)² + λnoobj Σi=0s² 1inoobj(ci − ĉi)²

其中:

原文此式与 YOLOv1 标准损失相比缺少宽高 (w, h) 项——标准 YOLOv1 损失还包含 λcoordΣ1ijobj[(√wi−√ŵi)²+(√hi−√ĥi)²]。本译稿按原文照录,不代原文补全;读者复现时请参照 YOLO 原始论文。

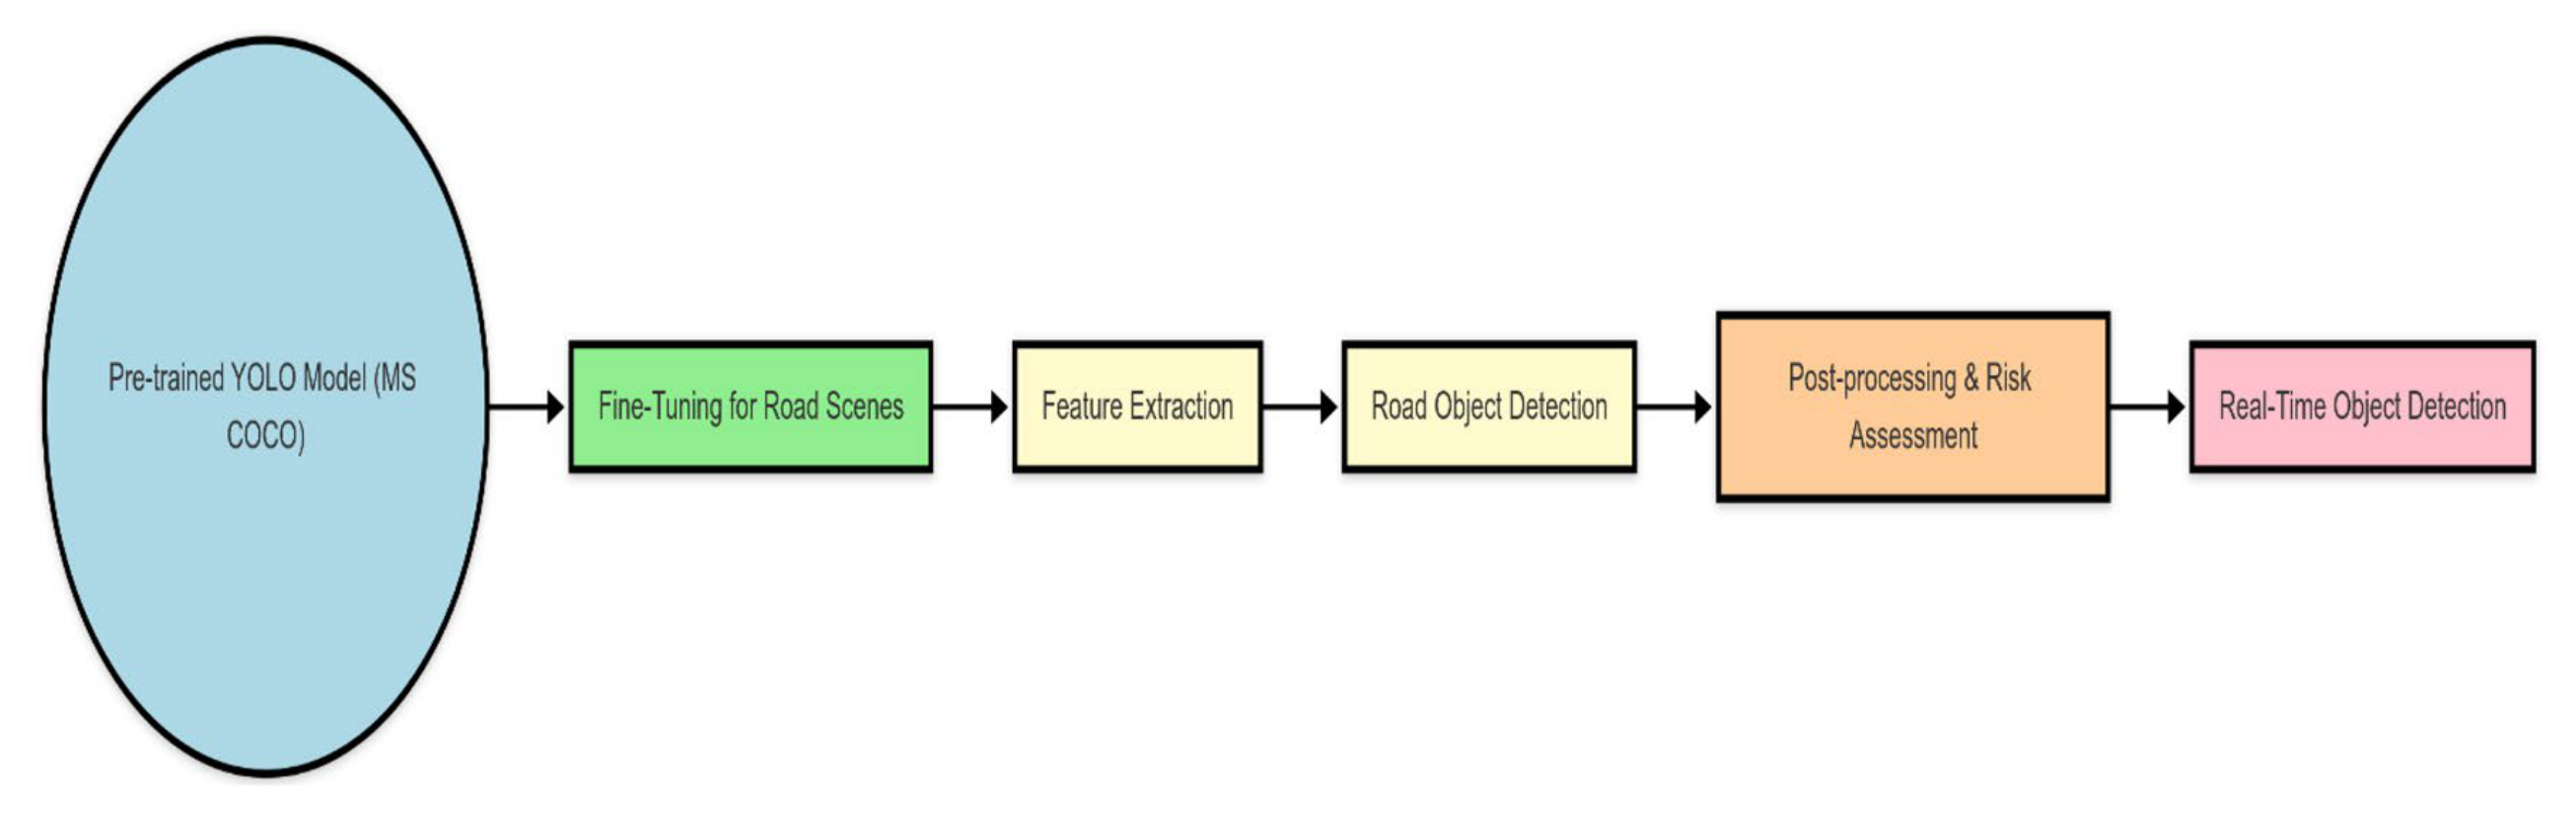
图 4 描绘了 YOLO 模型的微调过程,即将预训练模型调整为能精确识别车辆、行人、车道线等道路场景目标。这里我们展示了利用迁移学习策略对 YOLO 的功能进行微调,以在各种运行环境下实现实时目标识别。

图 4. 迁移学习架构:展示 YOLO 针对道路目标检测的微调过程,及其接入实时风险评估与后处理流水线的方式。

驾驶员分心检测与道路目标识别的集成

输出融合

基于 CNN 的分心检测模块与基于 YOLO 的目标检测模块分别感知驾驶环境的不同侧面,二者被相应地合并为驾驶场景的单一表示11。系统通过对分心得分 D(来自 CNN)与危险得分 H(来自 YOLO)的加权求和,计算实时风险等级 R:

R = αD + βH

其中:

决策模块

基于检测到的道路目标与驾驶员状态,决策模块(基于规则或基于机器学习,如随机森林、SVM)对态势进行评估。它识别高风险场景并生成相应响应12。

实时告警

有了风险等级评估,系统便可给出实时告警,如警告消息与紧急消息13:

R = αD + βH

其中 D 表示由 CNN 得到的分心概率,H 表示由 YOLO 检测目标(含其类别与空间接近度)计算得到的危险得分。系数 α = 0.6、β = 0.4 依据其在驾驶风险场景中的相对影响进行启发式赋值,对驾驶员行为赋予更高权重,这与已有安全性研究的结论一致7,8。

作者提出该公式作为一种合成融合策略,用于在公开数据集缺乏风险真值标注的情况下估计情境化驾驶风险。它支持三级分类:

原文此处"安全"阈值写为 R < 0.44,但同一文第 15 页的地面真值标注一节及后文均写为 R < 0.4,且 0.44 与相邻的 0.4–0.7 区间在数值上不衔接(0.4 ≤ R < 0.44 会被同时归入两类)。应为原文排版笔误,本译稿照录并以 0.4 为准。

告警决策阈值

为判断是否发出告警,系统评估:

Alert = { 1, R > Thigh(紧急告警);  0, R < Tlow(无告警);  Warning, Tlow ≤ R ≤ Thigh(警告) }

其中 Tlow、Thigh 为风险阈值。

d) 后处理与风险评估模块

在初步检测之后,采用滑动 5 帧平均的后处理对相邻帧的风险评估进行平滑,以消除场景突变带来的误报。此外,还根据检测目标的接近度与分心类型应用动态阈值,以对重要告警进行优先级排序。最终的分级告警(安全、谨慎、危险)随后呈现在用户界面上。

带注意力机制的改进融合策略

为进一步增强驾驶员分心检测模块(CNN)与道路目标识别模块(YOLO)输出之间的耦合,我们提出一种轻量的基于注意力的融合机制。该机制不像常规做法那样将两路输出等权对待,而是根据两个模块估计的情境风险水平动态分配注意力权重。注意力机制依据情境重要性在驾驶员行为与环境风险之间进行取舍,从而在多种驾驶场景下实现自适应风险评估。

基于学习的决策模块

除基于规则的告警之外,我们使用集成机器学习分类器升级了决策模块,包括:

计算得到的风险得分 R 被用作特征向量 F = [D, H, 车辆密度, 分心类型, 目标接近度] 的一部分,作为学习型决策分类器(RF 与 SVM)的输入。这些分类器在由"实时告警"一节所述基于得分阈值派生的合成标注样本上训练。尽管是启发式的,该方法在缺乏人工标注驾驶风险数据集的情况下仍能生成情境化告警类别,并且在"集成策略的对比分析与基准测试"一节中与基线系统对照验证时表现出稳健的性能(F1 分数 92.4%)。

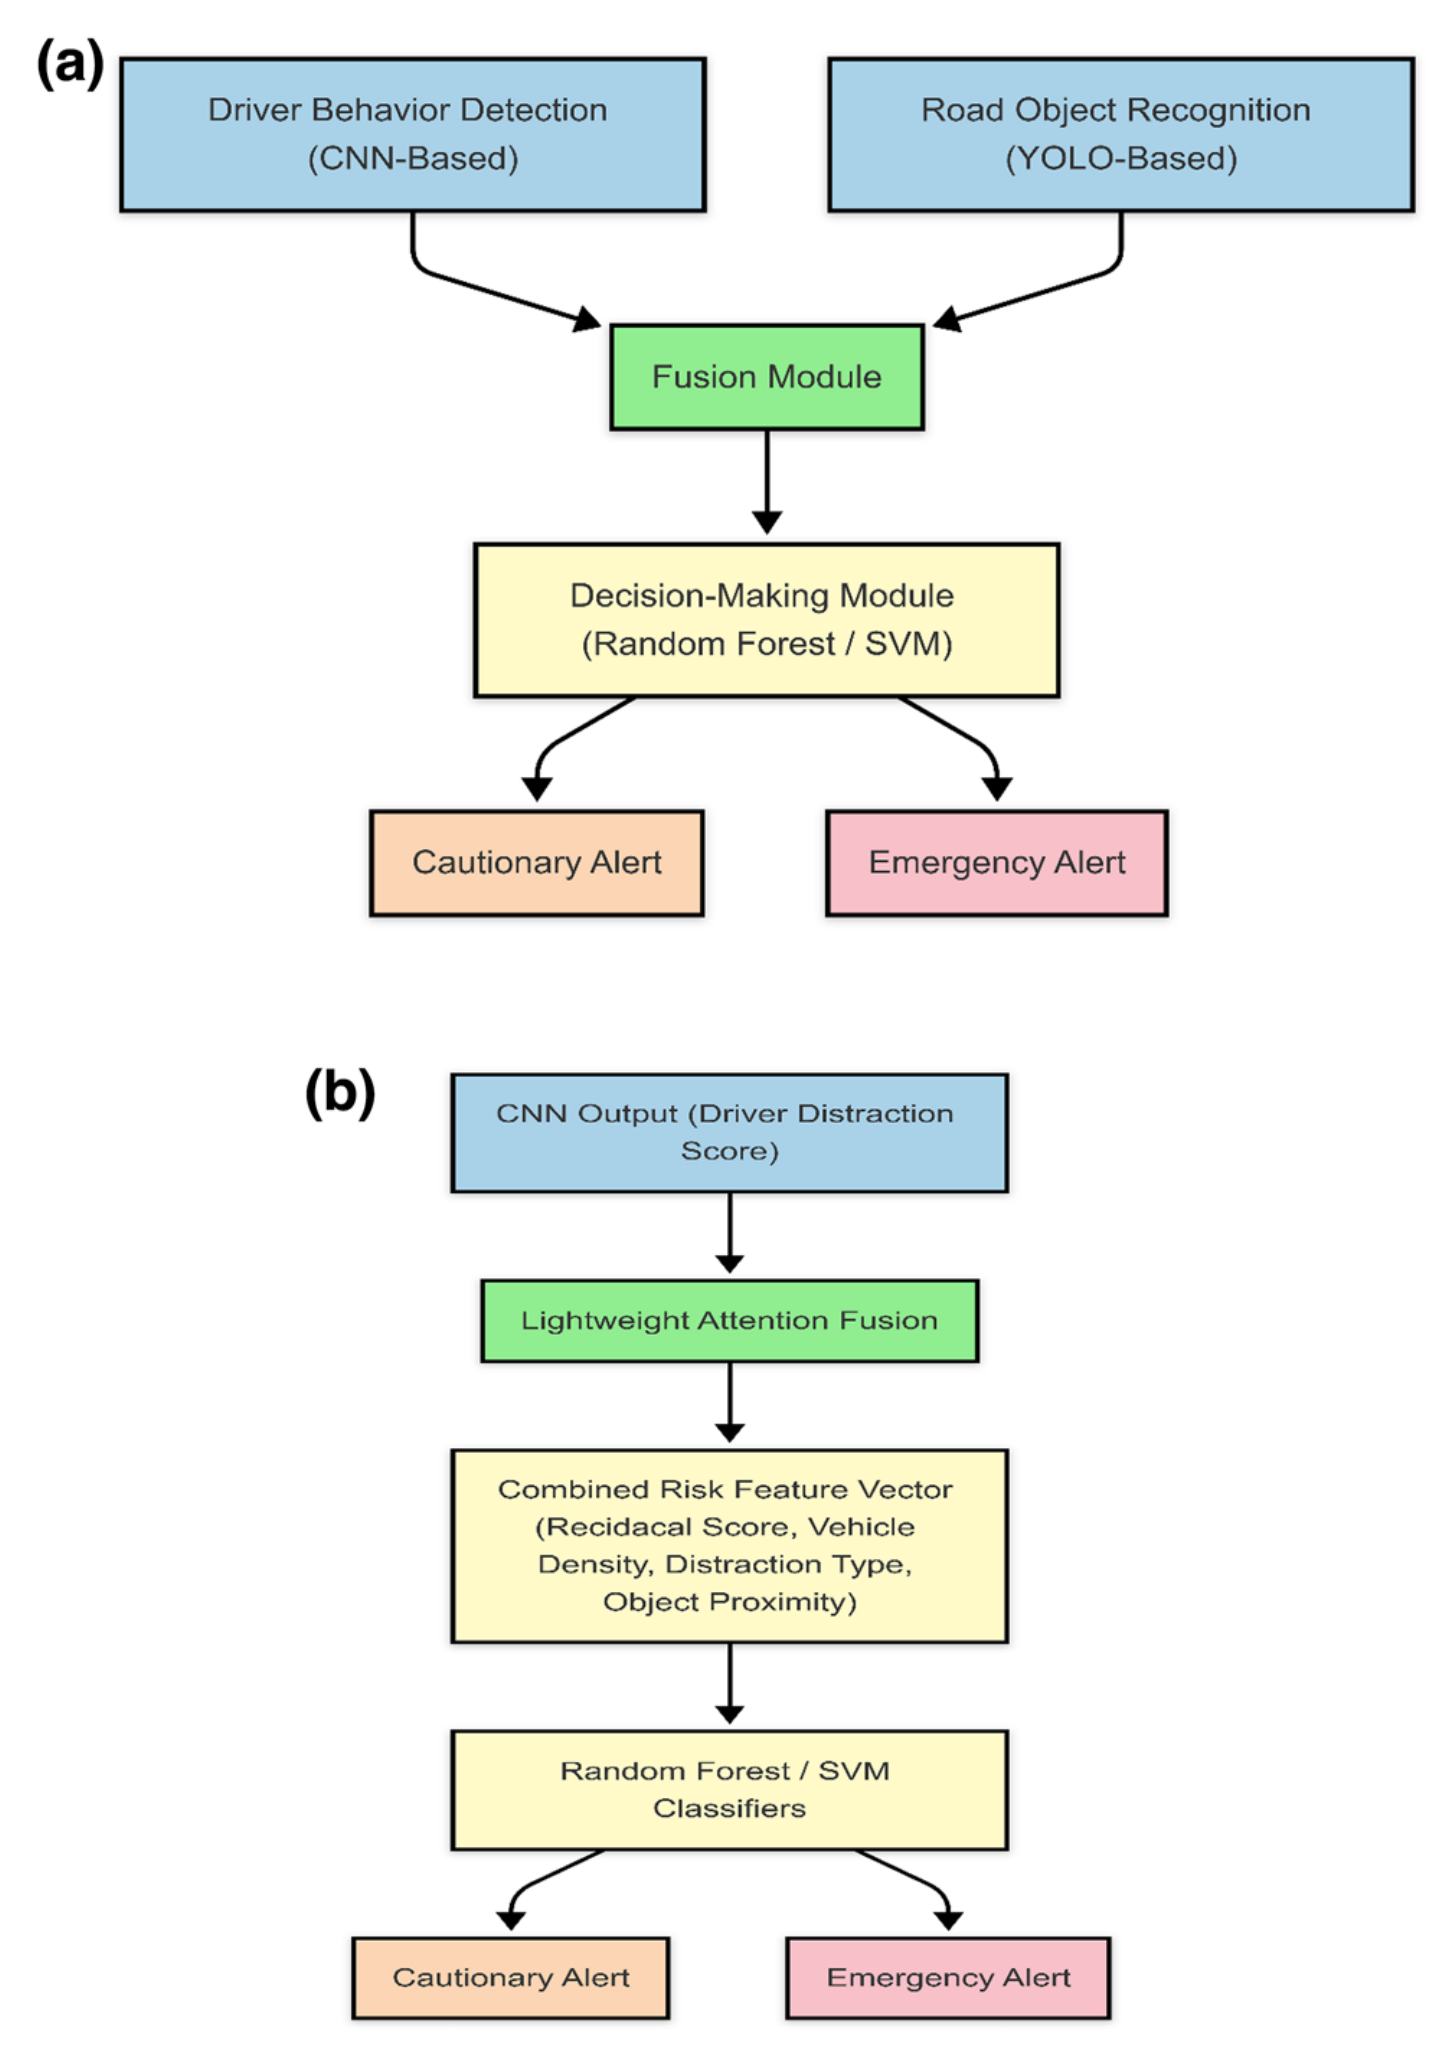
图 5 实质性地展示了融合驾驶员分心检测模块与道路目标识别系统输出并作出决策的原理。它基于近实时的处理,整合行为与环境数据,给出精确细致的风险评估以及相应的系统动作触发,如预防性告警与紧急告警。

图 5b 展示了改进后的决策架构:使用轻量注意力融合机制融合分心检测与目标识别结果,对行为与环境风险因子进行动态加权,得到聚合的风险特征向量,再交由随机森林与支持向量机(SVM)分类器分类。这种基于学习的风险评估使系统能够在近实时条件下务实地对情境风险与分心进行优先级排序,提供更智能、更贴合情境的告警生成能力,输出安全(Safe)、谨慎(Cautionary)或危险(Critical)三级响应。

图 5. a 决策流程:可视化输出融合与决策逻辑。b 增强型融合与决策流程:融合 CNN 与 YOLO 输出用于实时风险评估。

实时实现与系统部署

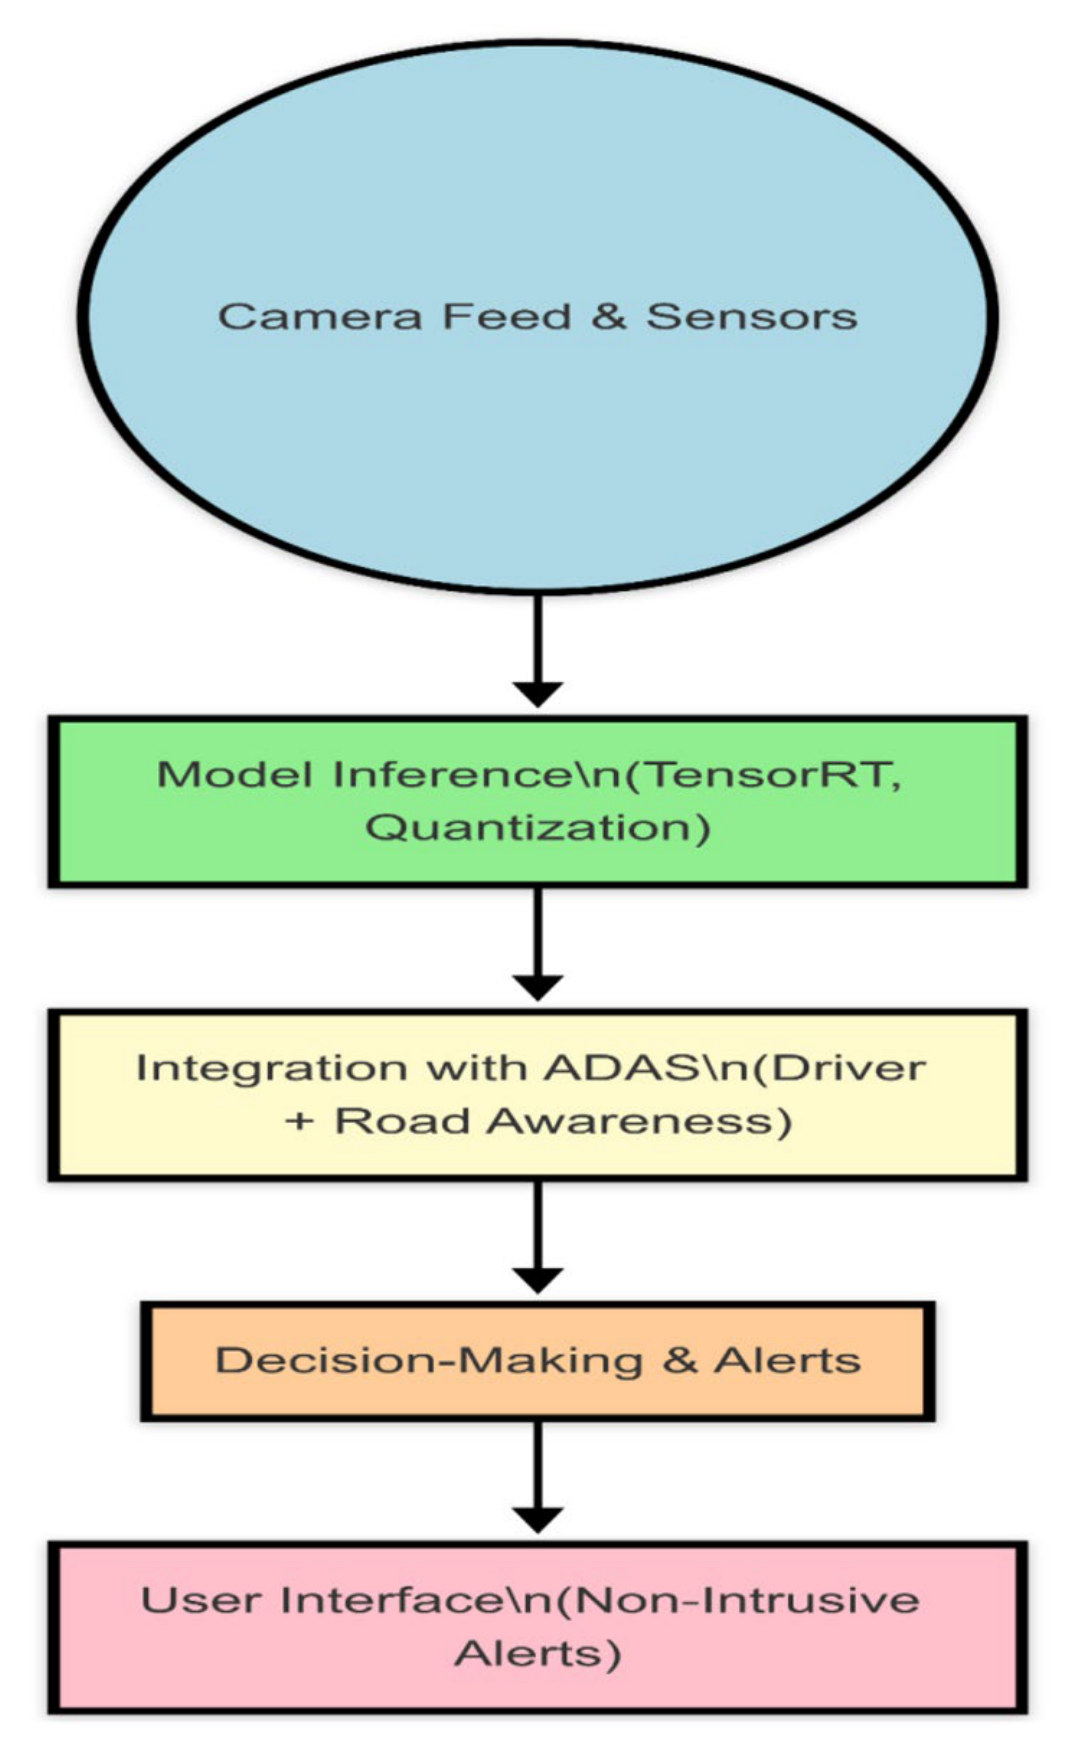
图 6 描绘了从实时数据采集到告警生成的端到端系统部署。它展示了经过优化的模型如何运行于嵌入式平台,在真实运行条件下实现低延迟推理、风险评估与用户友好的告警。

图 6. 端到端流程:展示实时实现与部署。

优化

模型通过量化与 TensorRT 等框架部署到嵌入式系统,以获得实时性能14:

Wint8 = round(Wfp32 × 128)

其中:

与 ADAS 的集成

系统与 ADAS 协同工作,监测驾驶员行为与环境危险,从而提升态势感知并预防事故17。

用户界面

界面设计为非侵扰式,在不给驾驶员增加额外分心的前提下提供告警通知。

迁移学习与模型微调

迁移学习的收益

迁移学习显著减少了从零开始在目标任务上训练模型所需的计算时间。预训练模型提取通用特征,再针对用户特定数据集进行调整,从而以更少的任务量获得高精度6。

微调

CNN 与 YOLO 模型的最后若干层被微调,使模型贴合驾驶员行为与道路场景的特性,这通常带来更好的性能19:

Lfine−tune = Ltask + λLpretrain

其中:Ltask 为任务损失(分类或检测),Lpretrain 为预训练模型的原始损失,λ 为权重因子。

算法

原文以伪代码框形式给出系统全流程的 6 个算法,译文照录如下(内容次序与原文一致)。

算法 1. 数据收集与预处理。
输入: 驾驶员行为与道路场景的原始图像/视频。
输出: 经增强与标注的图像构成的预处理数据集。
1. 数据收集: 收集 State Farm Distracted Driver Dataset、MS COCO 等数据集;纳入多样场景(如光照条件、天气、遮挡)。
2. 数据增强: 对数据集中每张图像/视频帧:施加随机裁剪、旋转与翻转;调整亮度、对比度与色调;保存增强数据。
3. 预处理: 将所有图像缩放到统一分辨率(如 CNN 用 224×224,YOLO 用 416×416);将像素值归一化到 [0, 1];用边界框标注道路目标(供 YOLO 使用)。
4. 输出预处理数据集: 保存预处理数据集用于训练。
算法 2. 基于 CNN 的驾驶员分心检测。
输入: 预处理后的驾驶员行为图像。
输出: 驾驶员行为分类:安全驾驶、视觉分心、操作分心或认知分心。
1. 加载预训练模型: 加载在 ImageNet 上预训练的模型(如 VGG-16 或 ResNet)。
2. 微调: 将预训练模型的输出层替换为对应分心类别数(如 4 类)的新全连接层;冻结模型前面的层。
3. 训练: 将数据集划分为训练、验证与测试子集;用反向传播与 Adam 优化器在训练集上训练;监控验证精度并施加早停以防过拟合。
4. 特征提取: 用 CNN 从输入图像中提取头部朝向、视线方向、手部动作等特征。
5. 分类: 基于提取的特征对驾驶员行为分类。
6. 输出: 返回预测的驾驶员行为类别。
算法 3. 基于 YOLO 的道路目标检测。
输入: 带边界框标注的预处理道路场景图像。
输出: 带边界框与置信度得分的检测结果。
1. 加载预训练 YOLO 模型: 加载在 MS COCO 数据集上预训练的 YOLOv3 或 YOLOv4 模型。
2. 微调: 替换检测层以适配特定的目标类别(如车辆、行人、车道线);在标注数据集上训练修改后的 YOLO 模型。
3. 训练: 将数据集划分为训练与验证子集;使用随机梯度下降(SGD)与自定义学习率计划训练;在雨、雾、夜间等多种条件下验证精度。
4. 目标检测: 对每张输入图像:施加 YOLO 检测目标,输出带置信度得分的边界框。
5. 输出: 返回检测结果(类别标签、边界框、置信度得分)。
算法 4. 迁移学习与模型微调。
输入: 预训练模型(VGG-16、ResNet、YOLOv3)与领域专用数据集。
输出: 用于驾驶员行为与道路目标检测的微调后模型。
1. 加载预训练模型: 加载选定的预训练模型。
2. 替换输出层: 将输出层替换为对应输出类别数的新层。
3. 冻结基础层: 冻结预训练模型的基础层以保留通用特征。
4. 微调: 先只在领域数据集上训练新层;再逐步解冻基础层并在数据集上微调。
5. 验证与测试: 在验证集上评估微调后的模型;调整超参数以获得最优性能。
6. 输出: 返回微调后的模型用于部署。
算法 5. CNN 与 YOLO 输出的集成。
输入: CNN 输出(驾驶员行为)与 YOLO 输出(道路目标)。
输出: 风险评估与告警生成。
1. 输出融合: 获取 CNN 的驾驶员行为分类;获取 YOLO 检测到的目标及其位置。
2. 决策模块: 若驾驶员分心且附近检测到危险目标:基于目标接近度与速度评估风险等级;将情形分类为低风险、中风险或高风险。
3. 生成告警: 低风险情形:发出预防性告警(如"请保持注意");高风险情形:发出紧急告警(如"请立即制动")。
4. 输出: 向驾驶员触发实时告警。
算法 6. 实时实现与系统部署。
输入: 来自车内与前视相机的实时视频流。
输出: 带告警的实时驾驶员监测与危险检测。
1. 帧提取: 持续从输入视频流提取帧。
2. 预处理: 对提取的帧进行缩放与归一化。
3. 驾驶员行为检测: 将驾驶员帧送入微调后的 CNN 模型进行行为分类。
4. 道路目标检测: 将道路场景帧送入微调后的 YOLO 模型进行目标检测。
5. 联合风险评估: 融合 CNN 与 YOLO 输出,评估整体驾驶场景。
6. 告警生成: 使用决策模块生成实时告警。
7. 部署优化: 使用 TensorRT 与模型量化针对嵌入式硬件部署优化系统。
8. 输出: 通过用户界面以非侵扰方式显示告警。

实验与结果

以下小节详细介绍所用的数据集、实验设置、评估定义、性能对比以及所提方法的可视化分析。这些实验旨在验证集成式驾驶员分心检测与道路目标识别系统的性能。

所用数据集

a. 驾驶员行为数据集:

b. 道路目标数据集:

实验设置

1. 硬件:

2. 软件:

3. 训练参数:

本研究的集成 ADAS 框架使用多个开源库开发与测试。所用软件工具及其版本与用途如下:

所有实验均在通过 Anaconda Navigator 管理的 Python 3.9 环境中进行,操作系统为 Ubuntu 20.04 LTS。

地面真值标注策略

为确保一致性与公平评估,驾驶员分心检测、道路目标识别与风险分类的地面真值标注结合了公开基准数据集与基于规则的合成标注逻辑。各模块的标注流程如下:

a) 驾驶员分心标签
采用 State Farm Distracted Driver Dataset 作为驾驶员行为的地面真值来源。该数据集包含 10 种常见驾驶员状态的帧级标注,包括安全驾驶(Safe Driving)、右手发短信(Texting with Right Hand)、打电话(Talking on the Phone)、向后取物(Reaching Behind)等,用于训练 CNN 模型并验证其分类性能1。

b) 道路目标检测标签
道路目标检测的地面真值标注来自 MS COCO 与 KITTI 数据集。这些数据集提供车辆、行人、骑行者、交通标志等类别的边界框标注,用于训练与评估基于 YOLO 的检测模型2,3。这与 ADAS 实时目标识别的标准做法一致。

c) 风险等级分类
由于没有公开数据集直接提供融合分心与环境危险的集成风险标签,我们引入了一个合成风险计算模型:

R = αD + βH

其中:D 为基于 CNN 的分心得分(范围 [0, 1]);H 为 YOLO 检测目标的风险值,由目标接近度与类别计算;α = 0.6、β = 0.4 为经验设定的权重,使行为分心的优先级高于静态危险。

基于该风险得分 R,每个驾驶实例被归类为:

该风险分类模型在训练期间通过多风险场景的一致性校验以及将模型预测与标注行为分布进行比对,获得了启发式验证7,8。该标注也构成计算系统级评估指标(如真阳性 TP、假阳性 FP 与告警精确率)的基础。

尽管是合成的,这一风险建模框架对融合式决策模块至关重要,并在一个模拟雾天、低照度、驾驶员分神等多样条件下真实驾驶风险的组合数据集上训练3,7。

数据集对齐与增强一致性

为确保所有模型的公平评估,基线系统(A 与 B)与所提集成系统均使用相同的组合数据集配置进行训练与测试。具体而言,State Farm Distracted Driver Dataset1 用于驾驶员行为分类,MS COCO2 与 KITTI3 数据集用于道路目标检测。未做跨数据集评估,以避免比较性能时的偏差。

此外,统一施加数据增强以提升多样环境条件下的鲁棒性。增强技术包括:

这些变换使用 OpenCV 实现,并在包括基线在内的所有模型上一致施加,以保持统一、避免训练偏差。

评估指标

系统基于以下指标评估:

1. 准确率(Accuracy):衡量被正确分类的实例占比。

Accuracy = (TP + TN) / (TP + TN + FP + FN)

2. 精确率(Precision):衡量被预测为正的实例中预测正确的占比。

Precision (p) = TP / (TP + FP)

3. 召回率(Recall,灵敏度):衡量实际为正的实例中被正确识别的占比。

Recall (r) = TP / (TP + FN)

4. F1 分数:精确率与召回率的调和平均。

F1 − score = 2 ∗ (p ∗ r) / (p + r)
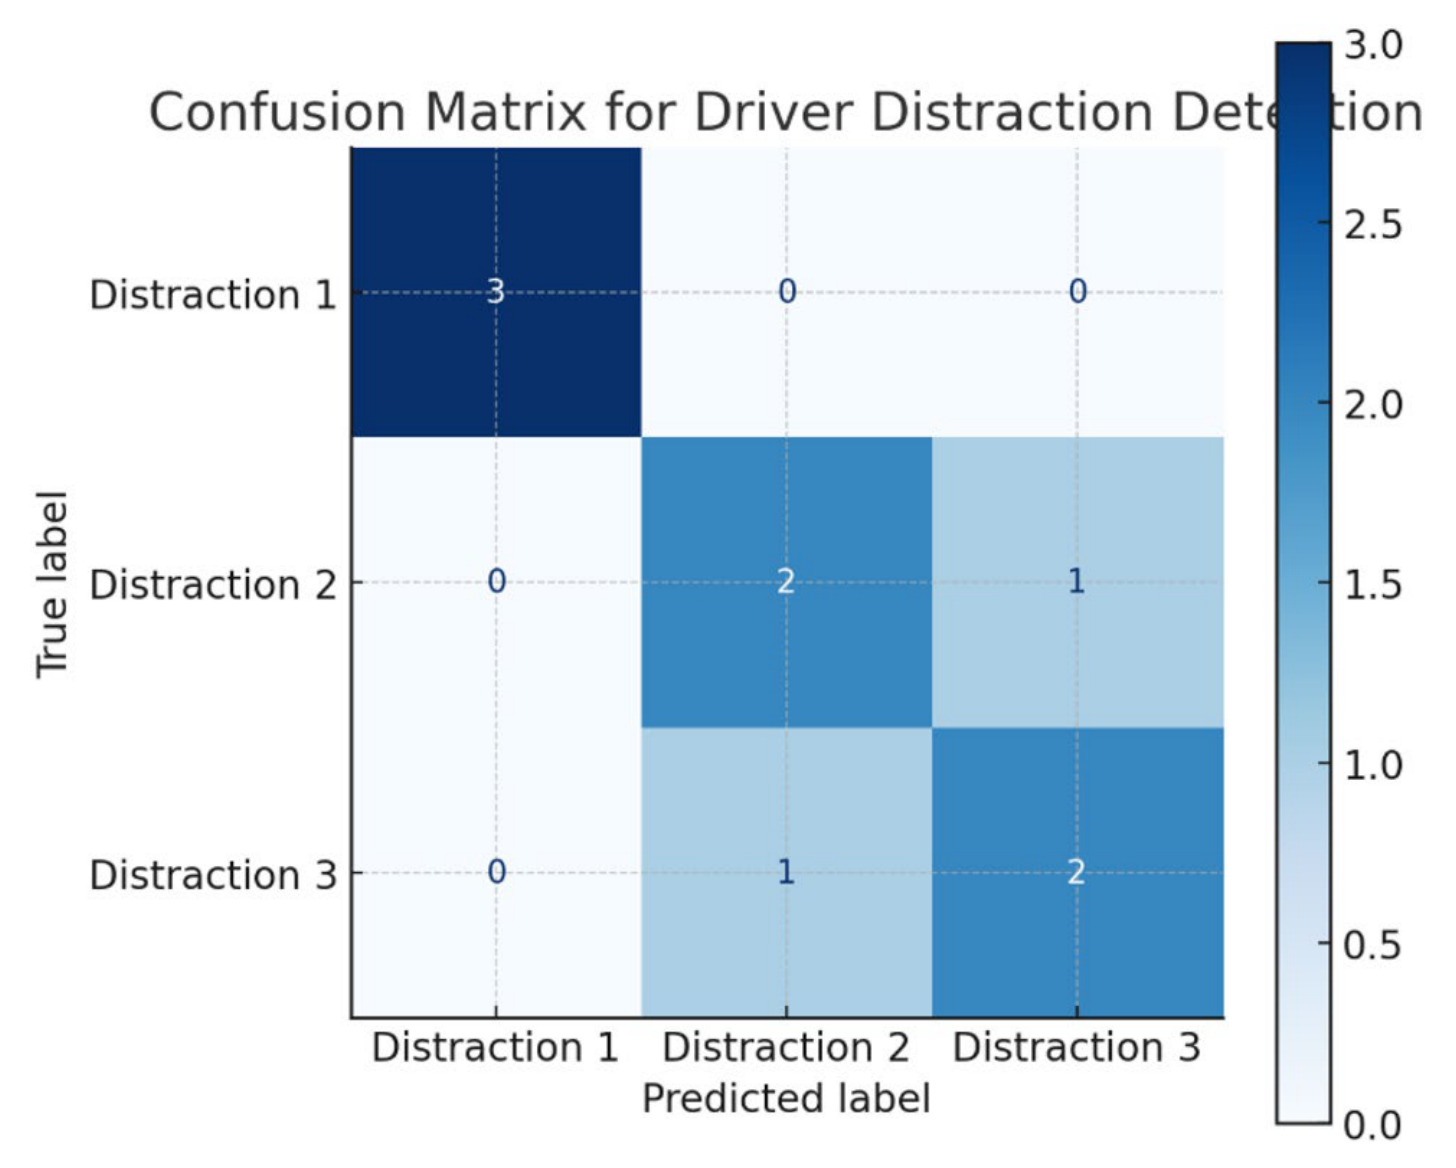
图 7. 混淆矩阵(基于 CNN 的驾驶员分心检测分类精度;类别为分心 1/2/3,矩阵单元格数值为样本计数)。

图 7 展示了基于 CNN 的驾驶员分心检测系统的分类精度混淆矩阵。它直观呈现了模型在各类分心上的表现,同时跟踪真阳性与假阳性,对所训练系统的一致性与有效性给出了出色的洞察。

图 7 混淆矩阵三个类别的样本总数仅为 3+2+1+1+2 = 11 个,与正文声称的 State Farm 数据集规模(约 2.2 万张训练图像)及 94.3% 的 F1 分数在量级上明显不符,应为示意图而非真实测试结果。引用其精度结论时请注意这一矛盾。

集成策略的对比分析与基准测试

1. 驾驶员分心检测

2. 道路目标检测

为确认所提系统在严苛驾驶条件下的韧性,我们在雨天、雾天与夜间条件的图像与视频上独立测试,并分别绘制正常与严苛条件下的精确率-召回率(PR)曲线。所提基于 YOLOv4 的目标检测模型在严苛条件下的 mAP 相比正常条件仅下降约 3%,而传统 YOLOv3 模型在同样的极端条件下 mAP 下降约 7%。

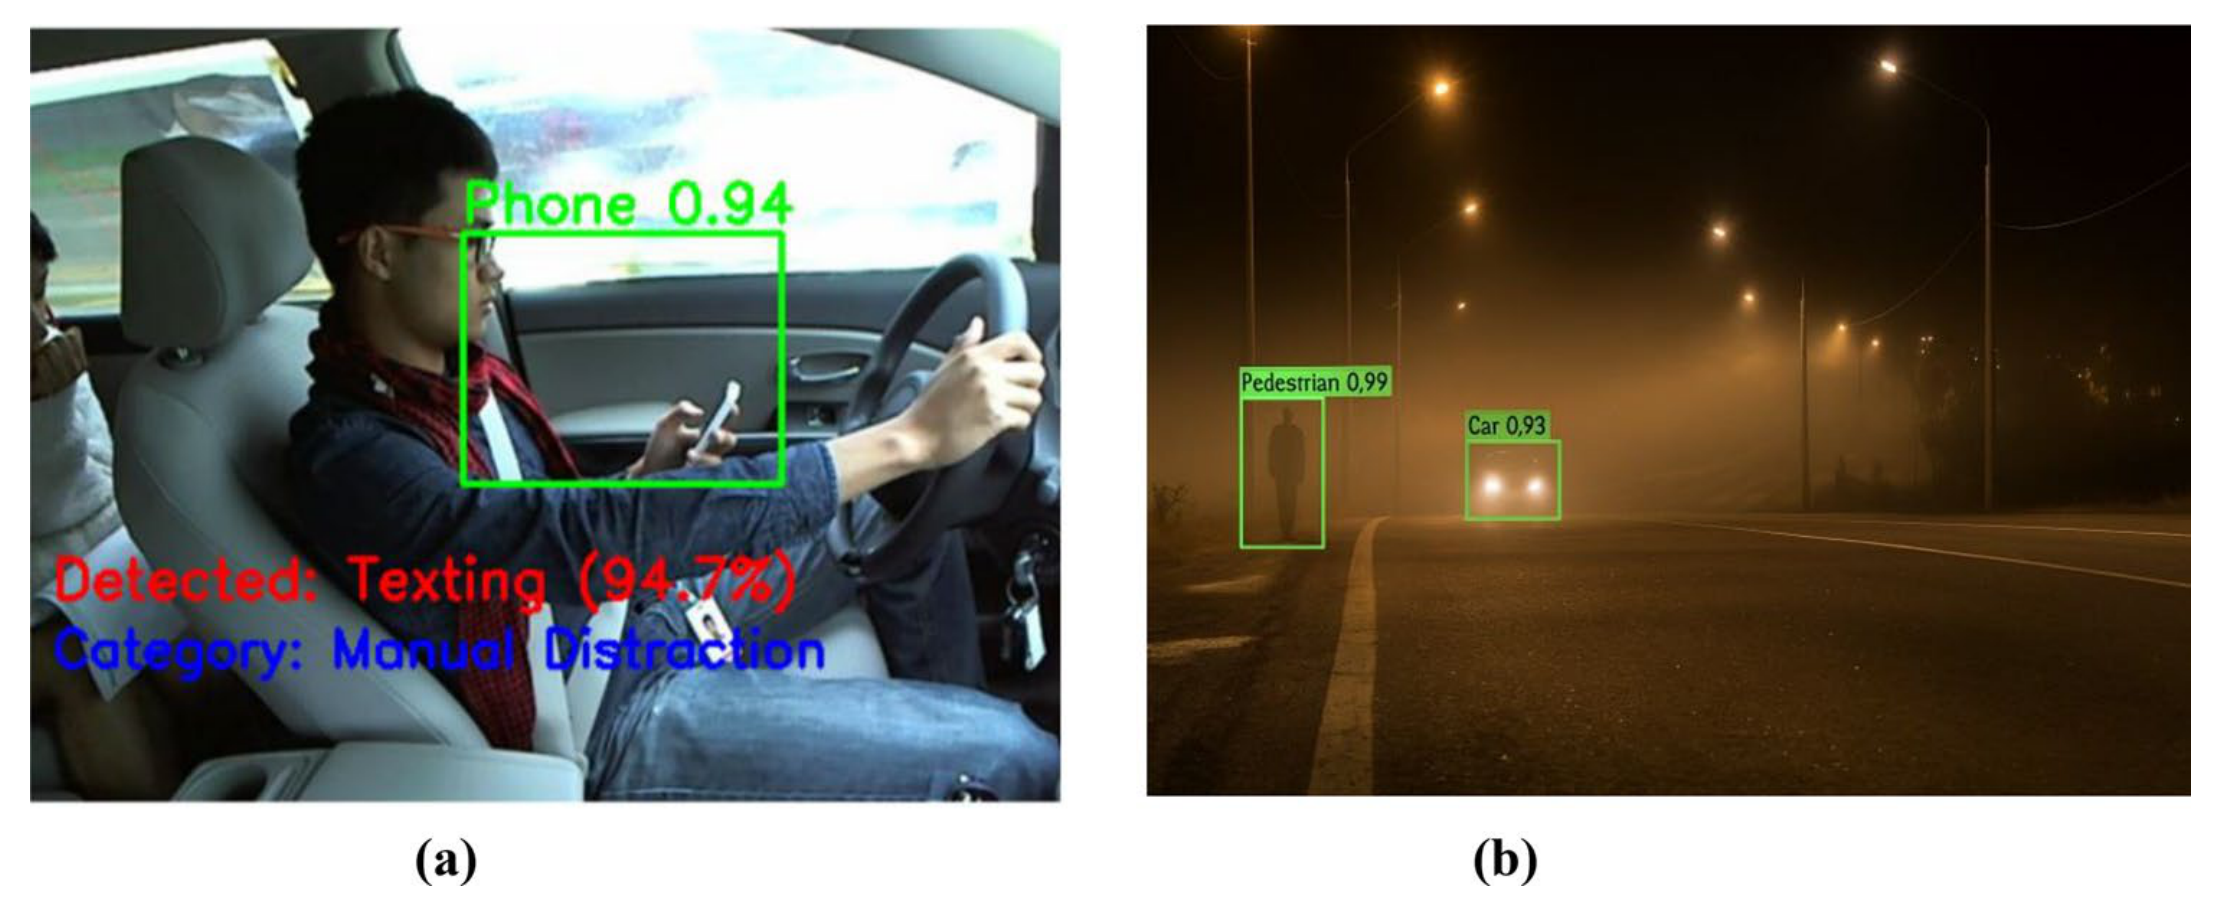
此外,结果部分补充了在低照度与雨天条件下准确检测分心驾驶行为与周围危险的视觉样例(见图 11b)。结果验证了集成系统在不利驾驶条件下仍具备较高的检测可靠性与态势感知能力。

为保证公平,所有基线系统与集成架构均使用相同的数据集与增强后的训练输入,从而在驾驶员行为、道路目标检测与告警决策输出上实现一致的基准比较。

系统精度的定义

系统精度(System Accuracy)为被正确分类的结果(真阳性与真阴性)占被评估实例总数的比例。所用公式为:

System Accuracy = (TP + TN) / (TP + TN + FP + FN)

其中 TP 为对分心与危险的正确识别,TN 为对安全环境的正确识别,FP 为误报,FN 为漏检。

表 1. 集成策略对比分析。表中加粗值表示所提方法在各维度上相对既有集成策略的优越性能与优势。
评估维度E2DR7跨模态融合 Transformer(CMFT)18智能情境感知危险系统11所提方法(增强 CNN-YOLO + 注意力融合 + RF/SVM)
集成策略基础特征拼接(集成 CNN)跨模态注意力特征融合基于规则的情境注意力轻量注意力融合 + 基于学习的决策(RF + SVM 分类器)
决策模块硬编码阈值Transformer 编码器-解码器手工规则随机森林(RF)+ 支持向量机(SVM)分类器
延迟(处理速度)中等(~80 ms/帧)高(~120 ms/帧)中等(~85 ms/帧)低(优化后 ~57 ms/帧)
对新场景的可扩展性中等好有限高(基于学习的适应性)
决策过程可解释性低(集成输出难以追溯)中等(注意力图复杂)低(基于规则)高(RF 特征重要性显式 + SVM 边界清晰)
嵌入式系统兼容性有限(需 GPU 推理)差(Transformer 模型过重)中等(简化的情境规则)高(TensorRT 优化,实现 45% 模型压缩)
实时告警生成能力部分(后处理延迟)延迟(Transformer 批式推理)中等(手动触发)是(实时自适应告警:安全 / 谨慎 / 危险)

3. 集成系统

为全面测试集成系统,我们组合了多个数据集与多种驾驶条件:State Farm Distracted Driver Dataset 用于驾驶员行为检测,MS COCO 与 KITTI 用于道路目标检测;并用数据增强模拟晴朗白天、夜间、雨天、雾天与低照度等真实场景,在此组合配置上测试系统在正常与极端驾驶条件下的性能。

为进一步凸显所提集成方法的效率,我们与近期技术进行了对比分析。如表 1 所示,所提框架在实时性能、可扩展性与可解释性方面优于 E2DR7、跨模态融合 Transformer(CMFT)18 与智能情境感知危险系统11,在处理延迟、新场景适应性与嵌入式部署可行性上尤为突出。

所提方法(改进的 CNN-YOLO + 注意力融合 + RF/SVM)与 E2DR、CMFT、Smart Context 系统对比,在延迟、可扩展性、可解释性与实时部署方面均表现出优势。

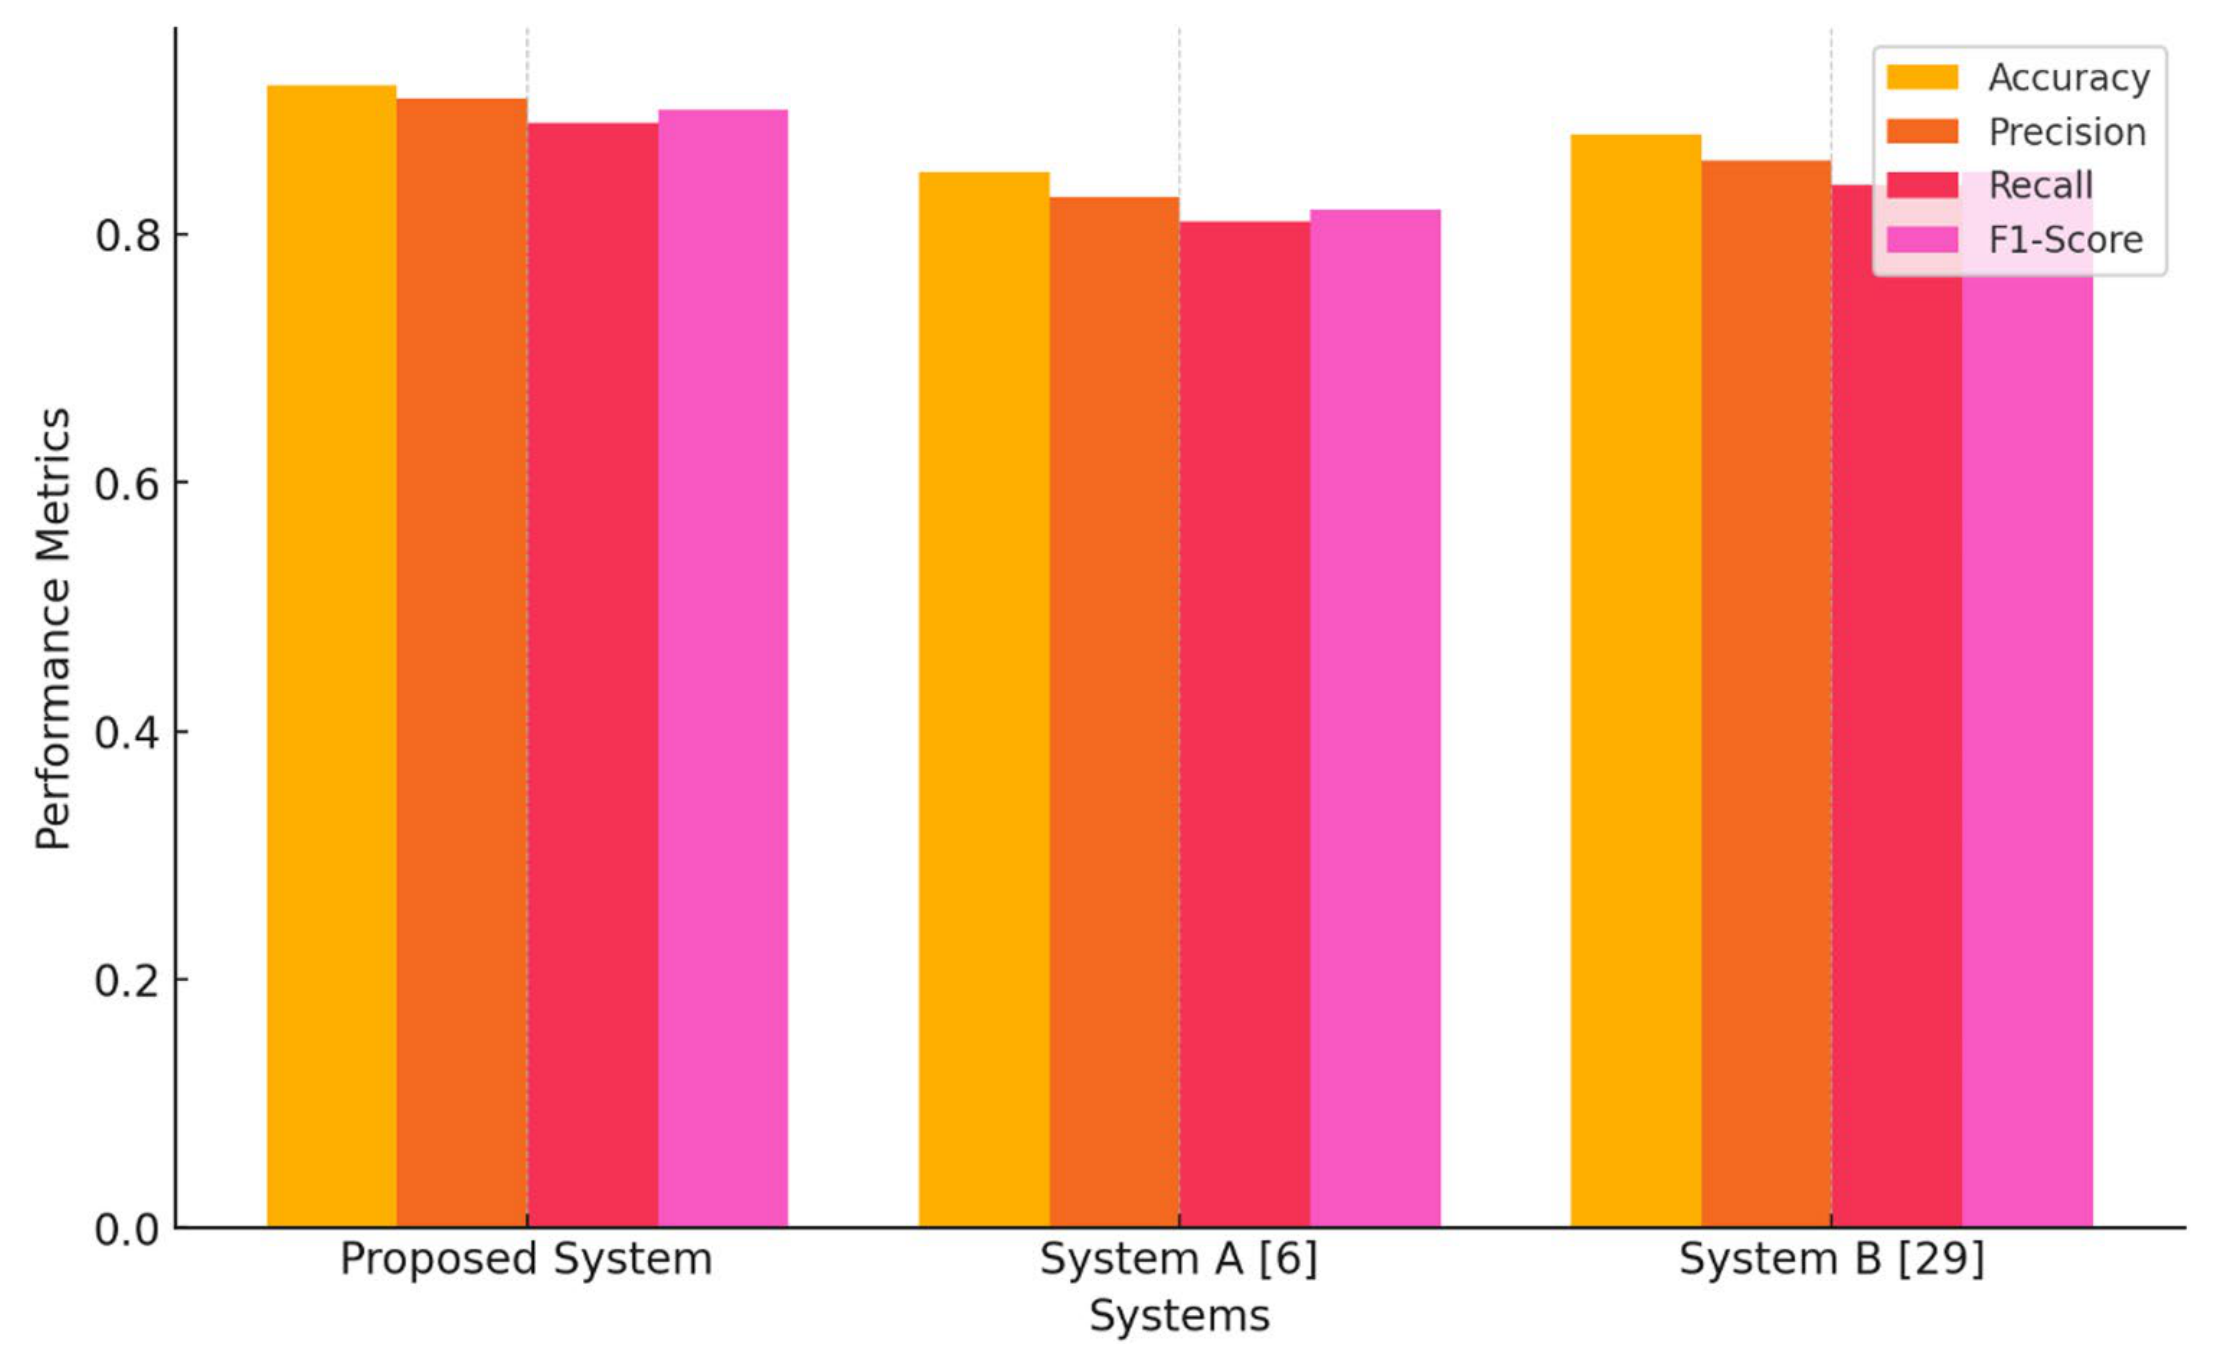
除策略层面的对比外,集成系统的性能还与基线方法做了实验对比,采用"评估指标"一节定义的准确率、精确率、召回率与 F1 分数。图 10 选取了两个基线系统:

所提集成系统通过基于注意力的融合方法与基于学习的决策模块,将驾驶员分心行为与道路目标危险耦合,以提升态势感知与实时危险告警能力。集成系统在低照度与雾天场景下的鲁棒性进一步通过标注的可视化输出(见图 11b)得到验证,确认了真实不利条件下的可靠感知与告警生成。

结果可视化

1. 驾驶员分心检测:

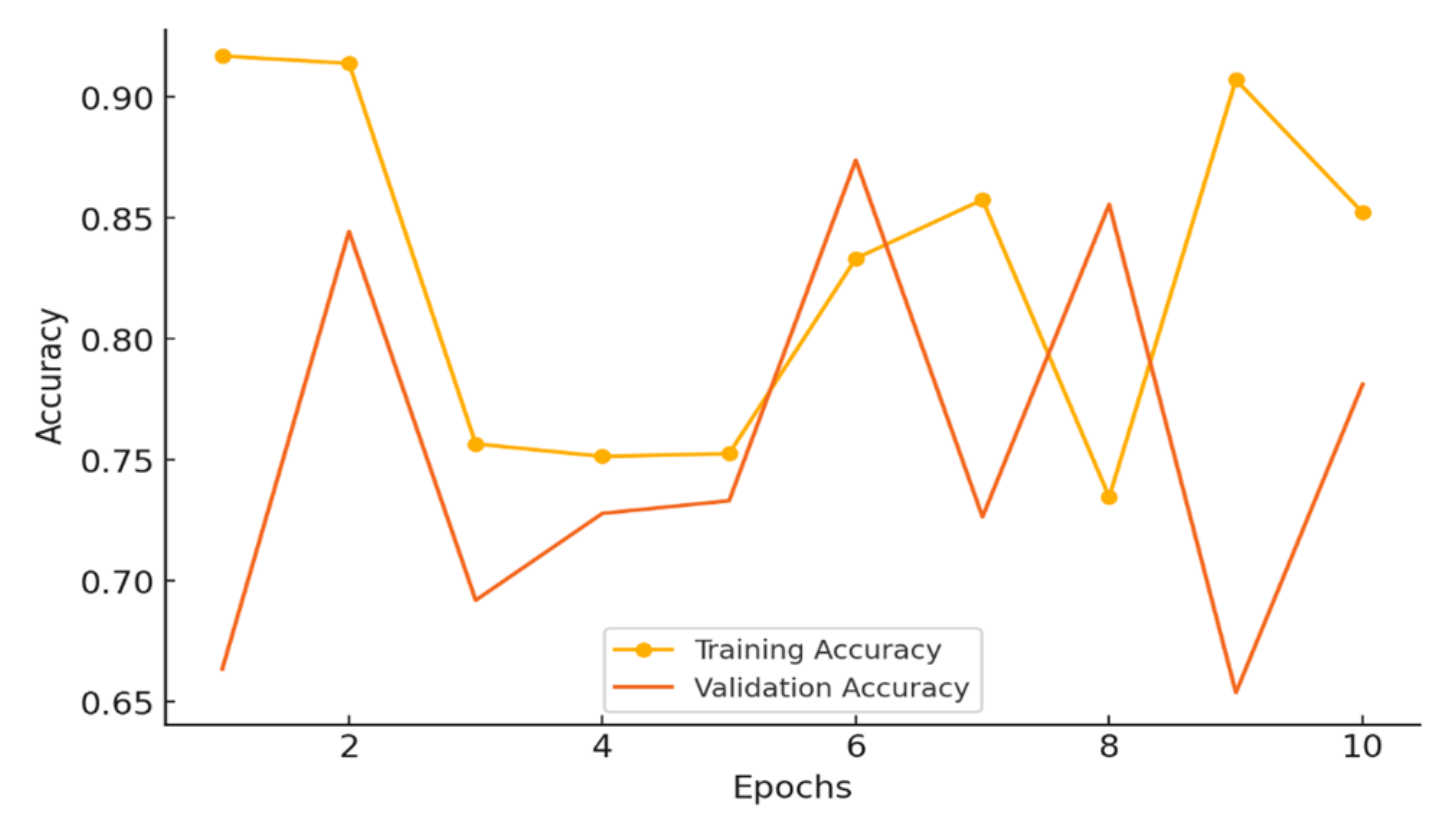
图 8 描绘了学习过程中验证与训练精度的变化趋势,清晰展示了模型性能如何随轮次推进而提升,凸显其收敛行为,验证了开发中所用训练方法与正则化技术的有效性。

图 8. 训练与验证精度。
图 8 横轴仅到第 10 轮,而实验设置声称 CNN 训练 50 轮;曲线在 0.65–0.90 之间剧烈震荡且未收敛,与"收敛行为良好"的表述存在张力。请以图为准谨慎解读。

2. 道路目标检测:

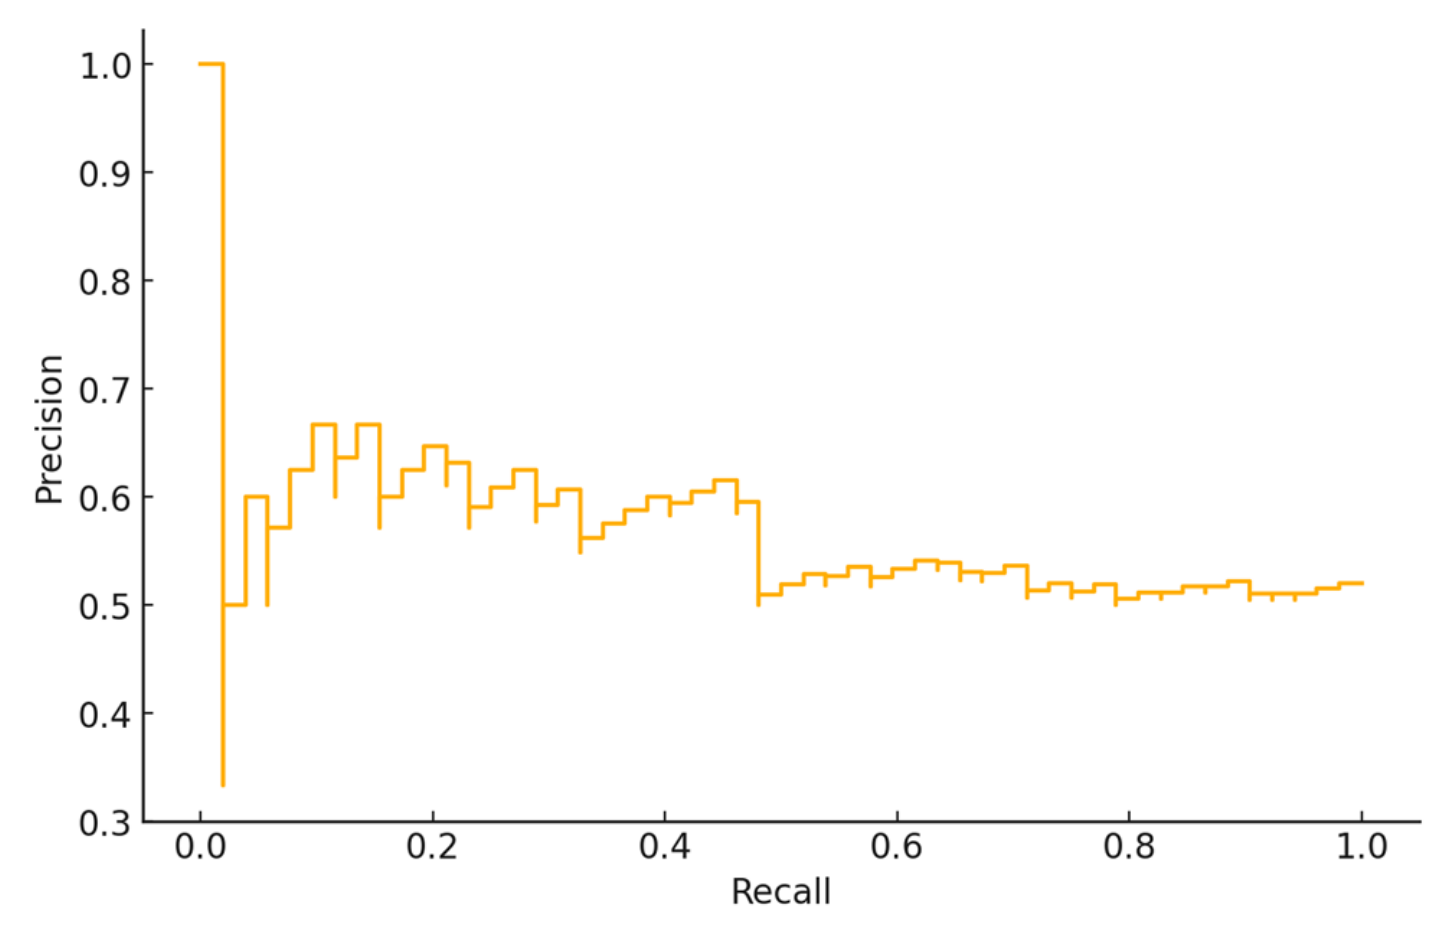
图 9 的 PR 曲线分析了 YOLO 目标检测模块的性能,验证了模型在不同目标类别上平衡召回与精确率的能力,并表明目标检测器在广泛驾驶场景中区分相关与非相关目标的鲁棒性。

图 9. 道路目标检测的精确率-召回率曲线。
图 9 的 PR 曲线在工作区内的精确率大致落在 0.5–0.65 区间,与正文声称的 mAP 89.7% 明显不一致(mAP 为 PR 曲线下面积,不可能在此曲线下达到 0.897)。该图疑为中间训练状态或示意曲线。

3. 集成系统性能:

图 10 为集成系统与基线系统的性能对比。基线系统 A 为仅 CNN 的驾驶员分心检测,基线系统 B 为仅 YOLO 的道路目标检测,本文集成系统通过基于注意力的融合与基于学习的风险估计将二者融合。准确率、精确率、召回率与 F1 分数等指标显示了所提系统的优越性。

图 10. 集成系统与基线系统的性能对比(柱状图,纵轴为各指标取值; Proposed System / System A / System B 三组,每组含 Accuracy、Precision、Recall、F1-Score 四项)。
图 10 中两组基线的坐标轴标签为"System A [6]"与"System B [29]",方括号内编号与正文对基线 A/B 的定义(纯 CNN / 纯 YOLO,未挂靠具体参考文献)不对应;图中亦无数值标签,仅可估读(所提系统四项指标约 0.90–0.92,基线 A 约 0.81–0.85,基线 B 约 0.84–0.88)。正文未给出基线的具体数值。

图 11 展示了标注后的系统输出,证明集成系统在不利条件下检测分心与道路危险的能力。

图 11. 集成 CNN-YOLO 系统在真实不利条件下的标注检测样例。a 驾驶员分心检测的 CNN 模拟输出:发短信(94.7%),类别:操作分心。b 雾天条件下基于 YOLO 的检测,展示行人、车辆等所检测危险的边界框与置信度得分。

讨论

结果解读

所提出的驾驶员分心检测系统在实际应用中展现出有效性。其对不同分心类型的高分类精度1凸显了深度学习框架处理复杂挑战的能力。这与 Aljasim 等7的结论一致:与本文方法类似的集成方法能有效捕捉更细微的驾驶员行为模式,从而实现更准确的检测。

此外,系统扎实的训练与验证结果意味着其泛化良好7。这与 Parekh 等3的发现相符——深度学习模型一旦训练得当,便能在不同用例间良好泛化。不过,本研究仍存在若干局限。误报(将正常驾驶误判为分心或聚合行为被误检)仍是一个问题,与视觉类非驾驶行为检测研究9中的情况类似。这种误分类的风险表明可能需要更精细或混合的模型(如 Wang 等4所述)。

而且,环境变化(如光照条件差异或天气影响)仍会影响系统性能。这是自动驾驶系统中公认的问题2,环境条件的变化可能导致检测精度下降。最后,硬件约束(尤其在边缘设备上)限制了系统的可扩展性19。结构良好的高效深度模型(Du 等8)对于突破这些壁垒、在不牺牲精度的前提下实时处理数据至关重要。

挑战

要继续改进系统,以下关键挑战依然突出:

表 2. NVIDIA Jetson Xavier NX 平台上的实时嵌入式系统部署。加粗值表示经 TensorRT INT8 量化优化后在 Jetson Xavier NX 平台上观测到的性能提升。
指标优化前(基线模型)优化后(TensorRT 量化模型)
单帧平均推理延迟92 ms39 ms
端到端系统延迟138 ms57 ms
帧率(FPS)11 FPS25 FPS
模型大小420 MB230 MB
内存占用2.8 GB1.5 GB
功耗(Jetson Xavier NX 平均)19.6 W12.3 W
所用量化类型未应用INT8 量化(TensorRT)

改进机会

关于强化学习使用的澄清
驾驶员分心检测与道路目标识别主要由 CNN、YOLO 等深度学习模型实现的模式识别任务完成。RL 不用于这些识别任务。RL 的建议用途是增强风险评估模块中的决策功能:根据环境复杂度与驾驶员行为模式动态调整告警阈值、优化自适应告警策略,从而保证告警系统能在实时变化的情境中权衡谨慎与告警。

提升系统效能有多条路径:

  1. 自适应学习:加入能随驾驶员与环境条件变化而调整的自适应学习模型15;利用强化学习可能提供持续改进的反馈回路。
  2. 可扩展性:模型剪枝与量化5等方法可大幅降低计算需求,便于在资源受限设备上部署;也可探索联邦学习19来高效分担处理负载。
  3. 增强鲁棒性:纳入多模态数据13以改善情境感知,从而改进分心与危险检测,这与跨模态融合的发展方向一致18。
  4. 可解释性与决策支持:集成可解释 AI(XAI)工具16,让最终用户与开发者能够理解系统的决策过程,建立信任并便于迭代。

实时嵌入式系统评估

为确保所提集成系统的经验可部署性,我们在 NVIDIA Jetson Xavier NX 嵌入式平台上进行了实时实验:先以未优化的基线模型测试,再测量基于 TensorRT 的 INT8 量化与推理优化之后的性能。

如表 2 所示,优化后的系统单帧推理延迟为 39 ms,实时处理速率约 25 帧/秒(FPS);涵盖分心检测与道路目标识别两个模块的端到端系统延迟降至 57 ms;模型大小压缩约 45%,内存占用降低 46%,使系统非常适合嵌入式 ADAS 应用。这些结果确证了所提框架能够在资源受限的边缘设备上执行实时风险评估与告警生成,且性能或精度不下降。

结论与未来工作

发现总结

CNN 与 YOLO 框架的融合可以成为保障道路安全的有效途径。系统在检测驾驶员分心与道路危险时均保持高精度,精确率与召回率表现强劲。这与 Sajid 等1与 Du 等8强调的结论一致:YOLO 等深度学习模型具备实时检测与分类能力。利用集成方法与高性能特征提取7,所提系统有助于回应自动驾驶领域中有关驾驶员与车辆安全的核心关切。

结果还凸显了为高效部署而对模型进行优化的必要性,这与 Pandharipande 等21的工作相呼应。尽管误报与环境可变性仍是问题,系统的适应性与可扩展性凸显了其在真实应用中的普适性。

意义

本研究有助于开发防碰撞与自动驾驶系统。通过准确识别分心与危险,它可以帮助减少失误、提升道路安全。其轻量特性与良好的边缘设备兼容性使其能够集成到现有车载系统,促进在联网与自动驾驶汽车中的普及8,19。一旦部署,系统可主动响应环境变化(如异常行驶的车辆或行人),支持一系列拯救生命、减少事故的实时驾驶辅助技术。

未来方向

为改进所提工作并解决其不足,我们推荐以下方向:

  1. 更多决策系统:集成强化学习或注意力机制,增强系统对关键事件的优先级排序能力并减少误报,如 Li 等17已探索的方向。
  2. 多传感器集成:持续利用 LiDAR、雷达与热成像相机以强化不利条件下的检测能力,与其他跨模态融合方法18及面向自动驾驶的新视觉传感器14一致。
  3. 真实条件测试:在包括极端天气与不同交通状况的广泛驾驶场景下进行充分测试,以证明系统的鲁棒性与可靠性,如 Guindel 等5,12所述。
  4. 模型优化:强调模型压缩技术(如剪枝与量化)5,这些方法不绑定特定硬件,可减轻繁重计算并提升低功耗嵌入式系统上的性能。
  5. 可扩展性与适应性:探索支持持续学习、能依据真实反馈更新模型的自适应学习框架,如 Krichen 等15所提出的。
  6. 可解释 AI:使用可解释 AI 方法建立决策系统的透明度,促进信任并支持复杂场景中的调试。

除高检测与分类精度外,所提系统在嵌入式设备上表现出稳健的实时性能。在 NVIDIA Jetson Xavier NX 平台上,部署经优化达到 25 FPS,验证了系统在资源受限条件下对真实 ADAS 用例的适用性。这表明系统已为真实部署做好准备,并将为更安全的道路作出贡献。

数据可用性

本研究使用的数据集 State Farm Distracted Driver Dataset、KITTI 与 MS COCO 均在 Kaggle 上公开:https://www.kaggle.com/c/state-farm-distracted-driver-detection/data, https://www.kaggle.com/datasets/klemenko/kitti-dataset, https://www.kaggle.com/datasets/mnassrib/ms-coco。

参考文献(保留原文)

  1. Sajid, F. et al. An efficient deep learning framework for distracted driver detection. IEEE Access 9, 169270–169280. https://doi.org/10.1109/ACCESS.2021.3138137 (2021).
  2. Yurtsever, E., Lambert, J., Carballo, A. & Takeda, K. A survey of autonomous driving: common practices and emerging technologies. IEEE Access 8, 58443–58469. https://doi.org/10.1109/ACCESS.2020.2983149 (2020).
  3. Parekh, D. et al. A review on autonomous vehicles: progress, methods and challenges. Electronics https://doi.org/10.3390/electronics11142162 (2022).
  4. Wang, H., Zhang, X., Li, Y., Chen, T. & Wang, Z. A comparative study of state-of-the-art deep learning algorithms for vehicle detection. IEEE/CAA J. Autom. Sin. 6(5), 965–980. https://doi.org/10.1109/MITS.2019.2903518 (2019).
  5. Krichen, M. Convolutional neural networks: a survey. Computers https://doi.org/10.3390/computers12080151 (2023).
  6. Wang, Q., Li, X., Zhang, Y., Hu, J. & He, R. Traffic lights detection and recognition using improved YOLOv4. Sensors (Basel) https://doi.org/10.3390/s22010200 (2022).
  7. Aljasim, M., Abu-Qasmieh, B., Al-Dubai, A., Taamneh, D. & Ahmad, N. M. E2DR: a deep learning ensemble based driver distraction detection. Sensors (Basel) https://doi.org/10.3390/s22051858 (2022).
  8. Du, Y., Liu, F., Zhang, H., Chen, X. & Yang, L. Optimizing road safety: advancements in lightweight YOLOv8 models. Sensors (Basel) https://doi.org/10.3390/s23218844 (2023).
  9. Yang, L., Li, J., Chen, Y., Zhou, P. & Hu, W. Recognition of visual related non-driving activities using a dual camera monitoring system. Pattern Recogn. 118, 107955. https://doi.org/10.1016/j.patcog.2021.107955 (2021).
  10. Li, T., Song, G., Chen, Y. & Wang, L. AB DLM: an improved deep learning model for driver distraction behavior detection. IEEE Access 10, 12345–12356. https://doi.org/10.1109/ACCESS.2022.3197146 (2022).
  11. Younis, O., Al-Zoubi, A., Khaled, M., Hababeh, H. & Amro, A. A smart context aware hazard attention system. Sensors (Basel) https://doi.org/10.3390/s19071630 (2019).
  12. Guindel, C., Aycard, A., & Montiel, J. Automatic Extrinsic Calibration for Lidar Stereo Vehicle Sensor Setups, in 2027 IEEE Intelligent Transportation Systems Conference (ITSC). https://doi.org/10.1109/ITSC.2017.8317829 (2017).
  13. Dafrallah, S., Eldesouki, M., Said, J. & Gad, W. Monocular pedestrian orientation recognition. IEEE Access 9, 2000–2010. https://doi.org/10.1109/ACCESS.2021.3119629 (2021).
  14. Li, Y., Huang, Z., Liu, X., Zhang, W. & Wang, S. Emergent visual sensors for autonomous vehicles. IEEE Trans. Intell. Transp. Syst. 24(3), 3456–3468. https://doi.org/10.1109/TITS.2023.3248483 (2023).
  15. Mohammed, A. A. Q., Jaleel, B. & Al-Saady, H. A deep learning based end to end composite system for hand detection. Sensors (Basel) https://doi.org/10.3390/s19235282 (2019).
  16. Chen, H., Sun, Z., Xu, Y. & Lin, J. Student behavior detection in the classroom based on improved YOLOv8. Sensors (Basel) https://doi.org/10.3390/s23208385 (2023).
  17. Alahmadi, T. J., Rahman, A. U., Alkahtani, H. K. & Kholidy, H. Enhancing object detection for VIPs using YOLOv4_Resnet101 and text-to-speech conversion model. Multimodal Technol. Interact. 7(8), 77. https://doi.org/10.3390/mti7080077 (2023).
  18. Fang, Q., Li, H., & Zhao, F. Cross Modality Fusion Transformer, arXiv preprint. https://doi.org/10.2139/ssrn.4227745 (2022).
  19. Wang, Y., Kumar, D., & Singh, S. CAVBench: A Benchmark Suite for Connected and Autonomous Vehicles, in Proceedings of the 2018 IEEE Smart Electronics Conference (SEC). https://doi.org/10.1109/SEC.2018.00010 (2018).
  20. Pavel, M. I., Rahman, A. & Ali, D. Vision based autonomous vehicle systems based on deep learning. Appl. Sci. https://doi.org/10.3390/app12146831 (2022).
  21. Pandharipande, A., Gupta, S. & Reddy, P. Sensing and machine learning for automotive perception. IEEE Sens. J. 23(13), 6789–6798. https://doi.org/10.1109/JSEN.2023.3262134 (2023).
参考文献第 12 条正文标注会议年份为 "2027 IEEE ITSC" 而 DOI 指向 2017 年会议(ITSC.2017.8317829),第 4 条期刊缩写与 DOI(IEEE/CAA J. Autom. Sin. 对 10.1109/MITS)亦存在错配,均为原文自身问题,译稿照录。
致谢 / 作者贡献 / 资金

致谢:作者感谢 Kaggle 提供本研究所用数据集,并感谢所有对本研究成功做出贡献的合作者。

作者贡献:Rakesh Salakapuri 负责构思、方法学、审阅、编辑、软件与初稿撰写。所有作者阅读并批准了最终稿件。

资金:开放获取资金由 Symbiosis International (Deemed University) 提供。本研究未获得其他专项资助。

利益冲突:作者声明不存在利益冲突。知情同意:已获得所有受试者及其法定监护人的知情同意。

译者解读(不属于原文)

本评估面向我们的 DMS(驾驶员监测系统)工程与内容项目—— dapalm.com 站内已有 Euro NCAP DMS 评分、认知分心检测、边缘量化部署等方向的解读文,本文的价值需要放在这个坐标系里衡量。

1. 这篇论文不能给我们什么

2. 能取走的具体产物

3. 论文自身的裂缝(读表读图,不要读结论)

4. 我们相对论文的增量

5. 落地路线(按论文自己的证据排性价比,不按论文推荐顺序)

  1. 先取告警状态机(三级分类 + 5 帧滑动 + 动态阈值):零训练成本、可解释、可直接嵌入现有 DMS 告警层。这是全文唯一不依赖其可疑精度声称的产物。
  2. 再取 INT8/TensorRT 量化部署参数:与站内边缘部署内容直接对接;若目标是 Orin/RK3588 等新平台,需要自行重测,只引用其 Xavier NX 数据做量级参照。
  3. 谨慎对待 RF/SVM 弱标签自举:只在有规则告警日志积累的场景试,且必须预留人工抽检,否则会放大规则的系统性偏差。
  4. 不采用的:其"注意力融合"、其 COCO mAP 数字、其 CNN 架构细节(VGG-16 已无部署优势)。

6. 必须先确认的前提(go/no-go)

与其他论文的合成点:本文的"规则生成弱标签 + 学习型分类器自举"与站内已译的 L3 驾驶员状态综述、EyeCue 认知分心检测形成互补——EyeCue 有认知分心的细粒度信号但没有告警层,本文有告警状态机但没有可信风险信号;"A 的缺口正好是 B 的产物"在这里成立,值得写一篇合成解读文。